Rapid-MLX 0.16.0 更新:Mac 本機模型加速,先看實驗設定再看倍數
Rapid-MLX 0.16.0 為部分 Mac 本機模型加入實驗性 TensorFold 設定,也更新多模態與快取行為。本文解釋官方倍速的適用範圍,以及實際驗證時應記錄的條件。

在 Mac 上跑模型,慢的原因可能出在模型,也可能出在執行方式。
Rapid-MLX 的 0.16.0 更新,把重點放在部分模型的加速設定與服務穩定性。
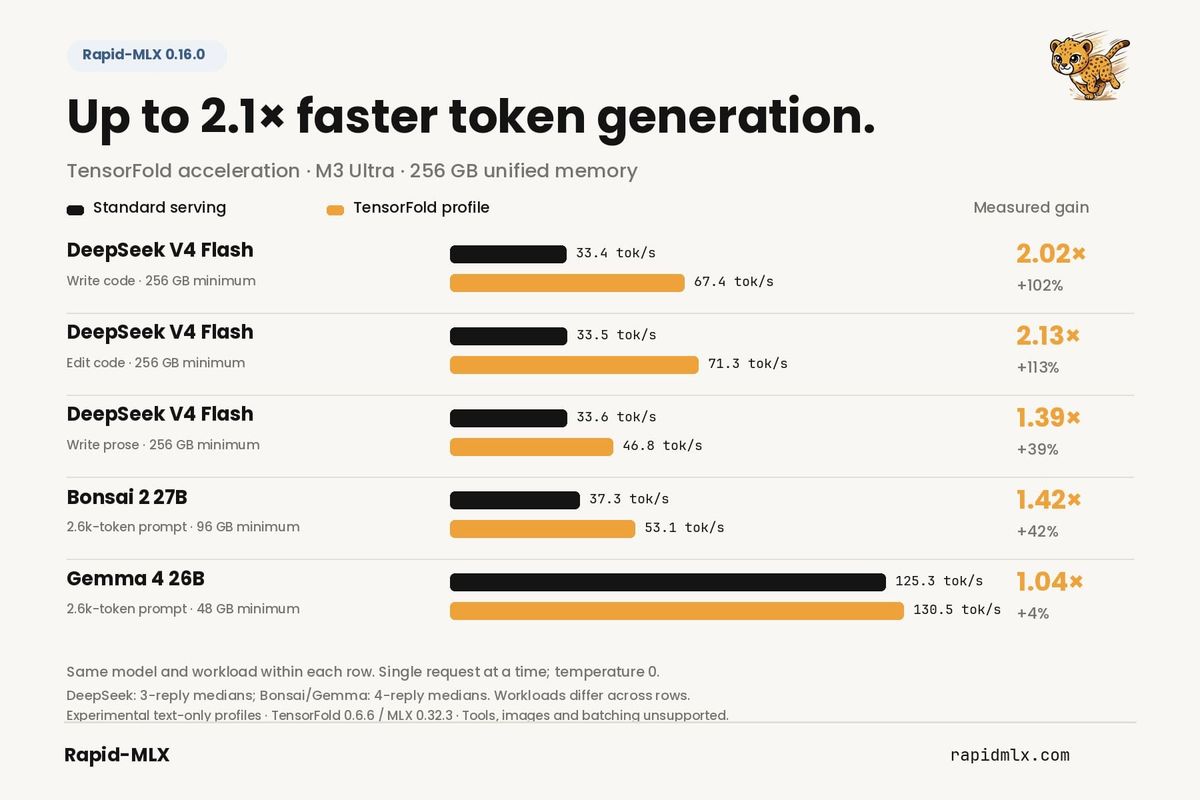
專案在 10 月 9 日分享 DeepSeek V4 Flash 等模型的效能數字。
發布說明同時把這些 TensorFold 設定列為實驗性功能,保留模型、硬體與能力限制。
因此,這次更新值得關注,但不宜把單一倍速套到所有 Mac 與任務。
先看自己的工作負載是否相符,再談加速幅度,才能做出有用的比較。
TensorFold 設定,先確認適用模型
加速設定可以理解為針對特定模型與環境調整的執行方式。
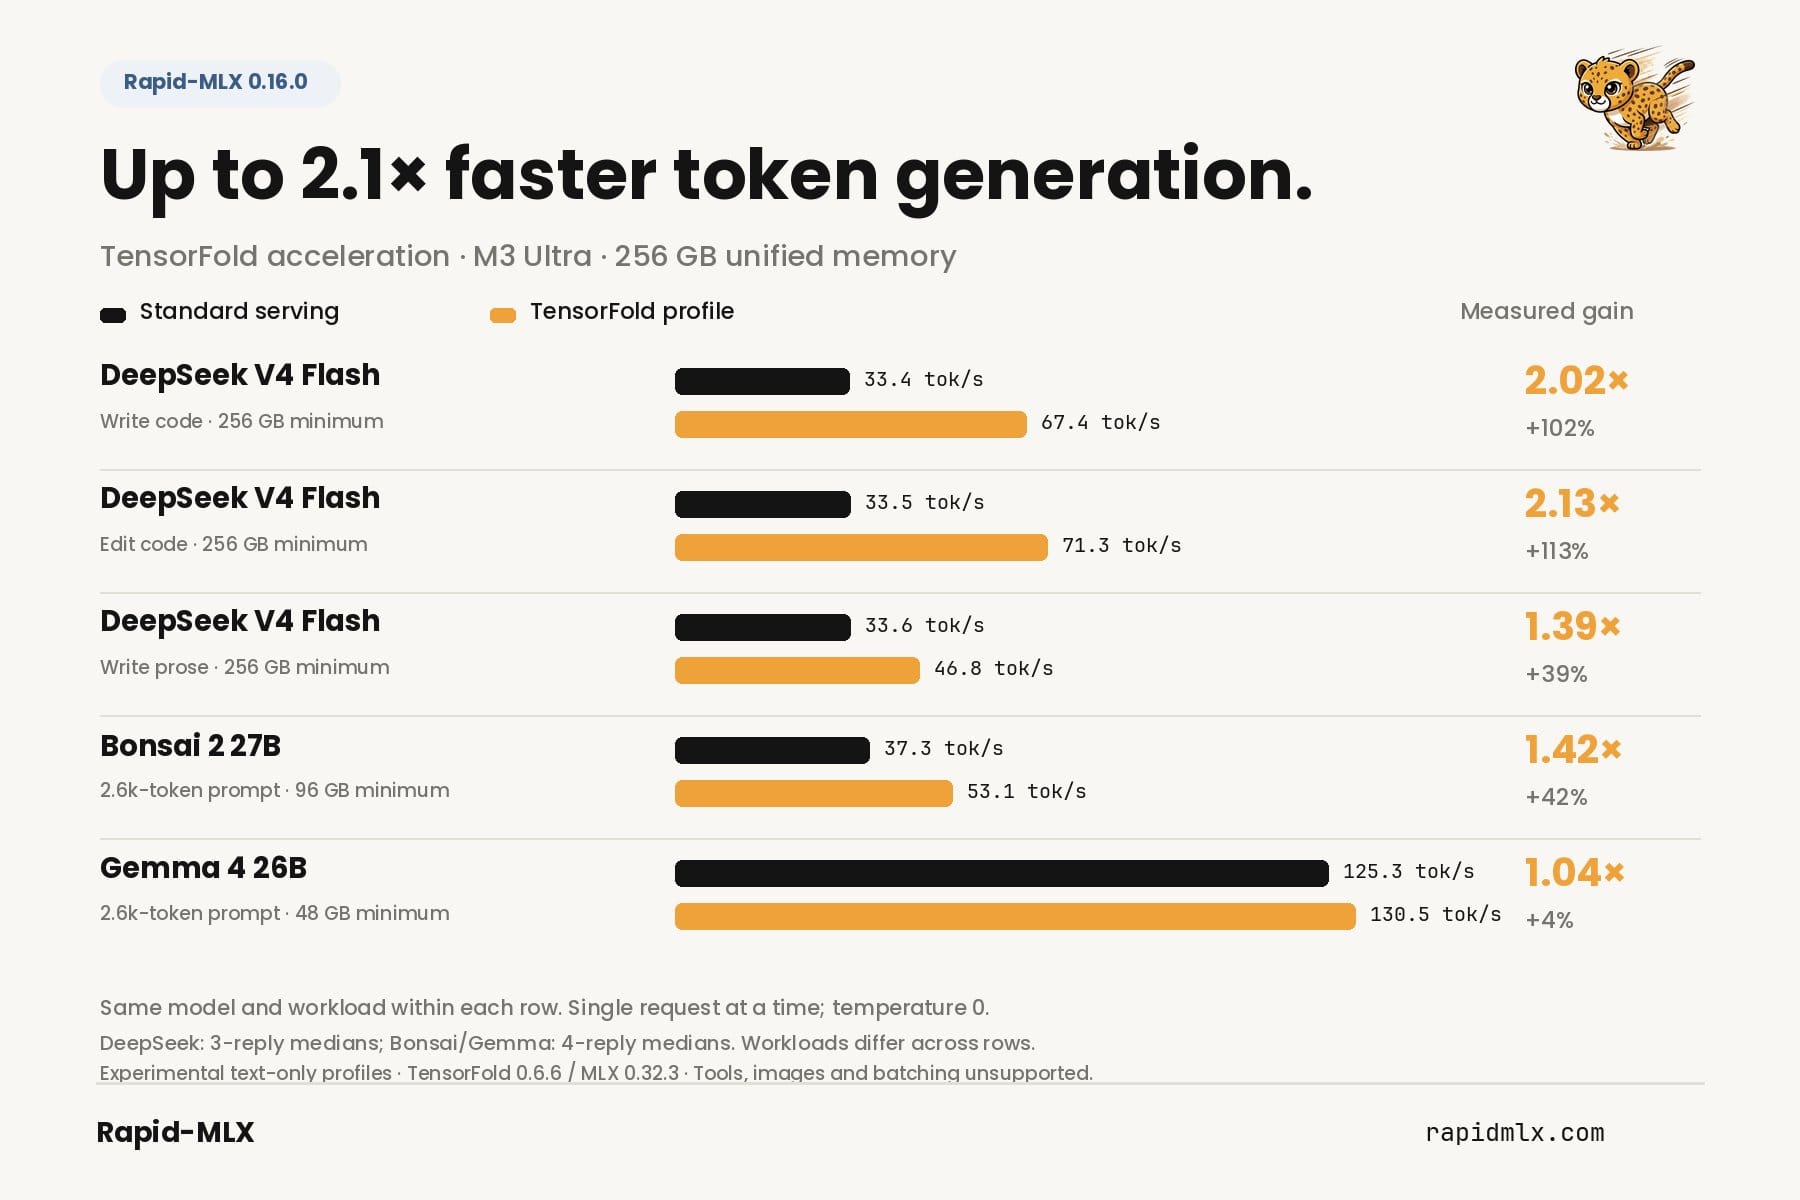
0.16.0 的發布說明列出 Bonsai 2 27B、Gemma 4 26B 與 DeepSeek V4 Flash 等實驗性設定。
官方貼文宣稱,部分測試的吞吐量有明顯提升。吞吐量指的是一段時間能處理多少輸出,和第一個字多久出現是不同指標。
貼文列出 DeepSeek V4 Flash 吞吐量最高 2.1 倍、Bonsai 2 27B 增加 42%、Gemma 4 26B 增加 4%。
這些是專案測試宣稱,適用條件仍受各設定的硬體與能力限制。
發布文件提醒,設定會檢查支援的模型、執行環境、硬體與功能條件。不符合時可能拒絕處理。
這種限制很重要,因為一般文字對話、工具呼叫與圖片輸入,不一定走同一種執行路徑。
升級前應確認需要的功能在相容範圍內,而不是只看模型名稱出現在清單。
比較效能,至少把條件固定下來
一個可用的速度比較,應讓版本、模型與測試資料保持一致。
例如先保存相同的模型權重、量化方式、提示長度與輸出長度,再比較升級前後的結果。
Mac 型號、可用記憶體與同時執行的工作,也會影響測量。背景下載或另一個模型佔用資源,會讓比較變得失真。
對互動工具而言,要看第一個字的等待時間。對批次工作而言,則需要看整批任務完成多久。
多輪對話還應檢查後續回應是否接得上前文。快速輸出錯誤內容,無法帶來同等的實務價值。
這些條件有記錄,團隊才知道自己得到的改善是否能重現。
更新也處理快取與串流的正確性
這次發布不只追求速度,也修整共享前文、多輪對話與串流行為。
快取是把已處理過的資料保存起來,讓相同前文不必每次重算。但快取邊界若錯了,也可能影響後續內容。
發布說明提到對話邊界與串流工具參數的修正,重點包括正確性與等待體驗。
當一個請求處理很長的前文時,其他串流回應也要有機會繼續傳出內容,避免長時間被擋住。
因此,驗證時可以加入第二輪追問、相同前文的不同問題,以及帶有工具參數的請求。
如果升級後出現回應格式改變,要先查看支援協定與錯誤類型,避免把服務不相容當成模型能力下降。
對正式流程而言,穩定處理錯誤與保持內容一致,通常和平均速度一樣重要。
本機執行,也要看模型權重的授權
程式可以在本機運作,並不表示所有模型都可商用。
這次發布提到 OpenJev 權重採 CC BY-NC 4.0,限制非商業用途。其他模型也有自己的授權條件。
企業或接案者應把執行工具授權、模型權重授權與素材用途分開確認。
自動下載模型的控制,也不等於整個系統完全離線。發布說明指出,部分檢查仍可能查詢外部儲存庫資料。
若目標是離線工作,應先完成模型與依賴準備,再確認實際網路行為,而不是只關掉一個下載選項。
這些條件都符合後,才適合把實驗性設定加入經常使用的工作流程。
常見問題
DeepSeek 的倍速代表所有模型都更快嗎?
不代表。官方數字對應特定模型與設定,其他工作負載需要自行比較。
支援圖片與影片,表示每個模型都能用嗎?
不表示。執行環境包含相關依賴,和個別模型或加速設定支援哪些能力,是不同事情。
本機模型一定可以商用嗎?
不一定。必須查看每個模型的權重授權,不能用執行位置推定使用權利。
結語
Rapid-MLX 0.16.0 帶來值得試驗的加速設定,也提醒使用者把測試條件與功能正確性一起衡量。先用固定資料測一輪,再決定是否加入日常流程,會比直接追逐倍速更可靠。
延伸閱讀:Atomic Agent Desktop 教學:匯入 Claude Code 工作設定,選本機或雲端模型之前先看資料流向
延伸閱讀:Drex 1.5 開放權重:讓本機模型回傳選項機率,怎麼做客服分流?