RoboColosseum 實機評測公開,一萬五千次測試如何比較機器人能力?
RoboColosseum 十一月公布真實場地機器人評測,分開測試直接泛化與固定資料微調。本文解讀一萬五千次啟動測試、配對比較、部分進度與人形機器人結果,以及免費評測申請條件。

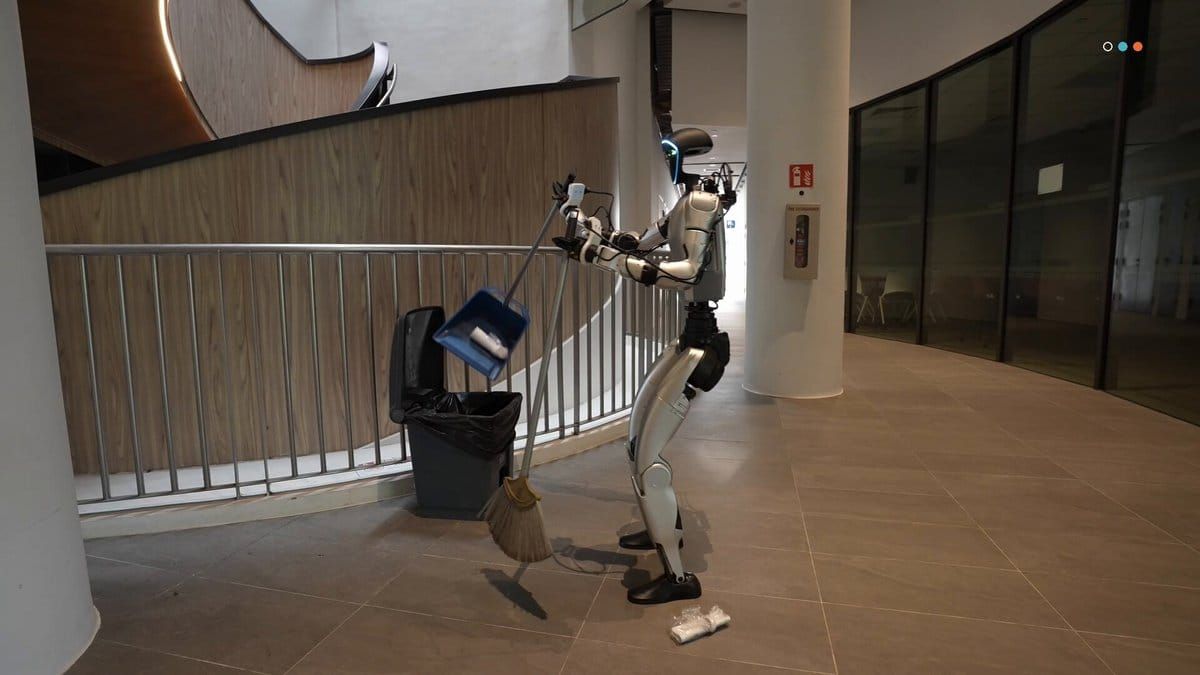
RoboColosseum 把機器人比較搬到真實場地,開始用共同規則累積實機證據。二〇二六年十一月二日論文與十一月四日發布的計畫,涵蓋機械手臂、雙臂系統與人形機器人。
官方啟動文章列出約一萬五千次實機測試。當中,開放路線的研究包含一百二十四個場地、一萬一千三百九十八次評估,組成五千六百九十九組配對比較。
這些數字描述不同範圍,因此不能互相替代。它們共同回應一個問題,同一套模型到了不同機構或工作現場,能力是否仍能用相同方法衡量?
初步結果顯示,模型排名會隨機構、任務與評測路線改變。一次成功展示能說明可行性,持續比較則需要保存條件、失敗與完成程度。
有模型的研究團隊,可以借用這種方法安排真機測試。讀榜單的人則適合先看兩條路線與計分方式,才能判斷哪一個結果接近自己的部署問題。
從直接泛化與固定資料微調的差異看起,後面的模型排名才有共同分母。
RoboColosseum 兩條評測路線各測什麼?
直接測試與固定資料微調,分開回答泛化與適應能力。Open track 讓模型面對指定任務時,先不做該任務的額外微調,觀察既有能力能走到哪裡。
這裡的零樣本,指的是沒有針對評測任務再訓練。模型可能已經接觸大量機器人資料,因此閱讀時仍需要確認使用的訓練版本與部署方式。
Fine-tune track 則讓不同模型使用相同任務示範資料,再到固定條件下評估。微調是用特定資料調整模型,這條路線因此更接近有能力收集現場示範的採用情境。
本次固定微調資料為每個任務一百段示範,論文涵蓋四種機構的二十項任務。官方流程另列每任務二十五次測試,讓比較有一致的資料與執行起點。
如果研究者想知道新模型拿來就能做多少工作,開放路線比較接近需求。若問題是投入相同資料後,哪個模型學得較好,微調路線才更能對應。
兩條路線得到不同名次,因而有研究意義。它表示既有泛化能力與使用少量指定資料後的能力,可能需要分開選型,單一總榜很難同時回答兩種問題。
本次比較包含五種通用機器人模型,開放路線還加入三種前沿語言模型代理。不同方法都要接到實際機構操作,因此工具與控制介面也屬於評測環境的一部分。
把條件固定以後,還需要讓不同場地的結果維持可解讀。這是配對比較與共同硬體規則要處理的下一段工作。
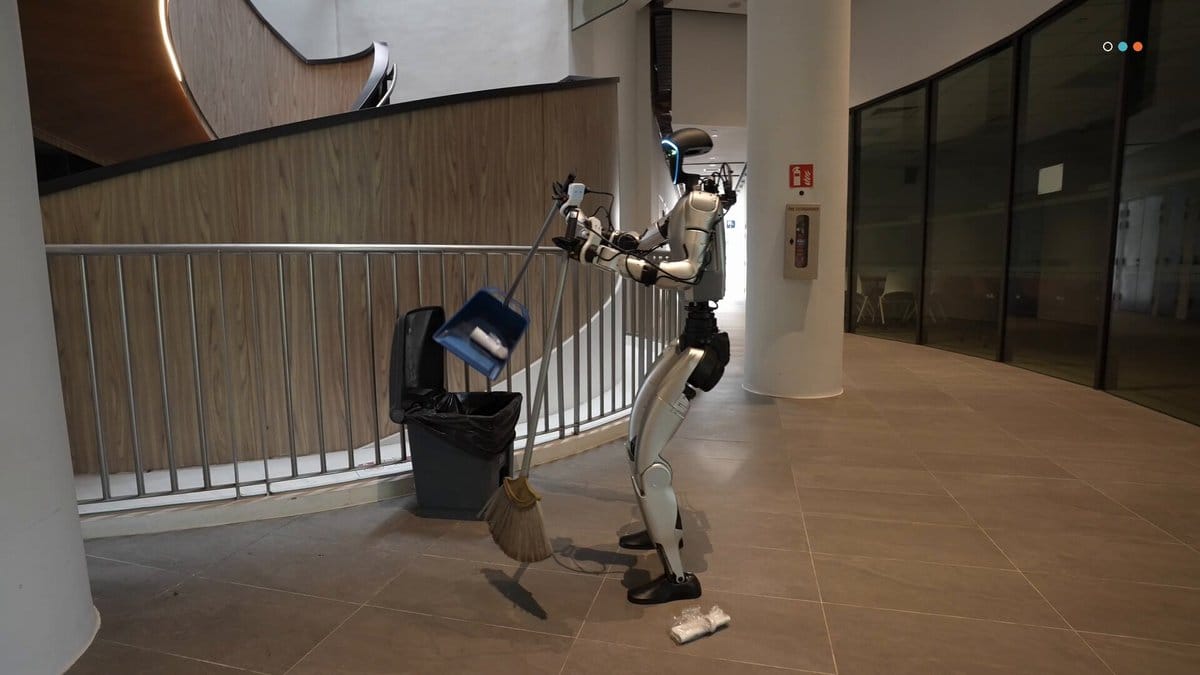
Introducing RoboColosseum
— RoboColosseum (@RoboColosseum) November 4, 2026
An open robot eval initiative by @huggingface @BitRobotNetwork @eaic_sg @DJiafei
Access:
- 100+ robots (@UnitreeRobotics G1s, @LeRobotHF SO-101s, YAMs, Franka and more)
- 140+ in-the-wild scenes
- Open rollout data
- 10,000 FREE eval hrs
Thread ↓ pic.twitter.com/fHPHRe6bX6
本事件官方或論文原作者示範影片。 來源:官方原始貼文。
一百二十四個場地如何累積可比結果?
同一組配對盡量在匹配條件下操作,再以共同規則記錄結果。這樣能降低場地難度差異,對兩個模型相對表現造成的干擾。
RoboColosseum 在同一種機構內標準化硬體,並以專責操作人員執行測試。機構包含 SO-101、Franka 手臂、雙臂 YAM 與 G1 人形機器人,各自有可比較的設定。
官方描述的真實場地包括教室、餐飲空間、圖書館與住家。物體位置、光線與工作表面會變化,這些差異讓評測更接近日常環境,也增加記錄條件的需求。
配對時若只有勝負,兩個模型都成功和兩個模型都失敗,可能同樣被算成平手。但兩種情況對任務難度的意義不同,因此研究加入更細的統計處理。
官方使用難度校準 Rasch 方法,同時估計模型能力與任務難度。可以把它理解為,不只問誰贏了,也嘗試考慮這場比賽本身有多難。
方法會使用人類提供的難度評分作為資訊,再隨更多測試更新估計。這讓不同任務的結果有機會放在共同尺度上,但仍需要依資料量與模型假設閱讀。
因此,榜單分數應連同測試次數與評測範圍保留。少量結果可能受到特定場景影響,累積更多資料之後,相對名次才有機會變得穩定。
研究的開放路線在四十一天完成一萬一千三百九十八次評估。這個累積方式提供的是持續測量的基礎,讓後續版本能在相近規則下比較。
結果累積到一定規模,便能看出機構與任務如何改變排名。這也解釋為何機器人選型需要超過一個總分。
真機比較還要面對物體與設備的變化。一次測完後,操作人員需要重新安排場景,並確認下一個模型面對的起點足夠接近,否則先後順序也可能影響結果。
因此,盲測的用途是減少評分者因知道模型名稱而產生的偏差。它和標準化機構、匹配場景共同作用,讓相對表現有較一致的判讀基礎。
模型更新時也要重新標記版本。若權重、控制工具或提示修改,新的結果應能追溯到這些變動,才容易辨認改進出現在動作策略,或上層代理的操作方式。
同一原則也適用於失敗影片。保存原始操作與評分理由,可以讓其他研究者檢查物體是否真的放妥、任務是否有中斷,以及部分進度的標記是否符合共同規則。
為什麼不同機器人沒有共同第一名?
模型的相對強弱會隨資料、機構與任務組合變動。論文觀察到不同機構任務集合的排名一致性偏低,顯示某一套測試的領先很難直接延伸到所有硬體。
例如,微調路線中,不同模型分別在單臂或雙臂系統表現較好。這提示研究者,收集相同數量示範之後,架構與既有資料仍可能影響適應成果。
不過,這種差異無法只用機構外形解釋。因為各系統也涉及資料分布、操作介面與任務特性,若要找出真正原因,還需要更受控的比較。
對採用團隊而言,這個結果最直接的意義,是先列出自己的操作範圍。抓取零件、雙手裝袋和移動身體有不同需求,應優先找相同工作類型的證據。
若現場能提供示範資料,也需要把調整成本放進比較。模型本來名次較後,可能在特定任務微調後改善,因此投入資料和取得成果之間的關係值得另外量測。
語言模型代理加入實機比較,也顯示高階推理能在部分條件下產生競爭力。官方在九百零一組匹配比較中,代理取得較多進度的有三百九十四組,機器人專用模型則有二百六十五組。
這組數字仍是配對進度結果,剩下包含平手等情況。它不能直接換成通用家務成功率,因為任務與操作介面的限制仍存在。
因此,選型時可以先依機構和是否微調縮小範圍,再比較自己關心的任務。這樣較容易知道榜單差異會不會改變實際部署決定。
排名變化也讓完整完成與部分進度需要分開呈現。否則兩個同樣失敗的模型,可能被誤認為能力完全相同。
人形機器人零次完成,進度分數有何用途?
進度分數描述失敗前走過多少步驟,完整成功則保留自己的門檻。G1 人形機器人的五項任務中,本次受測策略都沒有完成全部工作。
然而,它們的平均進度介於百分之十三點三與二十三點二。這能指出有些策略已完成較多前置動作,方便研究者辨認接下來需要改善的環節。
如果只看成功與否,這些差異都會顯示為零。進度指標因此能補充研究資訊,但在要交付完整工作的現場,仍需要獨立確認最終完成率。
例如,一個多步驟任務可能包含找到物品、拿起、移動與放好。完成前三步有助於診斷能力,客戶要的卻是物品最後到達正確位置,兩種衡量各有用途。
這也讓評分規則需要事先清楚。若某一步只做到一半可以拿多少分,或掉落物品後如何計算,會影響模型比較,因此公開規則是重現的重要材料。
官方同時呈現進度與完整成功,讓研究者能觀察改善是來自更常走到中途,或真正增加完成整項任務的比例。兩者對後續工程投入的指示可能不同。
對部署者,最實際的做法是把完整成果與中途失誤一起留存。因為修正抓取失敗和修正任務規劃失敗,可能需要不同資料與控制方法。
當指標定義清楚,研究者才適合用更少測試追蹤排名變化。這把評測成本帶到下一個問題。
主動配對與免費評測如何使用?
主動配對把測試優先留給相對強弱仍不清楚的模型組合。真機操作需要時間、人員與設備,因此每一次比較最好都能增加有用資訊。
官方觀察,這種方法大約用四百至五百次評估,就能和完整資料榜單達到約九成排序一致;均勻抽樣約需一千次。這裡比較的是排名一致程度。
完整資料榜單本身仍來自當次研究。因而九成一致,表示較少測試能較快接近該參考排序,不能把它理解成模型能力已被測得九成準確。
這種安排適合持續加入新模型的情況。若兩個模型的相對表現已很清楚,資源可以先移到仍不確定的組合,讓榜單更新更有效率。
計畫也提供一萬小時免費評估供團隊申請。申請者需要說明自己的策略與希望測試的機構,再由團隊協調安排,因此時間額度屬計畫提供的總體入口。
研究者可以先準備模型版本、操作需求、資料條件與任務範圍。這些資訊能幫助評測者判斷如何接入,也方便最後把結果和其他模型放在一致條件下比較。
本次是新的真實場地評測計畫,閱讀時應核對二〇二六年論文與官方計畫頁,避免只依名稱把它和較早的模擬研究混在一起。
建議先選一種機構與一條評測路線,再決定要比較泛化、微調效率或完整任務成功。問題先縮小,結果才更容易轉成下一步開發工作。
RoboColosseum 常見問題
一萬五千次和五千六百九十九組比較為何不同?
官方啟動文章列的是整體實機測試規模,論文開放路線的一萬一千三百九十八次評估則組成五千六百九十九組配對。範圍與計數單位不同,引用時需要保留原始口徑。
進度二成代表成功率二成嗎?
進度表示走過多少任務步驟,成功率則看完整工作是否完成。本次 G1 結果正好顯示,完整成功都為零時,部分進度仍能呈現差異。
榜單第一名適合直接部署嗎?
應先核對機構、任務、資料與是否微調,再安排自己的現場測試。榜單幫忙選出值得比較的候選,現場交付條件仍需要同一套驗收規則確認。
可以先把一項常做的操作拆成可觀察步驟,保留完整成功條件,再重複測試。這樣才容易把模型更新和真實工作改善連起來,並持續追蹤。
延伸閱讀:RobotAgentBench 測家用機器人自主性:會抓物,為何仍不會自己把家務完成?
延伸閱讀:micro1 Dual-Arm Sim 評測:800 次模擬只有 11 次完成,為何 AI 說做完還不算?