本地模型與硬體
24GB 顯卡能跑多大本地模型?RTX 4090 與 RTX 5090 的 4-bit 量化與 KV Cache 實戰門檻
24GB 顯卡或 RTX 5090 能跑多大本地大模型?解析 16GB 與 24GB+ VRAM 級距的真實模型上限、70% 顯存分配法則與 NVFP4/GGUF 量化選型,避開 OOM 爆顯存地雷。
本地端大模型部署、硬體記憶體門檻、推論成本與架構比較。
本地模型與硬體
24GB 顯卡或 RTX 5090 能跑多大本地大模型?解析 16GB 與 24GB+ VRAM 級距的真實模型上限、70% 顯存分配法則與 NVFP4/GGUF 量化選型,避開 OOM 爆顯存地雷。
本地模型與硬體
本地跑大模型該選 Ollama、llama.cpp、vLLM 還是 MLX?完整對比四大開源推論引擎的 GitHub 生態、記憶體利用與硬體適配法則,幫你依 NVIDIA 顯卡或 Mac 選出最快組合。
本地模型與硬體
Mac Studio 128GB 能跑多大的本地大模型?完整解析 Apple Silicon 統一記憶體架構為何能低成本挑戰 70B+ 參數模型、MLX 框架優勢,以及購買與設定前必看的記憶體頻寬限制。
本地模型與硬體
AMD Strix Halo(Ryzen AI Max+ 395)本地跑大模型表現如何?解析其 128GB 統一記憶體架構、Windows Vulkan 與 Linux ROCm 後端設定差異,以及與 Mac Studio 的真實取捨。
開源 AI 與 MCP
Continue 是什麼?GitHub 突破 3.6 萬顆星的 Apache-2.0 開源 AI 程式助理,同時支援 VS Code 與 JetBrains,讓開發團隊自由串接雲端 API 或企業內網本地模型。
開源 AI 與 MCP
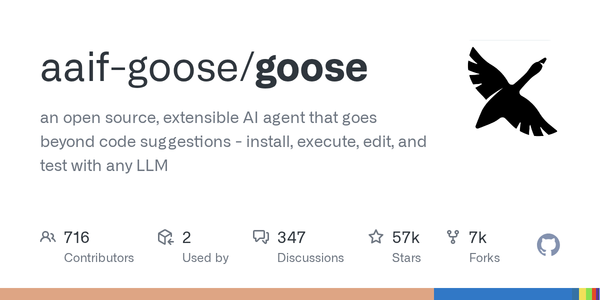
Goose 是什麼?由 Linux 基金會 Agentic AI Foundation 託管的 Apache-2.0 開源本地 AI 代理,GitHub 突破 5.6 萬星,透過 Rust 核心與 70 多種 MCP 擴充自由切換各家模型。
開源 AI 與 MCP
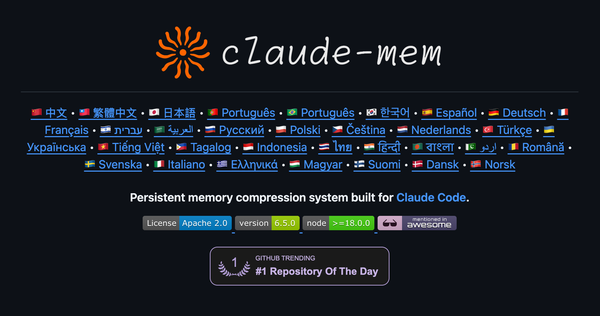
Claude-Mem 是什麼?這套突破 11.8 萬顆星的 Apache-2.0 開源持久化記憶層,透過 SQLite 與向量檢索壓縮程式對話紀錄,幫開發者省下高達 90% Token 成本。