AMD Strix Halo(Ryzen AI Max+)跑本地大模型實測:挑戰 Mac 統一記憶體的 Windows/Linux 高性價比選擇?
AMD Strix Halo(Ryzen AI Max+ 395)本地跑大模型表現如何?解析其 128GB 統一記憶體架構、Windows Vulkan 與 Linux ROCm 後端設定差異,以及與 Mac Studio 的真實取捨。

過去想在 Windows 或 Linux 陣營買一台「體積像便當盒一樣小、卻能把 70B 大模型塞進記憶體」的電腦,幾乎是不可能的任務,因為傳統 x86 筆電與迷你主機總是卡在顯卡顯存太小。
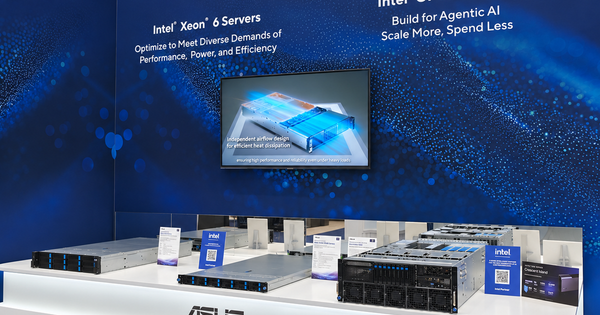
隨著 AMD Ryzen AI Max+ 系列(開發代號 Strix Halo,代表型號如 Ryzen AI Max+ 395) 與多款搭載該平台的迷你工作站陸續登場,x86 陣營終於迎來了正面挑戰蘋果統一記憶體的硬體架構。
它最核心的賣點,就是用 256-bit 記憶體匯流排把最高 128GB 甚至更高容量的 LPDDR5X 高速記憶體(頻寬約 256 GB/s)直接共享給強化的整合式 Radeon 8060S 繪圖核心使用。
這代表開發者不必組裝龐大的多顯卡主機,就能在 Windows 或 Linux 環境下,把 32B 密集模型甚至量化後的 70B 級模型與本機向量資料庫同時載入高速記憶體裡運行。
對習慣 Linux 容器化部署或 Windows 軟體生態、不想為了跑大容量模型而被迫轉換到 macOS 的台灣工程師與極客玩家來說,這是一個極具吸引力的新選項。接下來,我們拆解它的實際記憶體優勢與軟體後端避坑重點。
延伸閱讀:Mac Studio 128GB 本地跑 70B+ 大模型值不值得?Apple Silicon 統一記憶體與 MLX 設定避坑指南
為什麼 Strix Halo 能打破傳統迷你主機的 AI 天花板?
一般市面上的迷你電腦就算插滿 64GB 或 128GB DDR5 記憶體,受限於雙通道 128-bit 頻寬,用內顯跑起大模型依然慢如蝸牛。
AMD Strix Halo 重新設計了記憶體控制器,透過 256-bit 寬通道將頻寬推升至約 256 GB/s 級距,並讓整合式 GPU 能夠動態取用絕大部分系統記憶體作為顯存。
這讓它在同體積的迷你工作站市場裡,首次具備了與中階 Apple Silicon 晶片一較高下的硬體本錢,而且價格通常更具彈性。
| 大容量迷你桌面平台對比 | AMD Ryzen AI Max+(Strix Halo) | Apple Silicon Mac(Max / Ultra) |
|---|---|---|
| 作業系統與開發相容性 | 原生支援 Linux(Ubuntu/Fedora)與 Windows | macOS 生態,部分 x86 容器需轉譯 |
| 統一記憶體頻寬水準 | 約 256 GB/s(256-bit LPDDR5X) | 依型號約 400 至 800+ GB/s |
| 最佳本地推論後端 | Linux 下用 ROCm;Windows 下優先用 Vulkan | Apple 原生 MLX 或 Metal 後端 |
軟體後端才是關鍵:Linux 走 ROCm,Windows 記得切 Vulkan
買了 Strix Halo 平台卻覺得效能不如預期,十之八九是選錯了推論後端。
根據 AMD 官方技術部落格 與近期開發者社群實測,不同作業系統有截然不同的最佳設定路徑:。
Windows 用戶:優先使用 LM Studio 的 Vulkan 後端
在 Windows 環境下,消費級硬體對 AMD ROCm 套件的支援度仍在持續演進中。
目前社群公認最穩定、且能輕鬆達成高比例 GPU 卸載的解法,是在 LM Studio 或 llama.cpp 中直接開啟 Vulkan 加速後端,安裝過程幾乎零折騰。
Linux 用戶:搭配 ROCm 與核心記憶體參數調整
如果你習慣在 Ubuntu 或 Fedora 上跑無頭 Ollama 伺服器或本地 RAG 管線,Linux 下的 ROCm 生態最為成熟。
不過實務上常需要在系統開機參數(例如調整 amdgpu.gttsize)放寬核心對內顯可用記憶體上限的限制,才能把 128GB 空間徹底開放給超大模型與上下文快取使用。
延伸閱讀:AMD NPU 能跑哪些本地模型?Unsloth 新支援的記憶體門檻與設定教學
購買前必須認清的物理天花板:256 GB/s 的頻寬現實
雖然 Strix Halo 解決了「裝得下大模型」的問題,但 256 GB/s 的記憶體頻寬依然明顯低於高階獨立顯卡(動輒破 1,000 GB/s)或蘋果高階 Ultra 晶片。
這意味著用它跑 70B 級模型時,雖然能順利啟動並用於離線文件整理或背景代理排程,但吐字速度無法跟高階獨顯比拚,比較適合重視靜音、x86 Linux 原生環境與大容量多工的開發者。
常見問題(FAQ)
Q1:Strix Halo 128GB 迷你主機適合拿來做團隊多人共用的 AI 伺服器嗎?
不建議用於高併發多人同時呼叫。這類統一記憶體迷你工作站受限於記憶體頻寬與算力,最適合個人開發、離線資料隱私處理,或搭配排程做低併發的自動化代理任務。
Q2:用它跑本地 AI 時,NPU 跟內建 Radeon GPU 哪個比較重要?
跑大型語言模型(LLM)推論與上下文處理時,主要還是靠內建的 Radeon GPU 與高頻寬統一記憶體在撐;NPU 則多用於極低功耗的背景語音或系統級輕量 AI 任務。
Q3:一般 16GB 或 32GB 的 Strix Halo 值得為了 AI 買嗎?
如果預算只買到 32GB 版本,在模型容量上並沒有比一般電競筆電佔便宜;Strix Halo 真正的價值要到 64GB 至 128GB 版本才能完全拉開與傳統獨顯電腦的差距。
Q4:除了跑對話模型,它還能同時跑本地向量資料庫嗎?
可以。這正是 128GB 統一記憶體的最大優勢,你可以一邊掛著 14B 或 32B 模型,一邊在背景跑 Embedding 嵌入模型與 ChromaDB,整套離線 RAG 知識庫放進一台小主機綽綽有餘。
結語:給 x86 開發者的靜音大容量新解方
長期以來,蘋果幾乎獨佔了「安靜、省電又能裝進超大模型」的桌面市場。
AMD Strix Halo(Ryzen AI Max+) 雖然在絕對頻寬上仍有差距,卻成功把 128GB 統一記憶體帶回了熟悉的 Windows 與 Linux 世界。
如果你正好需要一台能跑原生 Linux Docker、同時想把中大型開源模型與本地 RAG 知識庫全部收進桌面一角的開發機,這條硬體路線非常值得列入比較清單。
歡迎免費訂閱 AI 郵報,每週追蹤更多實測工具教學與開源代理生態動態。