Underdog Woof 開放語音權重,40.6 MB 的英文朗讀模型能做到什麼?
Woof 本週開放英文語音權重。拆解31.7與40.6MB兩版本、1.42%錯誤率、M5 Max速度與實際非商用授權,理解小模型部署的條件。

讓電腦念出一串電話號碼,難處不只是聲音自然。少念一個數字,或把日期看成算式,都會讓一句流暢的回答失去用途。
Underdog 本週開放 Woof 的可下載語音權重,並在 11 月 7 日官方貼文介紹這個小型英文文字轉語音模型。公開模型庫建立於 11 月 5 日。
官網頁面署名日期為 10 月 26 日,較早的遊戲展示貼文在 11 月 5 日。因此這次值得關注的是本週可取得的權重與完整執行資料,而非新論文首發。
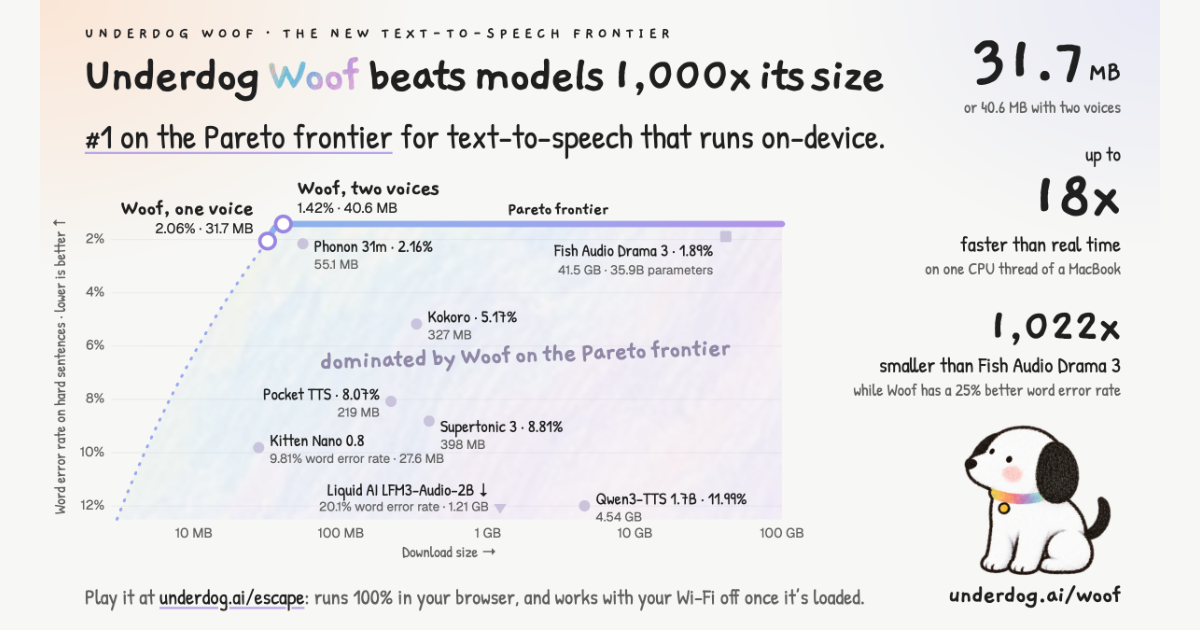
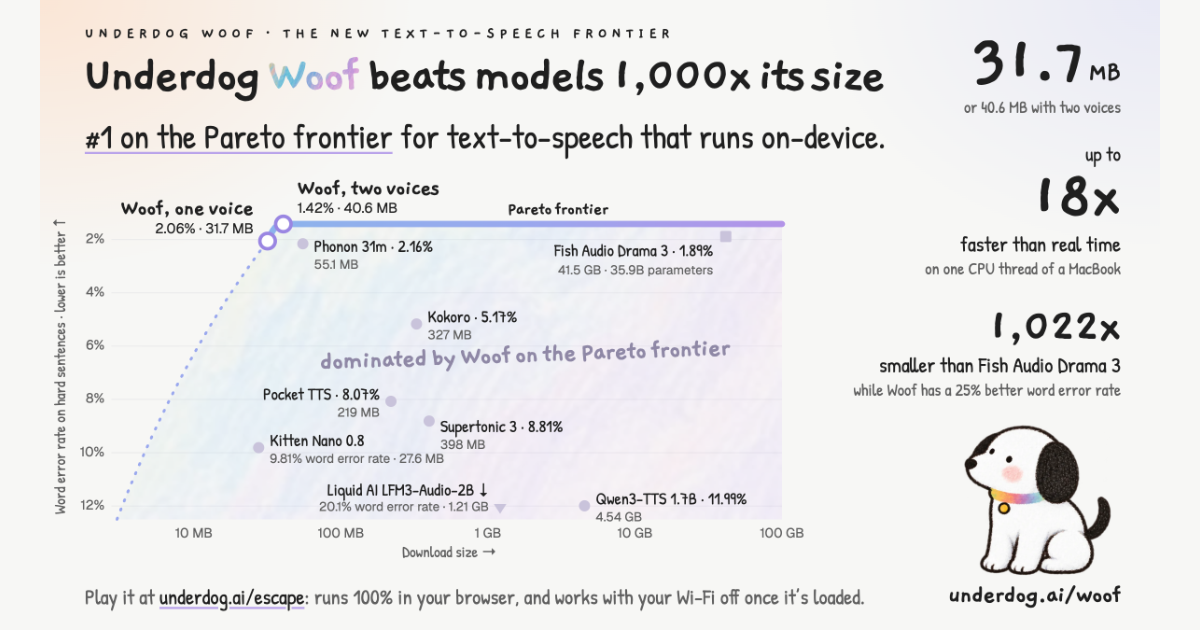
瀏覽器裡的單聲音版本為 31.7 MB,可下載的雙聲音版本為 40.6 MB。兩者用不同執行環境,速度與記憶體也要分開看。
官方在五百句英文困難句上,回報雙聲音版本較佳聲線的字詞錯誤率為 1.42%。這測的是文字有沒有被說對,沒有涵蓋所有聲音品質。
我會先把它放進英文數字朗讀與離線應用的測試清單。它的小體積有實際價值,但模型版本、語音評測與商用條件必須一起確認。
先拆開兩個版本,才能理解下載大小如何轉成真正能執行的語音功能。
Woof 的兩個版本,差在什麼地方?
單聲音版本適合直接在瀏覽器體驗,公開模型庫則提供兩個聲音的本機版本。因此,網站上最醒目的下載大小,並非下載模型的全部規格。
瀏覽器版本有約三千零七十萬參數,下載大小為 31.7 MB。載入完成後,官方表示可以關掉網路繼續使用,文字留在本機處理。
雙聲音版本約有三千八百二十四萬參數,包含語音模型與音訊解碼器。它提供 Juno 和 Mira 兩種聲音,並以單一權重檔保存。
解碼器的工作,是把模型產生的內部音訊表示還原成可播放聲音。因此比較完整下載大小時,這一部分有沒有算入,會直接改變結果。
官方模型卡列出雙聲音版本輸出為二十四 kHz 單聲道,並提供只需要 numpy 的執行方式。numpy 是常見的數值運算套件,讓執行環境較精簡。
這裡的價值是應用不必為每句朗讀呼叫雲端服務。若要做英語提醒或讀出固定格式文字,開發者可以把語音生成放在裝置內。
官方也列出音訊解碼器參考的 Mimi 設計,以及部分訓練語料的來源與致謝。這些上游材料有自己的授權,並不代表完成後的整套模型必然沿用相同條款。
朗讀模型和語音辨識模型的方向也不同。前者把文字變成聲音,後者把聲音變回文字,因此不能拿同廠其他辨識產品的成績當作這次生成品質。
瀏覽器展示與可下載版本不能互換成績
單聲音的速度使用整數權重與 PyTorch 測量,雙聲音則使用模型庫內的 numpy 程式。即使來自同一產品家族,兩者仍有不同運算負擔。
因此,不能把單聲音的最小檔案、雙聲音較佳的準確率,再加上另一個聲線的最快速度,組成一個看似全部兼得的版本。
檔案小讓部署更容易,但應用是否可靠,仍要看它如何處理輸入文字。對電話號碼與日期來說,發聲前的改寫尤其重要。
延伸閱讀:Ollama 加入本機語音生成:Mac 用 Phonon 把文字轉聲音,API 與中文限制先看懂
We made a game for our new frontier text-to-speech model, Woof. 31.7 MB, so small that it runs in your browser
— Underdog AI (@UnderdogAI) November 5, 2026
Play the game on X... all voices are Woof. Defeat Darkcloud for an invite https://t.co/ImUFYDCBQG pic.twitter.com/tthHx7ZGBK
為什麼電話、日期與代碼要先改寫?
模型在發聲前會把特殊文字轉成適合朗讀的形式,這會直接影響最後說出的內容。這個步驟通常叫文字正規化,可以理解為先替機器整理讀法。
例如一個電話號碼要逐位念出,金額卻常需要念成完整數值。相同的數字字元,因為用途不同,應該送進發聲模型的文字也不同。
官網用日期、價格、網址與產品代碼展示這個流程。像帶有英文字母和連字號的代碼,先轉成逐個字母與數字,才能保留原本辨識資訊。
這種改寫也存在語境選擇。斜線日期究竟代表日月還是月日,不能只靠聲音模型的大小解決,應用仍要先確定自己的輸入格式。
模型庫內的規則式正規化只需要標準程式庫,也讓開發者可選擇關閉它。如果應用已有固定讀法規則,就能自行處理後再送入語音模型。
這會影響測試方式。只拿一段散文試聽,可能看不出電話、時間與價格的錯誤,因為它們不是散文裡常出現的字詞組合。
長文字也需要切段與重新生成
雙聲音執行程式會先按句子切開長文,較長句子再依標點分段。生成可以逐段處理,因此不必等整篇完成才取得所有音訊。
程式也會檢查片段是否長得不合理,或中間出現過長靜音。遇到這些情況,可以再生成,最多增加三次,最後保留較好的結果。
這表示官方提供的成果包含周邊處理。模型之外的文字改寫、切段與重抽,同樣影響聽到的聲音,不能只把表現歸給參數數量。
若外部團隊重做測試時關閉這些處理,取得的結果便可能不同。保留預設執行條件,才容易分辨差異來自模型還是應用整合。
1.42% 字詞錯誤率,代表哪一種能力?
這項結果來自官方自己的英文困難句測試,而且採用雙聲音版本中成績較好的聲線。它回答的是內容有沒有說對,並非人類聽感的總分。
字詞錯誤率的測法,是先讓模型讀出指定文字,再把音訊轉回文字,比較漏字、多字或替換。比例較低,代表較少這類內容差異。
但轉錄本身也可能出錯,因此測量不只涉及語音生成。對日期和數字,還需要判斷不同文字寫法是否其實表達同樣意思。
困難句測試使用五百句英文,內容集中電話、價格、日期、代碼與網址。官方用一個音訊模型轉錄,再用另一個模型判讀字詞差異。
Mira 聲線在這組設定下得到 1.42%,對應六十二個錯誤與四千三百七十九個字詞。Juno 為 1.53%,使用的是另一組實際轉錄字詞分母。
所以,較低錯誤率是特定聲線與判分流程的結果。即使它在這批內容表現較好,也還要另測專有名詞、口音與應用中的真實句子。
官網也列出單聲音版本在兩百句日常句子上的結果,字詞錯誤率為 2.05%,對應三千二百一十七個字詞中的六十六個錯誤。這組測試使用另一個轉錄器。
另外三十句帶有情緒與對話語氣的例句,得到 0.91%,分母只有三百二十九個字詞。較少題目得到更低比例,仍不能推論表演能力一定比所有其他模型好。
這些分開列出的測試讓讀者知道,題目類型、轉錄工具和樣本量都會改變數字。把三個百分比平均成一個總分,反而會掩蓋最需要測的內容差異。
為什麼「第一名」需要縮回測量範圍?
官方比較中,Fish Audio Drama 3 的字詞錯誤率為 1.89%。雙聲音版本相對少約四分之一錯誤,但這是相對比例,並非少了二十五個百分點。
下載大小比較也有邊界。Fish 的開放權重檔案用來呈現體積,聲音則經雲端 API 生成,不能直接拿來推論兩者在同一台電腦的速度差距。
模型卡還把部分其他模型的結果另外說明,因為轉錄工具不同。使用不同轉錄器的結果,不能和主要比較表當成完全一致的測量條件。
最重要的是,字詞少錯並不直接衡量語調、情緒、音色偏好或長篇聽感。官方的榜首宣傳應留在這份自評的內容準確度範圍內。
延伸閱讀:Fish Audio Drama 3 發表:強化 AI 配音表演控制,開放權重能怎麼用?
小檔案為何仍需要數百 MB 記憶體?
模型權重只是執行時需要的一部分,語音生成還會占用程式與中間資料的空間。因此,四十多 MB 的下載不代表只需四十多 MB 記憶體。
官方對雙聲音版本使用同一台 Apple M5 Max 的單一 CPU 執行緒測量,兩百句日常句子做三輪,再取速度的中位數。
Juno 的速度約為即時播放的 13.8 倍,峰值常駐記憶體約四百零二 MB。Mira 約為 7.2 倍,峰值約六百零一 MB。
這裡的倍數代表生成一段音訊所需時間,相對於播放這段音訊的長度。它並不是按下按鈕後,第一個聲音一定會在同樣比例時間內出現。
Mira 的字詞錯誤率較低,Juno 的這組速度較快。兩個聲線已呈現選擇差異,因此應用可以依自己的內容需求分別試聽與計時。
單聲音版本另外回報,十三點二秒音訊約用零點七三秒生成,程序峰值約八百五十二 MB,其中包含 PyTorch 與其他套件的負擔。
這說明精簡執行環境也能影響部署。即使權重略大,較輕的周邊程式仍可能讓雙聲音版本的整體記憶體需求較低。
然而單一筆電晶片的結果不能換成所有手機與手錶的承諾。瀏覽器還會受到 WebGPU 支援與裝置狀態影響,仍需在目標設備驗證。
開放權重可以直接拿去商用嗎?
可下載版本的實際授權要求商用另行取得許可,官網的簡短授權標籤並沒有交代全部條件。採用前應讀模型庫內的完整 LICENSE。
官網與發布貼文寫的是 CC BY-NC 4.0,但目前模型庫標示 Underdog Non-Commercial License 1.0。兩個名稱不同,不能只靠貼文標籤推定權利。
實際文件允許符合條件的個人、研究、教學與非營利用途,也要求對公開音訊及應用提供指定來源標示。修改或分享模型同樣需要遵守條款。
營利產品、廣告、營利影片與公司內部工作,都在文件所定義的商用範圍。下載權重不會自動給予這些用途的授權。
文件另外允許公司進行最多三十天的內部評估,用來決定是否取得商用授權。這個例外是測試,並不等於可直接投入客戶服務。
同一份文件也限制使用模型或輸出訓練其他語音及音訊生成模型。若目的是蒐集合成聲音再訓練自己的系統,便不能忽略這項條件。
Underdog 自家產品中的使用另有例外,因此直接用其服務與把權重拿出來自架,應分成不同使用路徑閱讀。
這些條件會改變整合順序。對研究者來說,可以先檢查英文格式文字的效果。對商業團隊來說,則應先對上授權與部署方式,再投入介面與素材製作。
Woof 常見問題 FAQ
Woof 支援中文朗讀嗎?
目前公開模型卡標示英文。官方這批數據也是英文測試,沒有足以推論中文品質的證據,中文需求仍應另找適合模型。
31.7 MB 與 1.42% 屬於同一版本嗎?
前者是單聲音版本大小,後者是四十點六 MB 雙聲音版本中 Mira 的成績。單聲音在同類困難句測試為 2.06%。
斷網後還能用嗎?
官網表示瀏覽器版本載入完成後可離線使用。可下載版本則在本機執行,但首次仍需取得權重與必要程式,不能把首次開啟也視為完全不需要網路。
免費可下載代表能用在營利影片嗎?
模型庫的實際授權把營利內容列入商用範圍,需要另外取得書面商用授權,不能只因為音訊由自己生成就推定沒有使用條件。
結論
Woof 展示了小模型和周邊處理一起改善英文朗讀的路徑。體積縮小有助於本機整合,數字正規化、切段與重抽則影響內容是否被完整說出。
若要開始評估,可以先從自己的電話、日期與代碼句子取樣,分別保留聲線、版本、錯字與等待時間。當這些條件都符合需求,再確認授權並決定是否投入應用。