OpenAI Whisper 與 whisper.cpp 語音轉文字教學:本地轉錄、字幕輸出與中文校對
認識 Whisper 與 whisper.cpp:本地語音轉錄、模型選擇、字幕輸出與繁體中文校對的注意事項。

會議錄音與訪談要整理成逐字稿,除了使用雲端服務,也可以在自己的電腦執行語音辨識模型。
OpenAI Whisper 是多語言語音辨識模型;whisper.cpp 則是以 C/C++ 實作的推論專案。截至 2026 年 11 月 22 日,兩者在 GitHub 分別超過 11 萬及 5 萬顆星。
本文整理本地轉錄的基本流程、字幕輸出與繁體中文校對。辨識速度與正確率會隨錄音品質、語言、模型與硬體變化,重要內容仍須聽錄音確認。
延伸閱讀:Prompt Engineering Guide 提示詞教學
Whisper 和 whisper.cpp 有什麼不同?
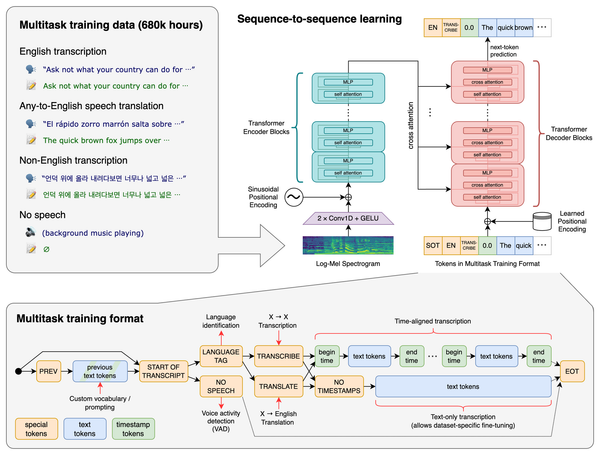
OpenAI 的 Whisper 是多語言語音辨識模型與 Python 專案,支援語音轉錄與翻譯等任務。whisper.cpp 是社群以 C/C++ 實作的推論專案,支援多種硬體與量化格式;兩者不是同一個應用程式。
whisper.cpp 可在適當環境下使用已下載的模型進行本地轉錄。某些加速或轉換流程仍有額外工具與依賴;模型、硬體與音檔會影響記憶體、速度及準確率。無論使用哪種方法,專有名詞、數字與人名都應回聽確認。
選擇模型:從資源和實際音檔測試
whisper.cpp 文件列出的參考數據中,base 約 142 MiB、small 約 466 MiB、medium 約 1.5 GiB,large 約 2.9 GiB;這些是模型檔案大小,並不等於全部執行記憶體。實際需求會依版本、量化和執行環境變化。
可先用短片段比較較小與較大模型的辨識品質與耗時,再決定是否處理完整錄音。中文口音、中英混說、多人重疊和背景噪音都可能影響結果,不能保證某一款模型對所有繁體中文錄音都最準。
本地轉錄基本流程
以下依 whisper.cpp 官方文件示範 macOS/Linux 的基本編譯與執行方式。需要 Git、CMake、相容編譯器與足夠磁碟空間;下載程式與模型需要網路。
git clone https://github.com/ggml-org/whisper.cpp.git
cd whisper.cpp
sh ./models/download-ggml-model.sh base
cmake -B build
cmake --build build -j --config Release
準備 16kHz、單聲道、16-bit WAV 音檔;如果已安裝 FFmpeg,可先轉換:
ffmpeg -i meeting.m4a -ar 16000 -ac 1 -c:a pcm_s16le meeting.wav
./build/bin/whisper-cli -m models/ggml-base.bin -f meeting.wav -l zh
這裡使用支援多語言的 base 作為範例;先以短音檔測試並依需求改用其他模型。命令列選項與字幕輸出方式可能隨版本改變,可執行 ./build/bin/whisper-cli -h 查詢目前可用的 SRT、文字檔等輸出選項。
繁體中文怎麼校對?
-l zh 指定中文,不保證一定輸出繁體。提示詞或繁簡轉換工具可以輔助,但不能保證用詞、專名、數字和時間戳正確;重要逐字稿應逐段對照錄音。格式轉換後尤其要檢查同音字及專業詞彙。
也不要把自動生成的摘要或字幕當成完整原音:安靜片段、音樂、多人同時說話都可能導致遺漏或幻覺。對外引用、會議決策或法律與醫療紀錄應由有權限的人校閱。
講者辨識與離線隱私
多人錄音若需要標示每位講者,請確認所使用版本與工具支援的說話者分離方式;不同整合方案可能需要額外模型或處理流程。不要把自動標籤直接當成人物身分確認。
本地執行已準備好的模型可避免將音檔送到轉錄雲端,但下載模型、更新或使用外部整合可能需要連網。請依實際應用、端點和組織政策檢查資料流向與儲存權限。
常見問題
一小時錄音多久轉完?
沒有固定答案:硬體、模型、加速設定、音檔與其他負載都會影響時間。先測試具有代表性的短片段再估算。
繁體中文可保證逐字正確嗎?
不行。人名、數字、中英夾雜及低品質錄音都可能辨識錯誤;應保留原音並人工回聽。