本地跑 Whisper 需要什麼電腦?CPU、Mac 與顯卡選擇及轉錄測試指南
本地執行 Whisper 的硬體指南:了解模型大小、CPU 與 GPU 加速,以及如何測試速度和辨識品質。

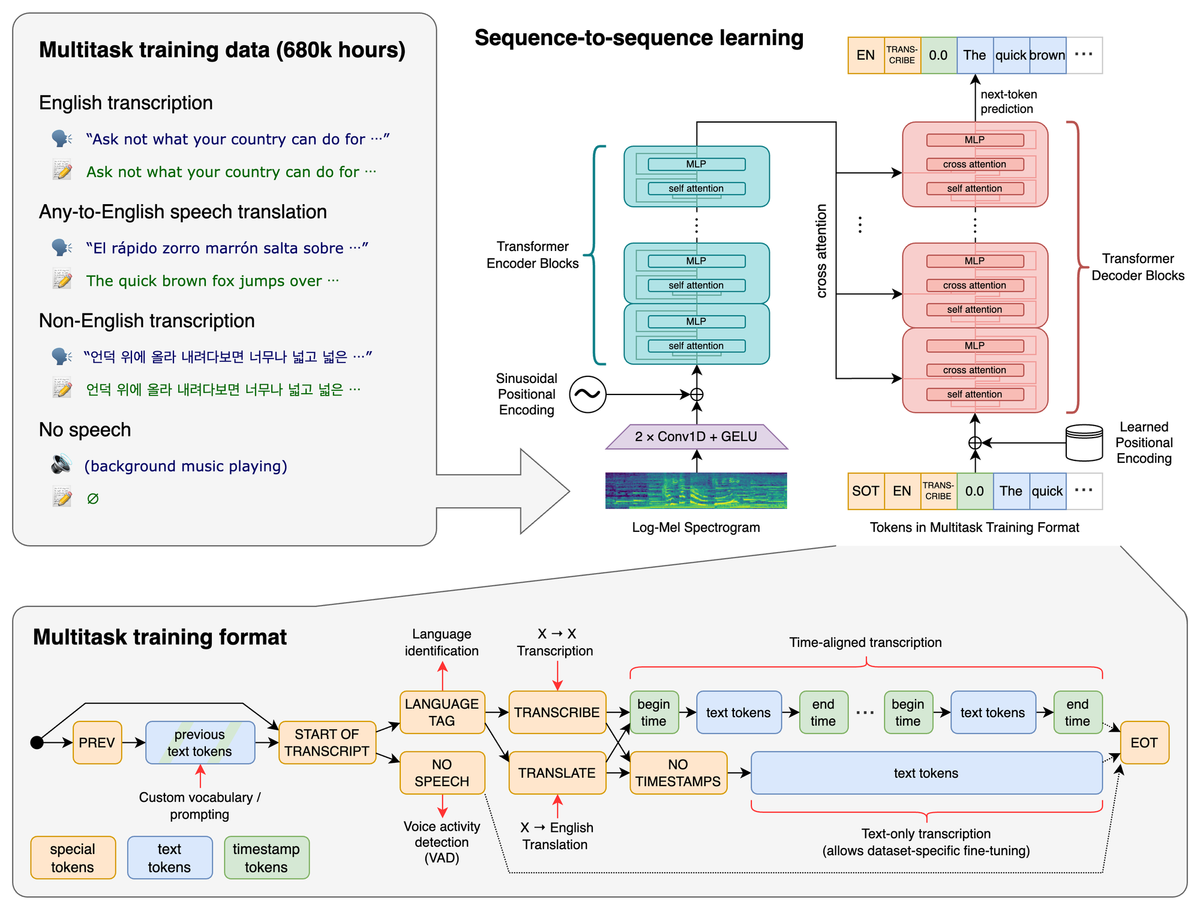
想在自己的電腦把會議錄音轉成逐字稿,卻不確定 CPU、Mac 或顯卡是否夠用?Whisper 的速度與資源需求,取決於模型、執行工具、音檔與硬體設定。
本文依開源專案文件整理模型大小、可用硬體加速與測試方式,協助你先評估現有設備,再決定是否升級;實際時間與辨識準確度需要以自己的錄音測試。
延伸閱讀:Whisper 與 whisper.cpp 本地語音轉文字教學
先看模型:檔案大小不是全部記憶體需求
Whisper 提供不同大小的模型。官方原始專案列出多種模型及大致顯示記憶體需求,並指出速度會依硬體與執行方式差異很大;whisper.cpp 也提供模型檔案與記憶體的參考數據。兩套實作、量化方式和實際環境不同,數字不能直接視為所有設備的保證門檻。
例如 whisper.cpp 文件列出 base 模型檔案約 142 MiB、small 約 466 MiB、medium 約 1.5 GiB、large 約 2.9 GiB。載入模型還要預留執行記憶體、作業系統及其他應用程式空間;長音檔與額外處理也會影響資源需求。
CPU、Apple Silicon 與 GPU 怎麼挑?
| 設備 | 可以先做什麼 | 需要留意 |
|---|---|---|
| 只有 CPU 的電腦 | 先從較小的多語言模型及短音檔測試。 | 處理大型模型可能較慢;速度取決於 CPU、記憶體和執行工具。 |
| Apple Silicon Mac | 查看所選工具是否支援 Metal 或 Core ML,再比較 CPU 與加速設定。 | 統一記憶體由系統與應用共用;不同機型、模型與設定表現不同。 |
| 支援的 NVIDIA GPU | 確認驅動、CUDA 與執行工具相容,並依文件啟用 GPU 加速。 | 顯存占用含模型及執行開銷,筆電和桌機同名 GPU 也不保證同速。 |
whisper.cpp 官方文件提供 Core ML、CUDA 與其他後端的建置說明,有些選項需要額外安裝或編譯步驟。加速是可測試的選項,不代表任何一小時音檔都能在固定分鐘數內完成。
如何做一個可比較的測試?
- 挑一段有代表性的錄音,包含預期的語言、口音、背景噪音與多人對話。先確認有權使用該音檔。
- 記錄硬體、作業系統、可用記憶體、工具版本、模型名稱與量化方式。
- 用相同音檔與設定測試,分別記錄模型載入、轉錄總耗時和記憶體峰值;若用語音活動偵測,也需標明。
- 回聽檢查人名、數字、中英切換與遺漏,速度之外也要比較品質。
可用「音檔長度 ÷ 處理時間」估算處理倍率。例如十分鐘音檔處理五分鐘,倍率是 2;這只是該次測試結果,不能推定其他錄音一定相同。
繁體中文與敏感錄音
指定中文或提供繁體中文提示可能影響輸出,但不保證繁簡一致,也不保證專有名詞和數字正確。轉換字形後仍需回聽原音,並依錄音內容與授權範圍處理。
模型與必要軟體準備完成後,本機推論可降低把音檔交給外部轉錄服務的需求;但下載、更新、外部 API 和整合工具可能連網。處理機密資料前應核對實際資料路徑、存取權限與組織規定。
購買設備前先確認
先以現有電腦和代表性短音檔測試;只有當耗時、記憶體或品質無法滿足需求,才評估更換模型、執行後端或升級硬體。多人說話者分離與後續摘要若另用模型,也應納入資源預算。