Live Long and Prosper:開源昌盛的年代,邊緣 AI 代理能強到什麼地步?
颱風讓活動縮減,熱情與創意沒減。我們帶著學習的心態,看 AI 代理邊緣應用黑客松四組隊伍如何用開源積木,在急診、機房、倉儲與停機坪讓 AI 自主行動。
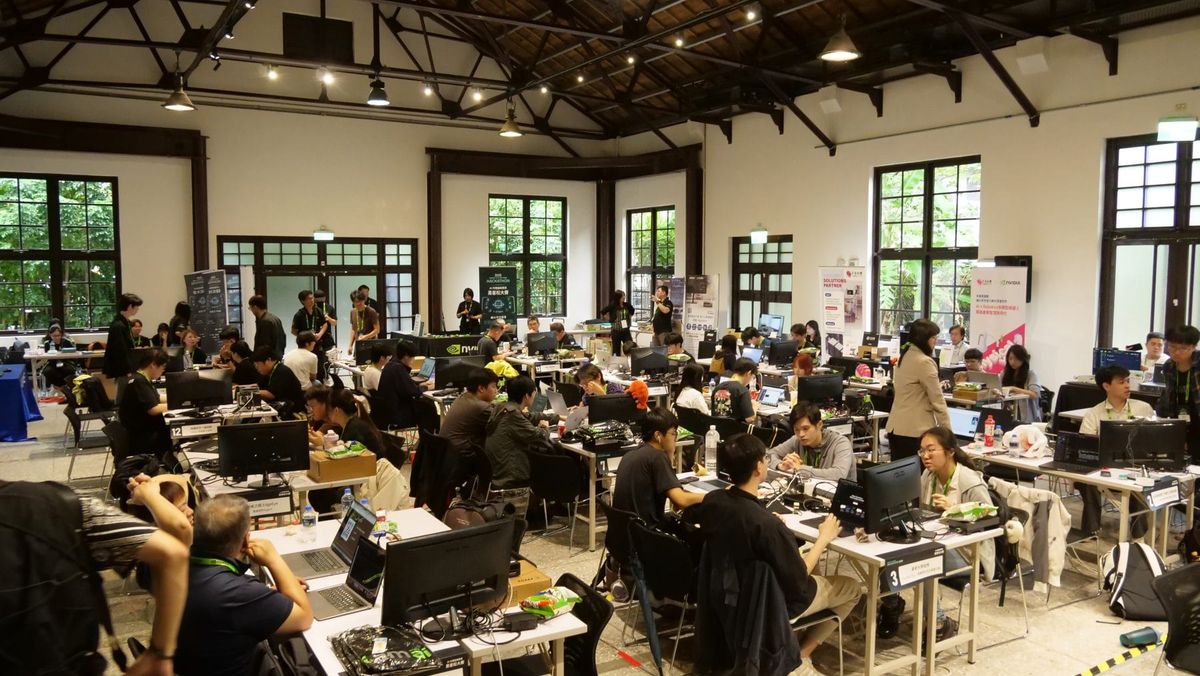
「Live long and prosper.」這是《星際爭霸戰》裡瓦肯人舉起分岔手勢時說的祝福,中文常譯作「生生不息,繁榮昌盛」。拿來形容現在的開源 AI 生態剛剛好:開放模型、推論引擎、Agent 框架一波接一波釋出,任何人都能下載、修改、裝進自己的機器。我們這次就是抱著學習的心態,到 10 月 21 日到 23 日由機器人王國主辦、NVIDIA 擔任 AI 技術協辦的「2026 Agentic AI on the Edge HACKATHON|AI 代理邊緣應用黑客松大賽」,看一件事:當這些開源積木全裝進一台擺在現場的主機,邊緣端的 AI 代理究竟能強到什麼地步?
上週受薔琵颱風影響,活動日期被壓縮到 10/22,但從現場來看,各隊的熱情沒減,創意也沒減。主視覺上寫著一句「讓 AI 不只回答,更能安全自主行動」,這場黑客松提供參賽團隊 NVIDIA 邊緣運算平台包括 NVIDIA DGX Spark™ 以及 NVIDIA® Jetson Thor™ 讓隊伍將他們的構想付諸實現。我們跟了其中四組隊伍:和平醫院團隊的急救 AI 小助手 triAIge、離線維運 Agent Blackout Ops、會自己量空間的機器人 ScanPilot,以及做機場地勤安全稽核的 T-Agent。四組題目橫跨急診、工廠機房、倉儲與停機坪,共同點是把模型和決策留在現場的機器上跑。
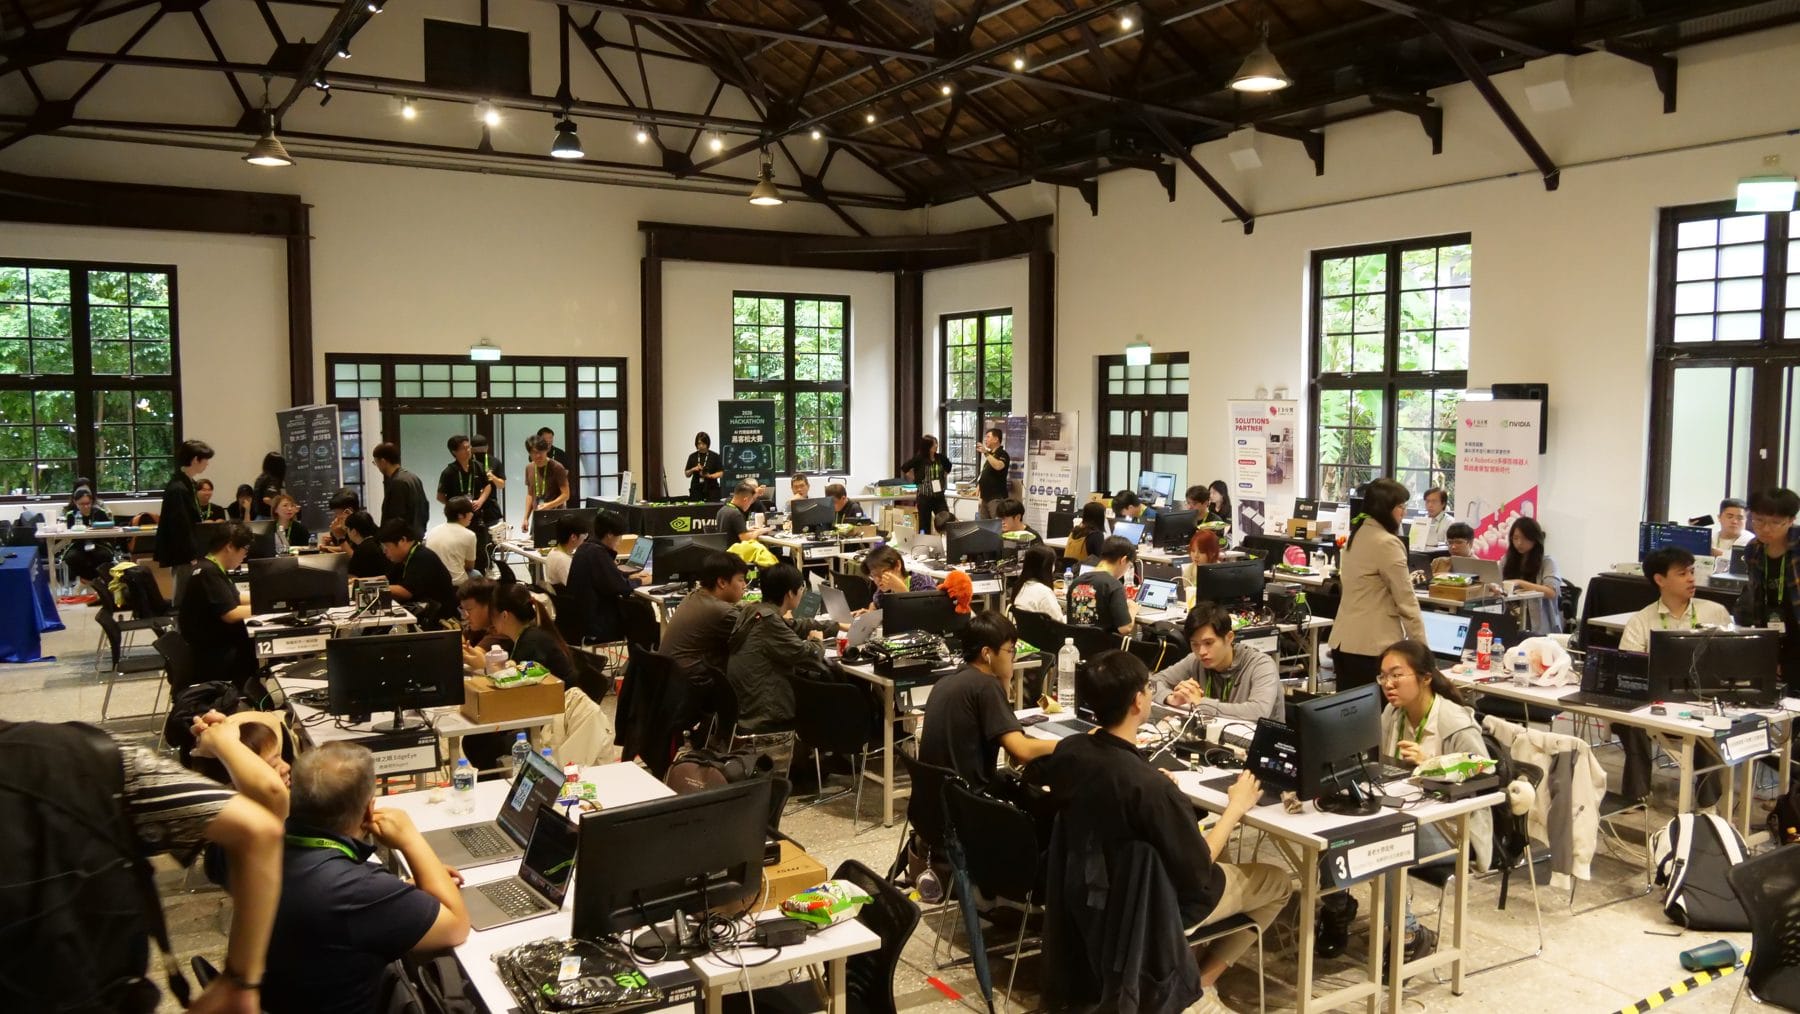
平常用 ChatGPT 這類服務,資料要先送到雲端機房算完再傳回來。邊緣 AI 則是把模型裝進擺在現場的主機,例如 NVIDIA 給機器人與嵌入式設備用的 NVIDIA® Jetson Thor™。好處是斷網也能動、資料不出門、反應更快;代價是算力和記憶體有上限,模型要挑得小、流程要設計得精。Agent 則代表 AI 可以呼叫工具、執行動作。過去要在現場跑這套,得自己從頭訓練模型、寫整套控制流程;現在開放模型和開源框架都現成可用,幾天的黑客松就能組出一個會動手的原型。打個比方,雲端 AI 像門市每件事都打電話回總公司問,邊緣 AI Agent 像門市裡有一位能自己處理狀況的店長,只有大事才往上報。
triAIge:同一個病人,不必被問三次
triAIge 名子非常有趣,取自 triage(檢傷分類),中間藏了 AI,是這次拿下第二名的作品,團隊來自和平醫院。簡報第一句就把痛點講完:「讓同一個病人,不必被問三次。」一位病患從救護車、急診檢傷到醫師面前,症狀、病史、用藥往往要重講好幾輪,每一關都有人在重新抄寫,就像去辦事每換一個櫃台就要重填一次資料。

triAIge 的做法是讓 AI 在救護員問診時一邊聽(團隊原本想要多做一個語意辨識的來處理)、一邊填表,病人送到急診時,表單已經預填好。流程分成三段:救護現場由對話預填救護紀錄表;急診檢傷時預填檢傷表,護理人員只要追問缺的欄位;醫師看診時拿到的病歷,每一條都附上來源,可以回溯到病人當時說的原句。
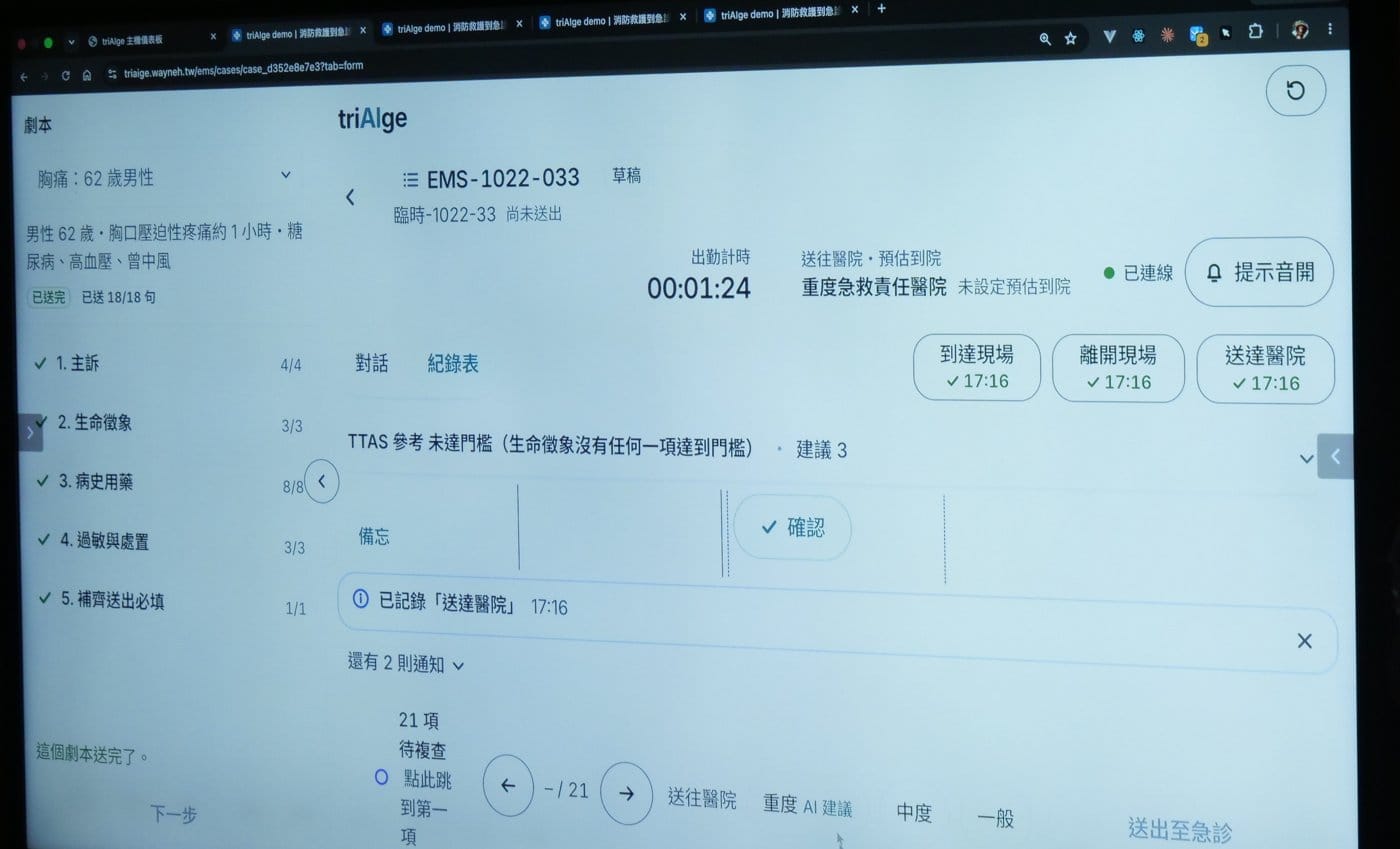
系統會參考台灣急診使用的 TTAS(台灣檢傷與急迫度分級量表)給出建議級別,畫面上「AI 建議」旁邊就是「確認」按鈕,決定權留在醫護人員手上。團隊也強調,模型、伺服器和資料庫全部跑在同一台機器上,可以整台放進醫院內網。
Blackout Ops:機房出事、網路也斷了,誰來修?
Blackout Ops 這個團隊非常專業,題目是「離線邊緣自主維運 AI Agent」,目標是 24 小時、百分之百在邊緣端運作的機房自主檢測,巡檢發現異常後,系統自動開事故單並派給 Agent。Agent 先讀出問題容器最後 30 行日誌,再從過往驗證過的修復紀錄裡找相似案例,每一步都即時寫在右側的軌跡裡。把機房內簡單的狀況由 Agent 自主修復,複雜的狀況整理好證據後調派給人。
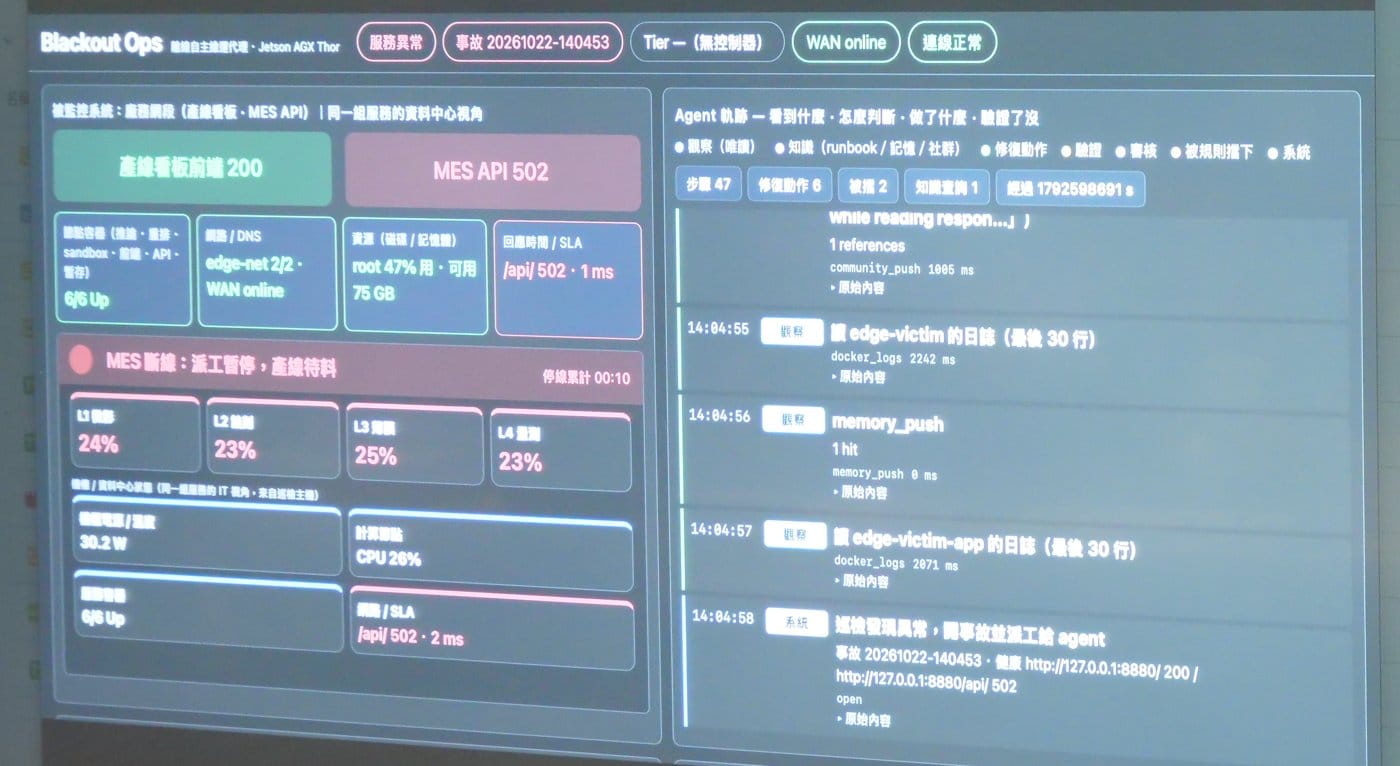
看門狗每 2 秒巡檢一次,異常交給跑在NVIDIA NemoClaw™ 與 OpenShell 沙盒裡的事故指揮官,背後是用 vLLM 在本機推論的 NVIDIA Nemotron™ 30B 模型。Agent 只能呼叫白名單內的工具,任何修改都要依序通過防護規則、第二把鑰匙的審查與人工核准;動手之後再檢查服務狀態與頁面內容,驗證失敗就重新規劃,驗證成功的修法才寫進記憶。知識層則包含 runbook、修復卡,以及十五萬筆以上的維運紀錄。
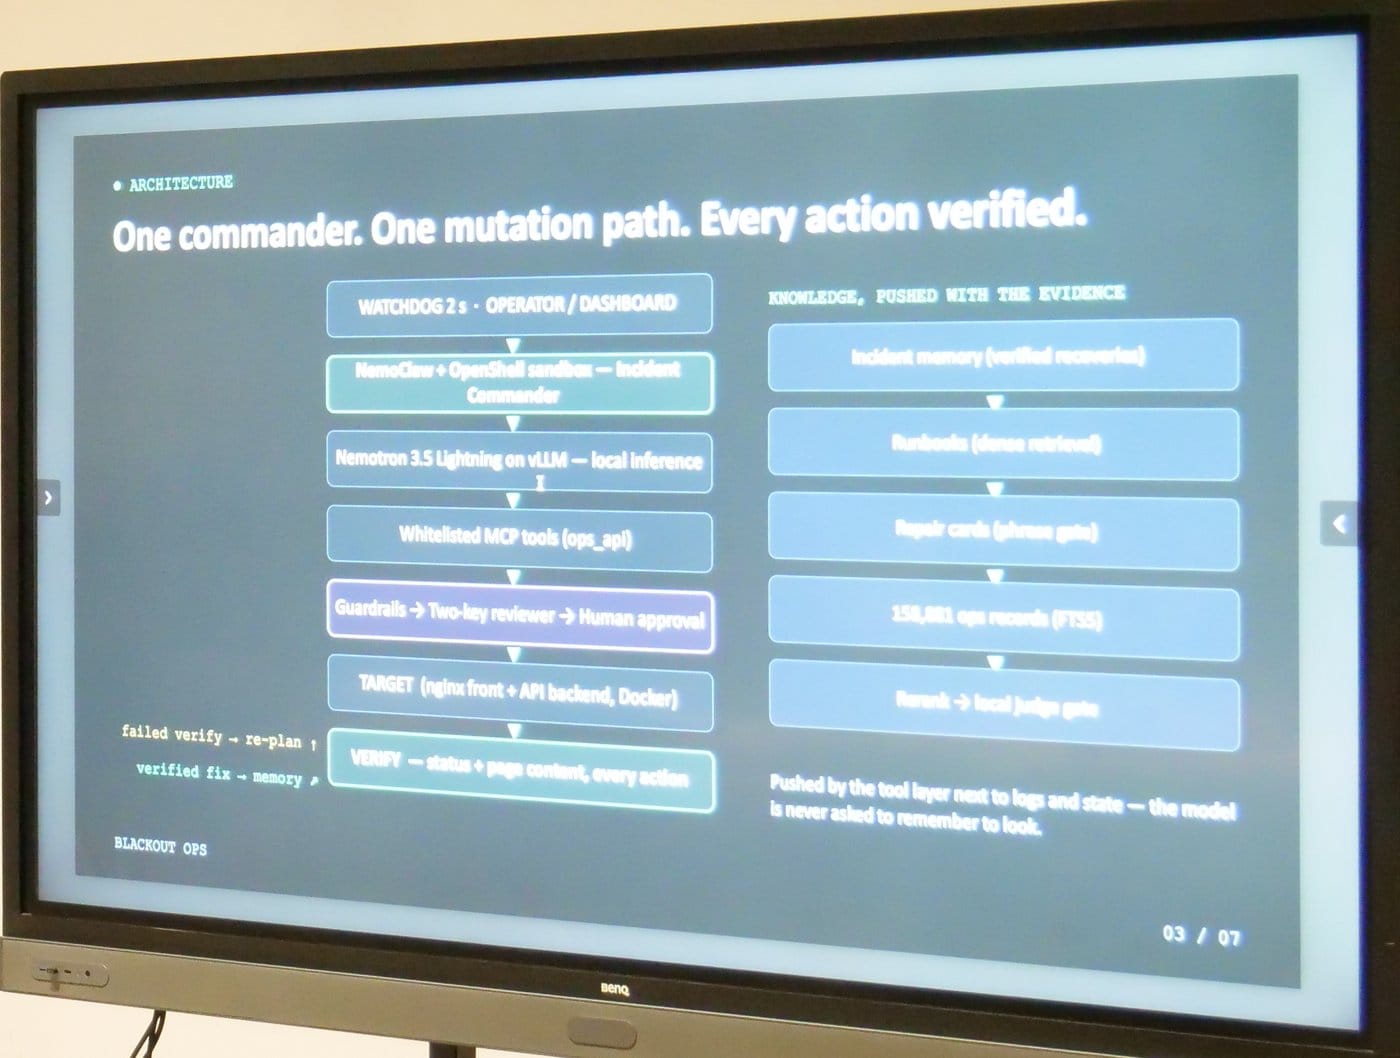
在和團隊聊天時,他們分享了一個非常實用的效能細節:讓每次請求盡量共用相同的提示詞前綴(他們提到的比例是 76%),減少 KV Cache 反覆計算與搬進搬出,系統長時間運行更穩定。vLLM 本身就有自動前綴快取的機制,在記憶體固定的邊緣主機上,這類調校往往決定一個 Agent 能不能整天不當機,非常細心。
ScanPilot:設備進場前,讓機器人先去量
現場唯一帶實體機器人上場的是 ScanPilot。它處理的是工廠或倉庫「設備進場前的空間評估」:新機台要搬進去前,得確認主要人行道至少 1.0 公尺、設備間通道至少 0.8 公尺、淨高 2.0 公尺等規範。現在多半靠人拿捲尺丈量、拍照、比對圖面,現場配置一改,就得重量一次。
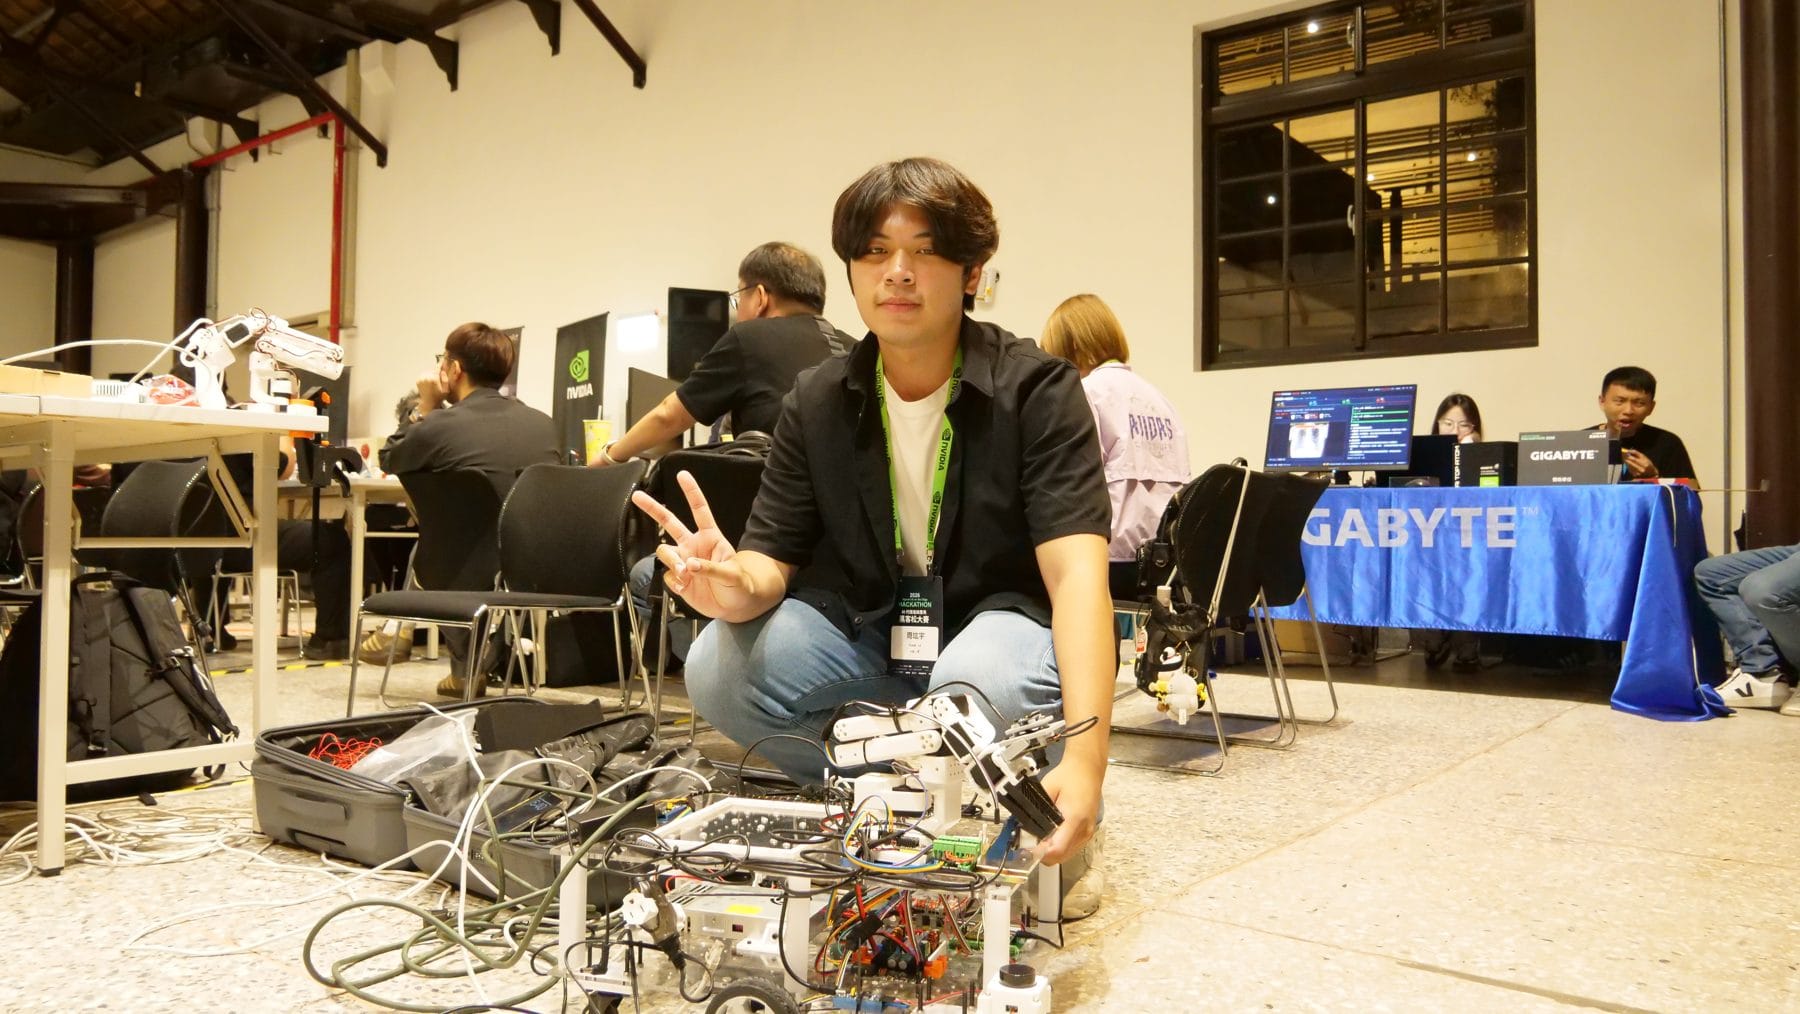
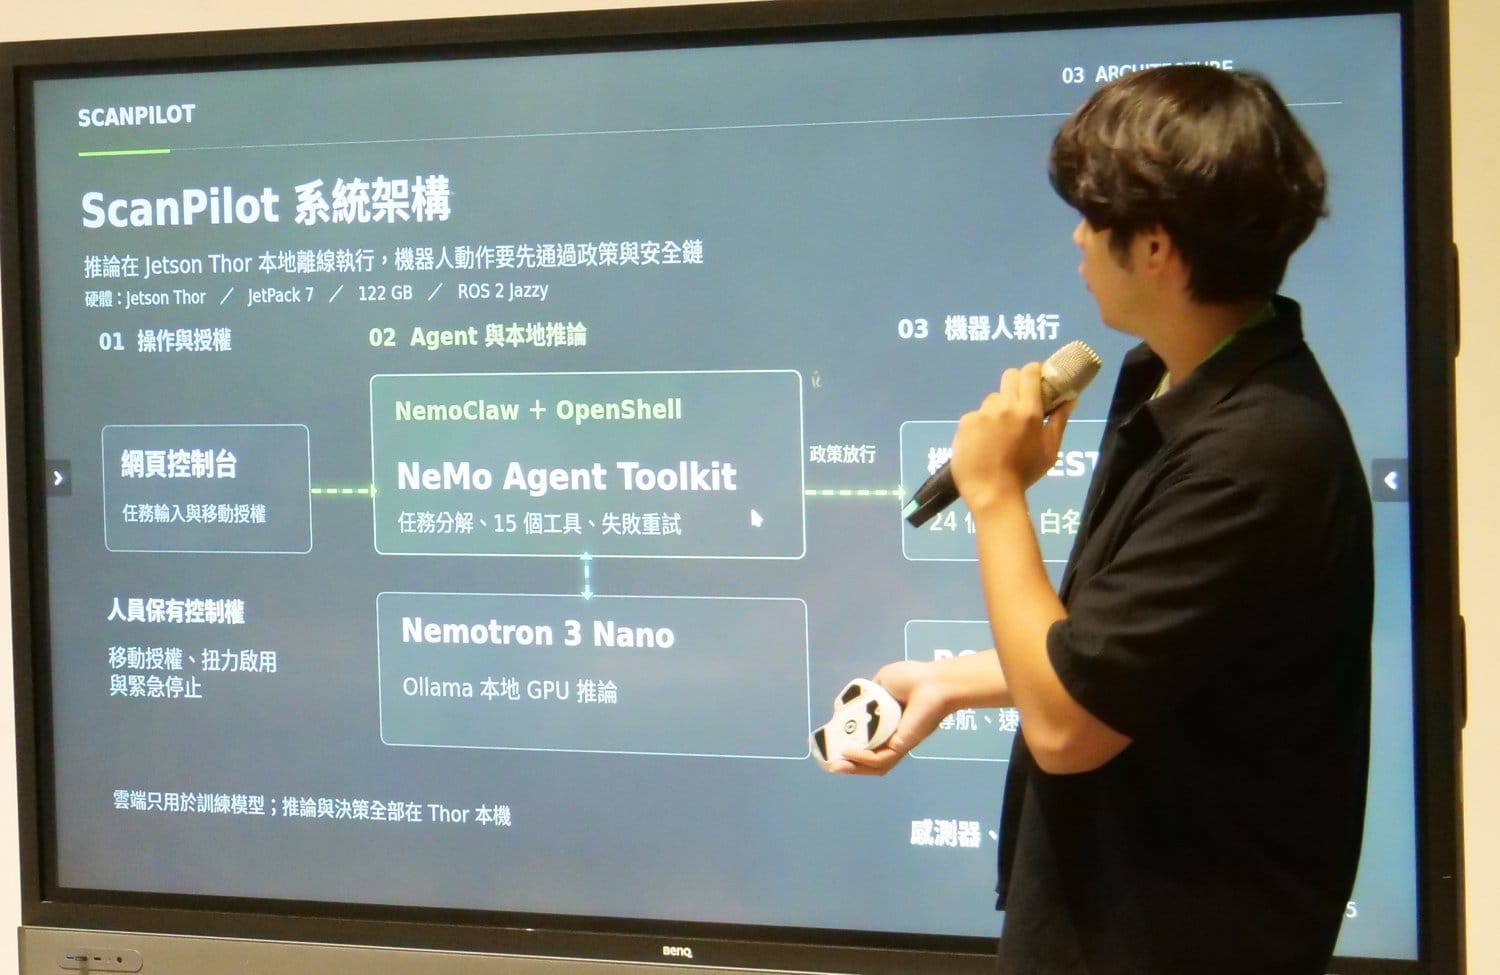
使用者只要在網頁控制台下一句話,例如「評估這裡能不能放進 3.6 × 2.05 公尺的設備」,Agent 就會自己拆解任務:掃描建圖、評估精度、精度不夠再補強、移動量測、重新評估,最後產出報告。機器人用深度相機(靠紅外線判斷遠近)掃出點雲,再靠地上的 AprilTag 定位標記知道自己的精確位置。遇到設備銘牌時,它會判斷拍攝角度是否太斜,移到銘牌正前方約 0.5 公尺再拍,交給視覺語言模型 Nemotron Nano VL 讀出上面的文字。

硬體是 NVIDIA Jetson Thor,Agent 用 NeMo Agent Toolkit 串起 15 個工具並處理失敗重試,語言模型則透過 Ollama 在本機 GPU 跑 Nemotron 3 Nano。雲端只用來訓練模型,推論與決策全部在 Jetson Thor 本機完成。機器人的動作要先通過政策檢查才會放行,移動授權、扭力啟用與緊急停止,控制權都留在人手上。
T-Agent:在 LINE 群組裡稽核機場作業
第四組把題目放到機場地勤。T-Agent 以臺灣航勤的作業安全稽核為情境,介面直接做在 LINE 群組裡:督導人員上傳一段現場作業影片或多角度照片,系統就對照安全規範開始稽核,稽核人員不用守在螢幕前一格一格看錄影。
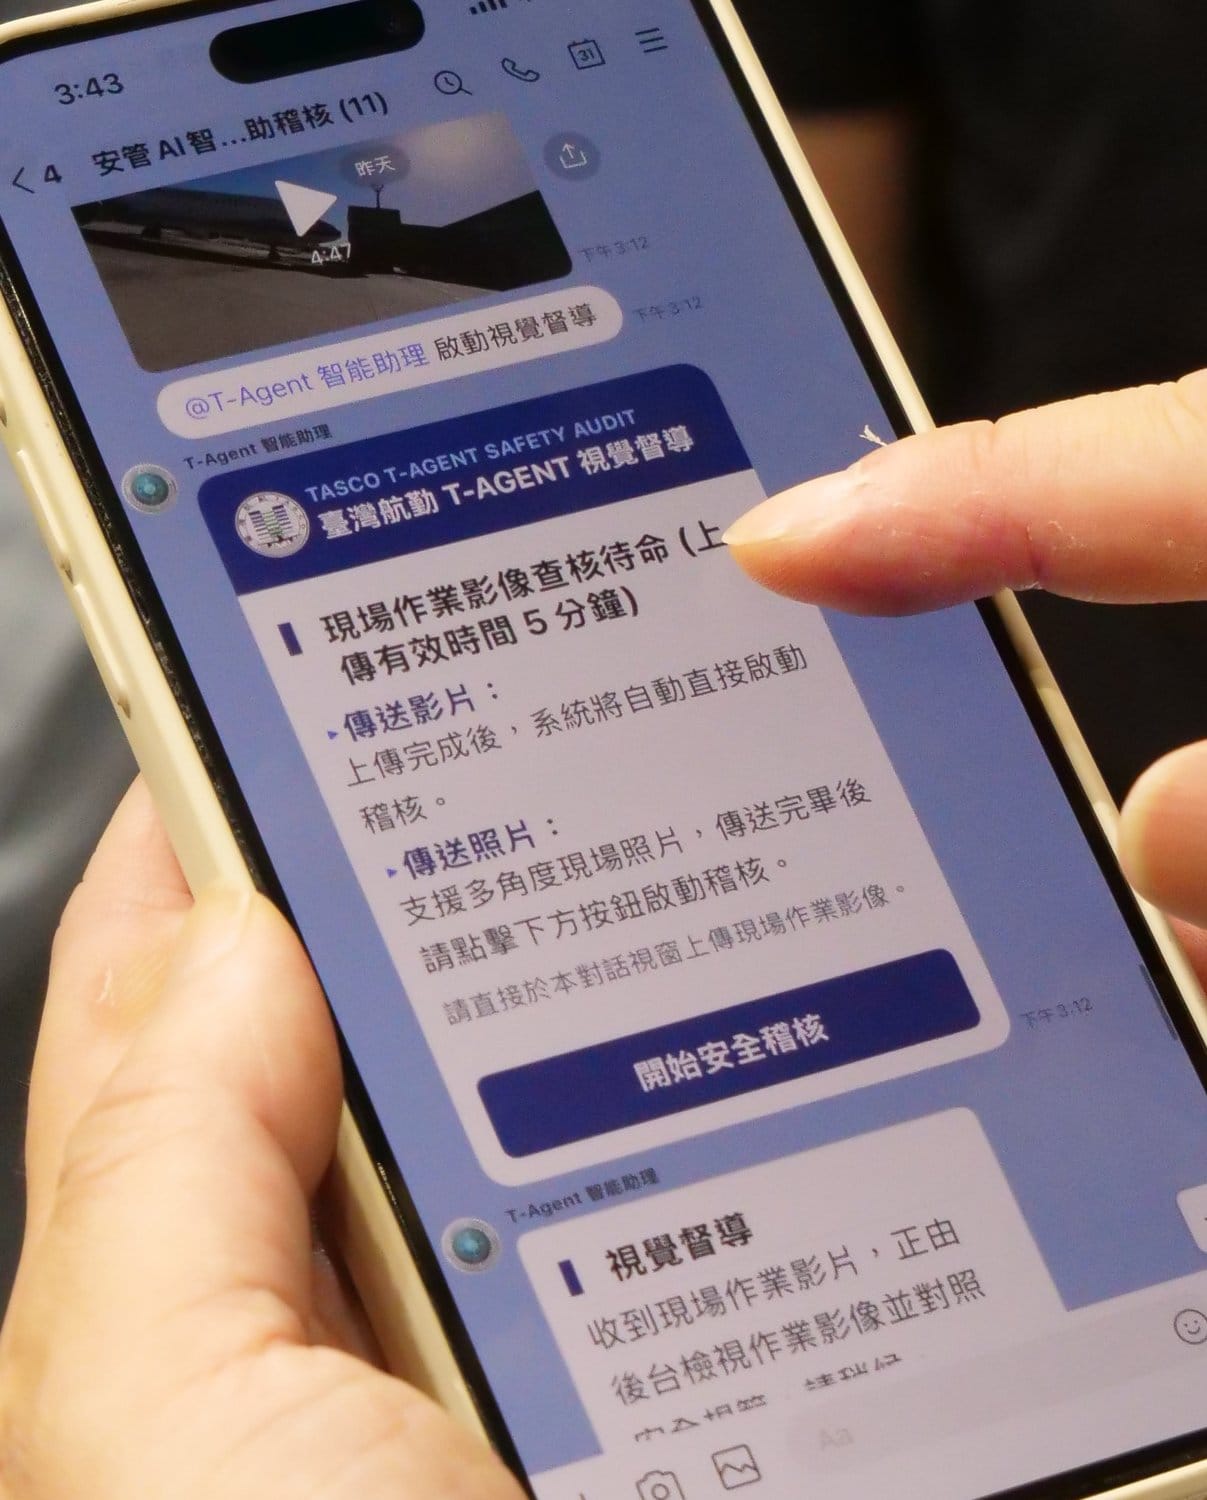
Demo 中,一段 4 分 47 秒的停機坪作業影片上傳後,T-Agent 回傳一份稽核通報:判定結果「建議改善」,綜合風險「中風險」,下面逐項列出時間區段與理由。例如 00:00 到 03:00,滾帶車進場靠機時的煞停與視角盲區,畫面沒有完整拍到二次煞停與手勢確認,列入疑似風險示警;02:55 到 04:49,作業人員在行李車與滾帶車之間的狹窄空間傳遞行李,有肌肉負擔與防夾風險;人員防護具則判定齊全,現場也有紅帽督導。
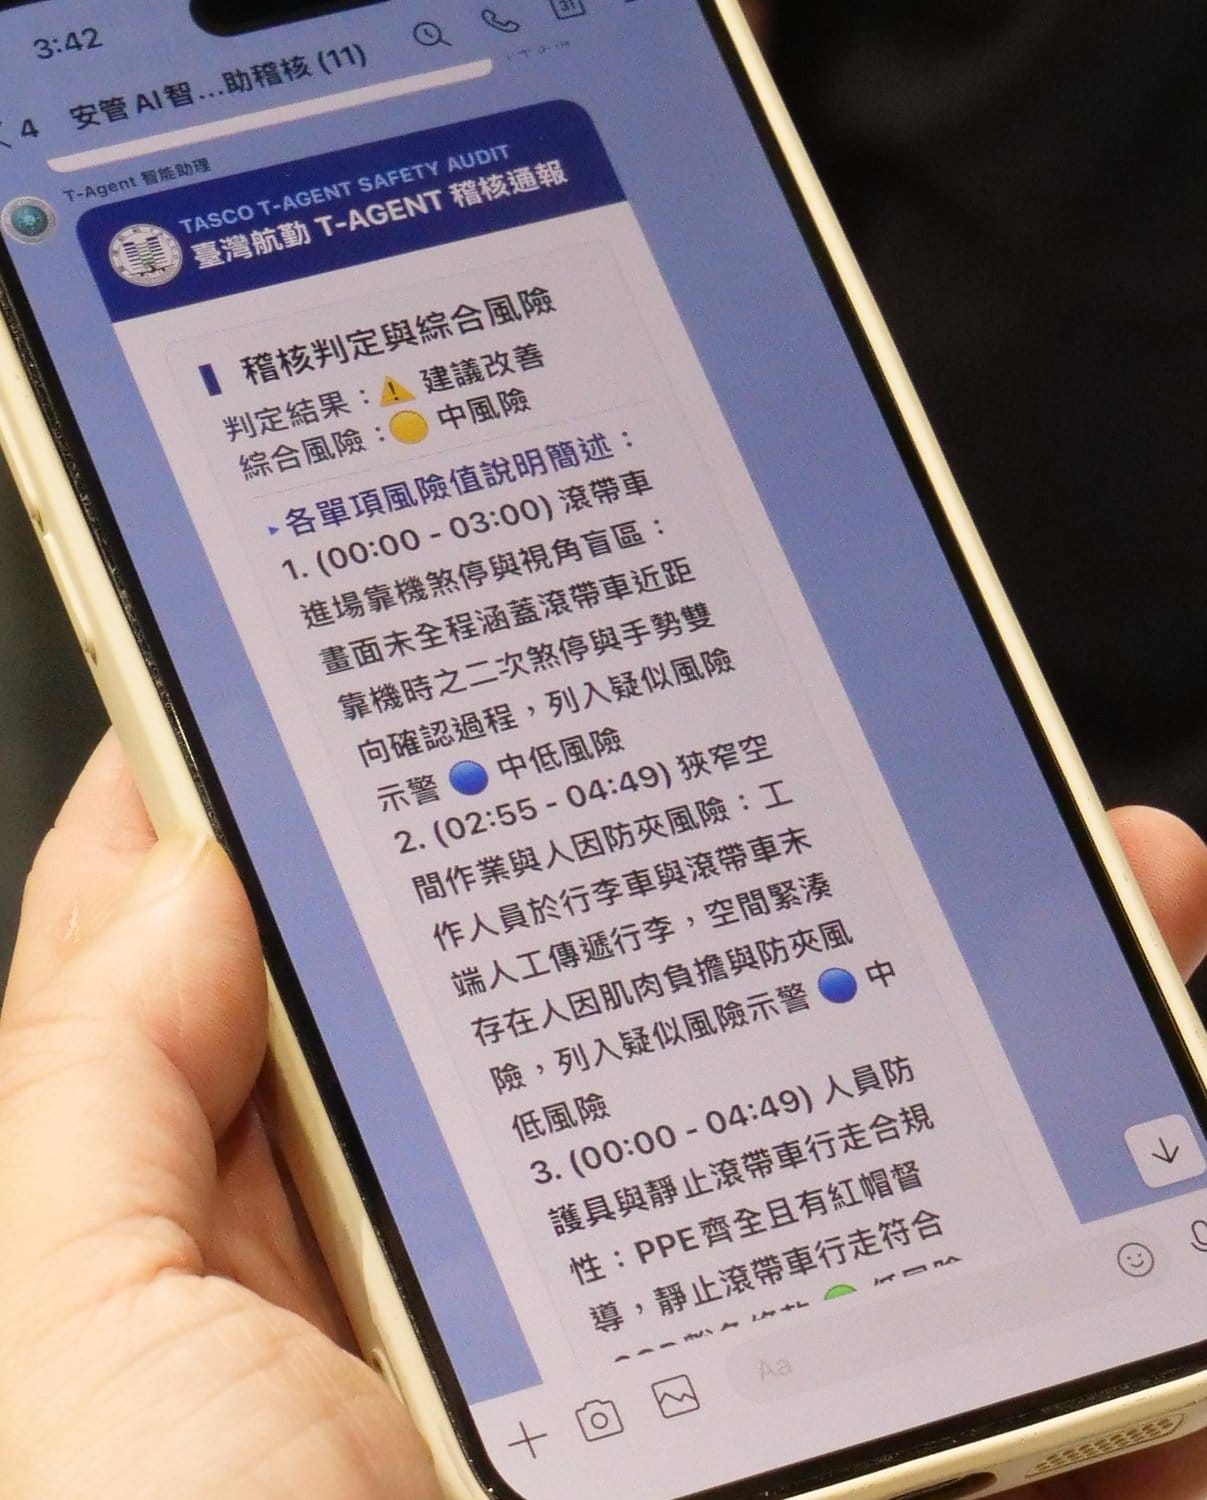
團隊表示,他們針對機場特有的載具與物件(滾帶車、行李車、防護具等)做了訓練,讓邊緣端模型在這個場景下判斷得比通用雲端 AI 更準。這也點出邊緣 AI 的一種打法:模型放不大,就讓它在一個領域裡變得很專。
邊緣 AI 代理能強到哪?四組給的答案
回到一開始的問題。從這四組的 Demo 來看,一台現場主機上的 AI 代理已經能邊聽邊填急診表單、讀日誌修好斷線的產線服務、自己掃描空間並讀出設備銘牌,還能逐段稽核一支近 5 分鐘的停機坪作業影片。撐起這些能力的積木,多半是公開可取得的開源專案與開放模型:NVIDIA Nemotron 系列模型、vLLM、Ollama、ROS 2、NVIDIA NemoClaw、NeMo Agent Toolkit。各隊花力氣的地方,是把這些積木接到自己熟悉的場域,再針對場域資料調校。
四組設計上也有一條共同的線:AI 可以自己看、自己判斷、自己動手,但關鍵動作都設了一道人的關卡。triAIge 的檢傷建議要醫護人員按下確認;Blackout Ops 的修復要過防護規則、雙重審查與人工核准;ScanPilot 的移動與扭力要人授權;T-Agent 的結果寫成「建議改善」「疑似風險示警」,交給督導判斷。如果你正在評估把 Agent 帶進工廠、醫院或作業現場,這四組的架構圖可以當成一份檢查清單:資料留在哪裡、Agent 能碰哪些工具、哪一步一定要由人按下去。開源生態只要繼續生生不息,下一屆隊伍手上的積木只會更多。