Exa 3.0 是什麼?Lite、Auto 價格與基準測試條件,AI 搜尋 API 怎麼選
Exa 3.0 把搜尋 API 分成 Lite 與 Auto,官方稱在各基準排名第一。本文整理價格、測試條件、Dynamic Highlights 與資料範圍,並說明哪些成績是 Exa 自己測的,導入前該怎麼用自己的查詢驗證。

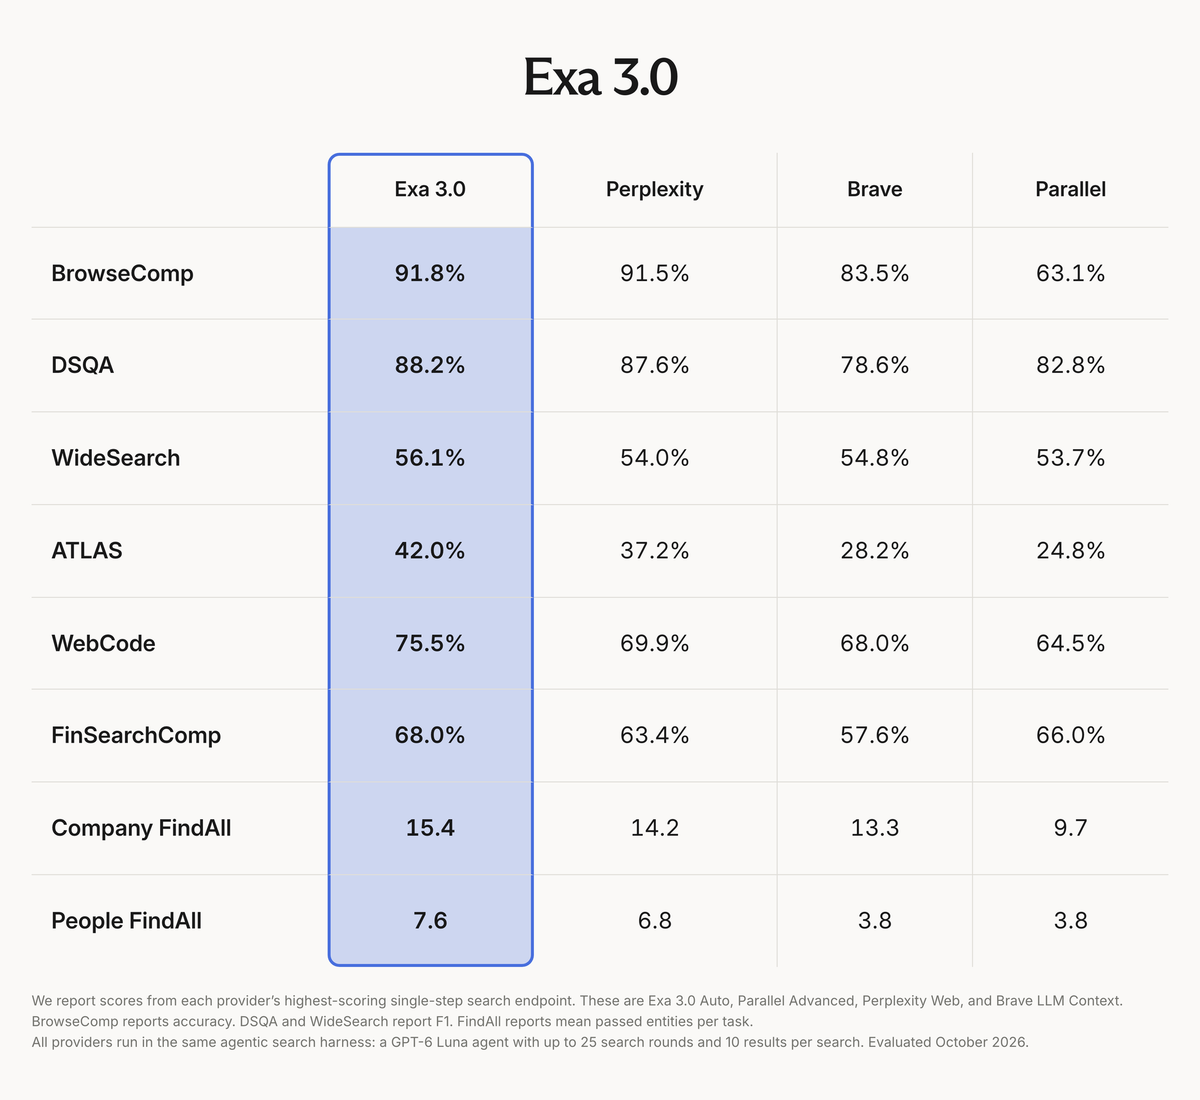
Exa 3.0 在 2026 年 10 月 19 日發表時,官方在 X 上寫了一句話:Exa 在自己測試過的每個基準都是第一。這則貼文在台灣時間 10 月 20 日凌晨發出,查詢時約有 1,049 個讚,不過熱度只是線索,不是評測結果。
AI 代理要查資料時,背後多半接著一個搜尋 API。它回傳的不是十條藍色連結,而是整理過的網頁內容,讓模型直接閱讀,所以搜尋層的好壞會直接影響答案品質與帳單。
很多人會把「每個基準都第一」讀成「Exa 是目前最好的搜尋」,但官方部落格的圖表交代了條件。這份成績單由 Exa 自己發布,官方沒有說明有第三方參與。
對手是 Perplexity、Brave 與 Parallel,而且全部放進同一個以 GPT-6 Luna 驅動的搜尋代理裡。
排名的差距也不一樣大。BrowseComp 上 Exa 3.0 只領先 Perplexity 0.3 個百分點,Exa 自己建立的 ATLAS 基準卻領先 4.8 個百分點,兩種差距的意義並不相同。
對開發者更實際的消息,是這次同時推出 Lite 與 Auto 兩種搜尋類型,每千次請求分別是 4 美元與 7 美元,另外還有讓模型少讀無關內容的 Dynamic Highlights。這些改動直接決定代理跑一次任務要花多少錢。
我的判斷是,Exa 3.0 適合正在做研究型代理、名單蒐集或檢索增強問答的團隊,值得拿自己的查詢測一輪。檢索增強問答就是先搜尋資料,再讓模型依資料作答。至於需要獨立第三方評測才能採購的公司,目前還不適合直接照官方排名決定。
要判斷值不值得測,得先搞清楚 Exa 3.0 到底改了哪些東西。
Exa 3.0 是什麼?官方這次改了檢索模型、搜尋類型與資料範圍
Exa 3.0 是 Exa 搜尋 API 的新一代版本,官方稱它是 Exa 有史以來最大的搜尋品質改進。
Exa 是替 AI 應用提供網路搜尋的公司。依官方說明,它自己運行爬蟲、維護獨立的索引,因此 3.0 的改動可以從索引、模型一路看到計價。
先看檢索模型。官方表示,3.0 用比以往任何模型更多的算力與資料,訓練了更大的嵌入模型。嵌入模型會把文字轉成一串數字,讓程式比較兩段內容的意思有多接近,所以它決定了搜尋結果找得準不準。
搜尋類型也變了。新增的 Lite 主打低成本與低延遲,Auto 則花更多運算處理候選結果、摘錄與排序,兩者共用同一份索引。依 API 文件,Auto 仍是預設類型。
Dynamic Highlights 則從研究預覽轉為正式提供,官方表示不另外收費。它的做法會在後面的小節細談。
資料範圍也擴大了。官方稱 Exa 追蹤超過 2 兆個網址,提供 1,000 億個頁面,新增 12.7 億筆含價格與庫存的電商商品,以及超過 2.11 億個含營業時間與評價的在地商家,另外還有即時新聞、體育、天氣與市場資料。
這些改動多半是官方自己的描述,部落格沒有附上可重現的實驗細節,所以目前只能當作產品規格。最受矚目的「各基準第一」,則要拆開來看才讀得懂。
Exa 3.0 各基準第一怎麼讀?先看測試條件與差距
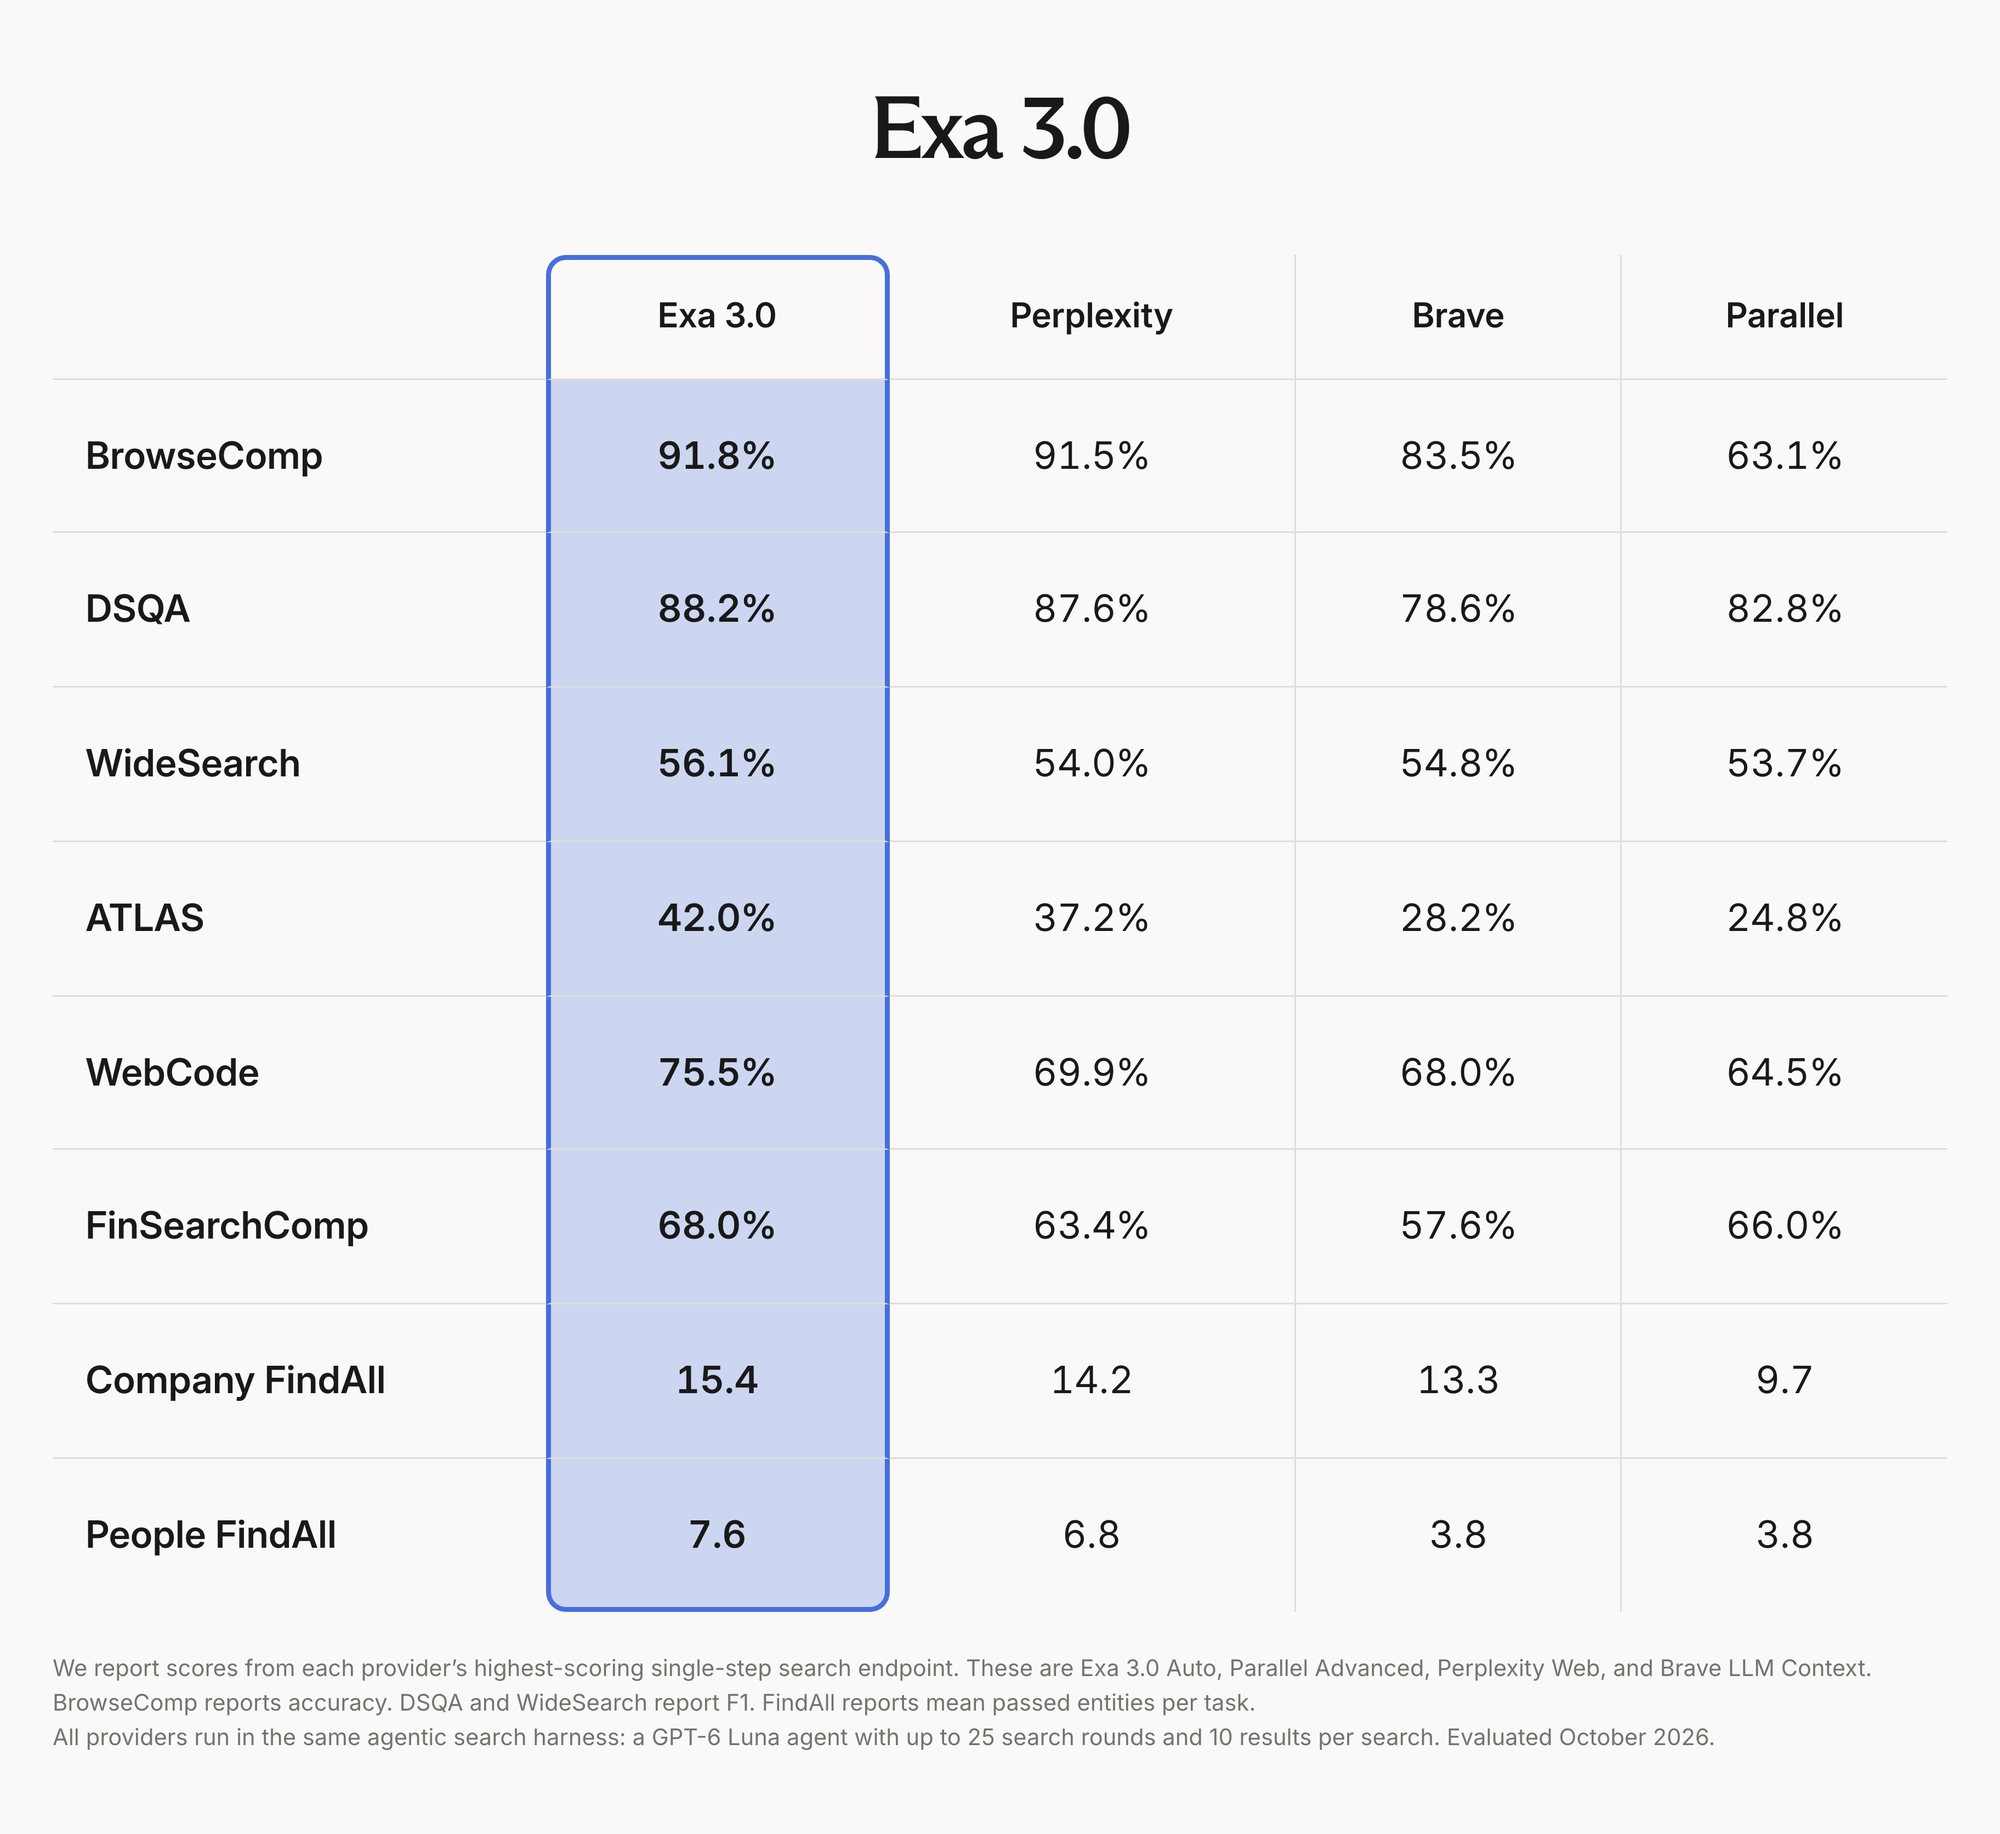
Exa 3.0 在官方圖表的八個基準都排第一,但測試條件由 Exa 設定,領先的幅度也很不平均。
以下把官方圖表上的分數整理成表格,數字都來自 Exa 的 3.0 發表文章,不是獨立測試。Exa 3.0 一欄使用的是 Exa 3.0 Auto。
| 基準 | Exa 3.0 | Perplexity | Brave | Parallel |
|---|---|---|---|---|
| BrowseComp | 91.8% | 91.5% | 83.5% | 63.1% |
| DSQA | 88.2% | 87.6% | 78.6% | 82.8% |
| WideSearch | 56.1% | 54.0% | 54.8% | 53.7% |
| ATLAS | 42.0% | 37.2% | 28.2% | 24.8% |
| WebCode | 75.5% | 69.9% | 68.0% | 64.5% |
| FinSearchComp | 68.0% | 63.4% | 57.6% | 66.0% |
| Company FindAll | 15.4 | 14.2 | 13.3 | 9.7 |
| People FindAll | 7.6 | 6.8 | 3.8 | 3.8 |
表格裡 BrowseComp 與 DSQA 的領先幅度只有 0.3 與 0.6 個百分點,WideSearch 對 Brave 也只多 1.3 個百分點。官方圖表沒有提供重複測試次數或誤差範圍,很難判斷這是真的領先,還是正常波動。
相對地,ATLAS 領先 4.8 個百分點、WebCode 領先 5.6 個百分點,差距大得多。
但 ATLAS 是 Exa 在 10 月 8 日自己推出的基準,官方稱它仍是預覽版。題目、標準答案表與評分程式要幾週後才公開,外部團隊目前無法重跑。
測試條件寫在圖表底部。每一家都用自己表現最好的單步搜尋端點,也就是 Exa 3.0 Auto、Parallel Advanced、Perplexity Web 與 Brave LLM Context。
這些端點全部放進同一個搜尋代理,由 GPT-6 Luna 擔任,最多搜尋 25 輪,每輪取 10 筆結果,評測時間在 2026 年 10 月。
指標也不一致。BrowseComp 看答對率,DSQA 與 WideSearch 看 F1 分數,也就是同時顧及找得準與找得全的綜合分,FindAll 則是每個任務平均通過的項目數。
ATLAS、WebCode 與 FinSearchComp 的指標,圖表沒有註明。所以同一列之內可以比,不同列之間不能直接比。
前三列的差距特別小,Exa 自己在 ATLAS 說明文章裡給了原因。
Exa 統計,BrowseComp、WideSearch 與 DeepSearchQA(圖表簡稱 DSQA)分別有 48%、59%、61% 的題目,至少有一個前沿模型能靠記憶答對。
Exa 還做了一個實驗:把每次搜尋前 10 筆裡的前 7 筆藏起來,這三個基準仍保有原分數的 81% 到 89%,ATLAS 則掉了約一半。
這是 Exa 為自家基準提出的論點,沒有獨立驗證,但至少說明 0.3 到 1.3 個百分點的領先,很難直接當成搜尋品質的證據。
所以這張表更適合讀成「Exa 在自己測試台上的表現」,而不是產業共同認定的排名。
評測只能當參考,那就得回到帳單,因為 Lite 與 Auto 的價格差異是最容易自己驗證的部分。
Exa 3.0 Lite 與 Auto 怎麼選?價格、延遲與限制
Lite 適合成本與速度優先的場合,Auto 則是需要較完整結果時的預設選擇。
官方定價頁列出每千次請求的價格,延遲來自官方搜尋 API 使用指南,文件說明這些數字是近似值,兩者整理如下。
| 搜尋類型 | 每千次請求價格 | 文件列出的典型延遲 | 文件建議情境 |
|---|---|---|---|
| lite | 4 美元 | 約 450 毫秒 | 高流量、即時應用 |
| auto | 7 美元 | 約 1 秒 | 預設,多數搜尋 |
| deep-lite | 12 美元 | 約 4 秒 | 輕量研究與整理 |
| deep | 12 美元 | 4 至 15 秒 | 多步驟研究 |
官方文件寫明,Lite 只提供快取內容。快取就是 Exa 先存好的頁面副本,所以要求全文或摘錄時,若某個頁面沒有副本,那筆結果會被捨棄。
它也不接受 outputSchema、systemPrompt 與 contents.maxAgeHours 等參數,帶了這些參數會收到 400 錯誤,需要這些功能就得改用 Auto。
這代表 Lite 的低價有代價:頁面內容可能不是最新的。需要即時新聞或剛更新的價格時,應改用 Auto 並調整 maxAgeHours,再判斷省下的錢值不值得。
成本方面,官方效率圖顯示 Lite 約 79 分、每個任務約 0.045 美元,Auto 約 80.5 分、約 0.065 美元。圖中 Perplexity 的兩個設定約在 79 到 80 分,每個任務約 0.07 美元。
這張圖的「代理搜尋分數」怎麼計算,官方沒有說明,每任務成本是否包含模型費用也沒有寫,所以只能拿來看相對位置。
照官方圖上的約略數字,Lite 比 Auto 每個任務省約 0.02 美元,分數少約 1.5 分。這個差距對每天跑幾百次的代理很小,但每天跑一百萬次任務就會變成約兩萬美元,所以要用自己的流量去算。
新帳號可得到 10 美元額度,不需綁定付款方式,官方稱足夠做 2,500 次 Lite 搜尋,額度在每月 1 日重設為 10 美元。對想先試的人,這是成本最低的驗證方式。
另外,fast、instant 與 deep-reasoning 被列為舊類型。依 10 月 19 日的更新日誌,它們仍可使用,價格不變,所以現有專案不必急著改。
價格與延遲之外,3.0 還有一個直接影響詞元用量的功能,就是 Dynamic Highlights。
延伸閱讀:Cloudflare Web Search API 開放測試:讓 AI 代理用即時網路資料回答
Dynamic Highlights 是什麼?只送必要段落給模型,能省多少詞元
Dynamic Highlights 讓搜尋 API 只回傳最相關的段落,而不是整頁文字,因此能降低送進模型的詞元數量。
詞元是模型計費與讀取內容的單位,一段文字會被切成許多詞元。送進去的網頁愈長,費用愈高,模型也愈容易被無關內容干擾。
一般的摘錄功能是逐頁處理,每個網頁各自挑出幾段。Dynamic Highlights 則把所有結果合併成一份文件,一次判斷哪些詞元最有用,因此能把篇幅分給品質較好的來源,重複的資訊也比較容易被刪掉。
官方 8 月 28 日的研究預覽文章給了三組數字,都是 Exa 自己的內部測試。相比整頁文字,平均減少 95% 的詞元。
在單次檢索增強問答、12,000 字元預算下,比標準摘錄多約 40% 的詞元效率,品質提高 3.8%。在代理式搜尋裡,代理詞元少用約 30%,品質平均提高 2.1%。
這些數字各有條件,官方也提醒節省幅度會依任務而異,因為代理的推理過程常占一半以上的詞元用量。所以它對搜尋結果很長、重複內容很多的任務效果較大,對推理占大宗的任務就比較有限。
使用方式很簡單,在請求的 contents 底下,把 highlights 的 dynamic 設為 true。以下是依官方文件整理的最小範例,包含文件要求的測試標頭:
curl -s -X POST "https://api.exa.ai/search" \
  -H "Content-Type: application/json" \
  -H "x-api-key: $EXA_API_KEY" \
  -H "Exa-Beta: dynamic-highlights-2026-08-28" \
  -d '{"query": "你的查詢", "type": "auto", "numResults": 10,
       "contents": {"highlights": {"dynamic": true}}}'
發表文章與文件在這裡有出入。3.0 發表文章說 Dynamic Highlights 已正式提供,但 10 月 20 日查詢時,API 參考頁仍把 dynamic 標為測試功能,要求加上 Exa-Beta 標頭。
文件也註明它不能和 maxCharacters 同時使用,所以實際使用前,要以當天的文件為準。
摘錄只處理「找到之後」的問題,真正決定代理能找到什麼的,還是索引裡有哪些資料。
資料範圍擴張:商品、商家與即時資料適合做哪些搜尋工作
這次擴張讓 Exa 能回答「有哪些商品、哪些店、現在的行情」這類結構化問題,不再只是找文章。
官方 Library 頁列出 20 個資料集合,包含人物 3.2 億頁、公司 3,300 萬頁、商品 12 億頁、在地商家 2.1 億筆、研究論文 5 億頁、SEC 申報文件 1,900 萬份與 Podcast 300 萬集。
發表文章的數字略有不同,例如電商商品寫 12.7 億筆,官方沒有說明兩者差異的原因。
對一般開發者,最直接的用途是名單蒐集與市場研究。官方頁面舉的例子是找出某區有戶外座位的深夜拉麵店,這類查詢過去常需要自己串好幾個資料來源。
但資料多不等於每筆都對。商品價格與庫存會變,商家營業時間會調整,Lite 又只提供快取內容。所以涉及交易或到店的應用,要把資料時間顯示給使用者,並在關鍵步驟回到原始網頁確認。
人物與公司類資料也要留意用途。官方稱這些結構化頁面來自公開與授權的紀錄,但能不能用在行銷名單、是否符合個資規範,要看你所在地區的法規與自己的用途,這不是搜尋 API 本身能替你判斷的事。
FindAll 的分數單位是每個任務平均通過的項目數,不是百分比,所以 15.4 與 7.6 不能直接當成準確率,只能用來比較不同服務在同一組任務上的相對表現。
看完功能與資料,下一步是判斷這套服務適不適合你的專案。
適合誰、不適合誰:導入 Exa 3.0 前的驗證清單
Exa 3.0 適合已經有搜尋需求、而且願意花一個下午用自己的查詢做比較的團隊。
具體來說,做研究型代理、潛在客戶名單、競品追蹤,或在檢索增強問答裡需要乾淨網頁摘錄的開發者,最可能從 Auto 與 Dynamic Highlights 受益。流量大又重視延遲的聊天、語音或自動完成功能,則值得測 Lite。
不適合的情況也很明確。如果公司規定採購必須有獨立第三方評測,目前只有 Exa 自己的數字,還不夠。如果任務高度依賴最新資訊,Lite 的快取限制也會成為問題。
建議先準備 30 到 50 條真實查詢,涵蓋簡單問題、需要多步驟的問題與你最在意的資料型態。同一個代理程式固定不動,只更換搜尋端點,分別跑 Auto、Lite 與現在使用的服務。
記錄三件事就夠了,也就是答案是否正確、引用的來源是否真的支持答案,以及每個任務的總成本與時間。我認為來源是否支持答案,比單一分數更能看出搜尋品質。
若結果和官方表格方向一致,再逐步擴大流量。若不一致,原因常出在查詢類型不同,例如你的任務偏中文、偏在地或偏冷門網站。官方沒有說明各基準的語言與題型分布,所以你的任務未必被涵蓋。
即使驗證通過,也有幾個風險要事先知道。
Exa 3.0 的限制與風險:評測、依賴與成本
目前最大的限制是證據來源單一,大部分數字都出自 Exa 自己的文章與圖表。
ATLAS 的設計、執行與發表是同一家公司。Exa 在 ATLAS 說明中也寫到,答案表由自動化流程建立,抽樣審核估計錯誤的標準答案不到 1%,另有 7.1% 的欄位因無法判定而未評分。這些做法算透明,但仍屬廠商自述。
官方也說正在對抽樣題目做盲測人工審核,標準是 99% 的標準答案正確。審核結果出來之前,ATLAS 的排名最好只當方向參考。
其次是供應商依賴。把搜尋層綁在單一 API 上,價格、速率限制或索引政策改變時,代理的行為也會跟著變。可行的做法是把搜尋呼叫包成一層自己的介面,保留切換到其他服務的空間。
第三是成本會隨用法放大。Auto 每千次 7 美元看似不多,但代理一次任務常呼叫多次搜尋。每次請求的基本價只含 10 筆結果,超過的部分每千筆另加 1 美元,AI 頁面摘要也是每千頁 1 美元,總額要用實際流量估算,而不是只看單次價格。
官方另外安排了線上問答,時間是 10 月 21 日美西時間下午 1 點,也就是台灣時間 10 月 22 日凌晨 4 點,由產品與研發負責人回答問題。想知道評測細節的人,可以留意是否有補充說明。
延伸閱讀:Keenable 是什麼?獲 2,600 萬美元投資,要替 AI Agent 重做網路搜尋
Exa 3.0 常見問題
Exa 3.0 是新的 API 還是新的模型?
兩者都有改動。檢索模型與索引是新的,API 端點仍是原本的搜尋請求,預設類型維持 Auto,Lite 則是新增的 type 值。
Exa 3.0 的 Lite 和 Auto 可以混用嗎?
可以。從文件看,type 是每次請求自己設定的參數,所以同一個專案能依情境切換,例如聊天這類即時流程用 Lite,背景的研究任務用 Auto。
官方說各基準第一,可以直接相信嗎?
可以當作廠商的測試結果,但不宜直接當成獨立排名。成績單由 Exa 自己發布,其中 ATLAS 又是 Exa 自己建立且尚未公開,所以最好用自己的查詢再驗證一次。
Exa 3.0 有免費額度可以試嗎?
有。依定價頁,新帳號有 10 美元額度,不需綁定付款方式,官方稱足夠做 2,500 次 Lite 搜尋,並在每月 1 日重設。
結語:先用自己的查詢測一輪,再決定要不要換搜尋 API
Exa 3.0 最確定的進展在產品面,包括 4 美元的 Lite、能降低詞元用量的 Dynamic Highlights,以及更廣的資料範圍。最不確定的是「各基準第一」,因為目前沒有獨立團隊重現。
如果你正在替代理挑搜尋層,建議先申請免費額度,用自己的 30 條查詢比較 Auto 與 Lite。如果只是想了解趨勢,可以把這次發表當成訊號:搜尋 API 正從回傳連結,走向回傳模型剛好需要的內容。
想持續追蹤 AI 搜尋、代理與開發工具的官方更新,可以免費訂閱 AI 郵報,後續更新會以官方文件為準。
資料來源
- Exa 官方部落格,Introducing Exa 3.0:https://exa.ai/blog/exa-3
- Exa 官方部落格,ATLAS 評測說明:https://exa.ai/blog/atlas-benchmark
- Exa 官方部落格,Does the AI world really need another search benchmark:https://exa.ai/blog/another-search-benchmark
- Exa 官方部落格,Dynamic Highlights:https://exa.ai/blog/dynamic-highlights
- Exa 官方定價頁:https://exa.ai/pricing
- Exa 搜尋 API 文件:https://exa.ai/docs/reference/search
- Exa 搜尋 API 使用指南(搜尋類型與 Lite 參數限制):https://exa.ai/docs/reference/search-api-guide-for-coding-agents
- Exa API 更新日誌:https://exa.ai/docs/changelog
- Exa Library 資料集合:https://exa.ai/library
- X 熱度線索,Exa 官方帳號貼文:https://x.com/ExaAILabs/status/2112218730952601719