Gemini Voice Remixing 開放,如何用提示詞調整音色並保存配音版本?
Gemini Voice Remixing 已在 AI Studio 與 Gemini API 開放。本文說明基礎聲音、相對提示詞、新聲音 ID、Flash 與 Lite 合成差異,以及付費資格、兩百個配額和一年保存期限。

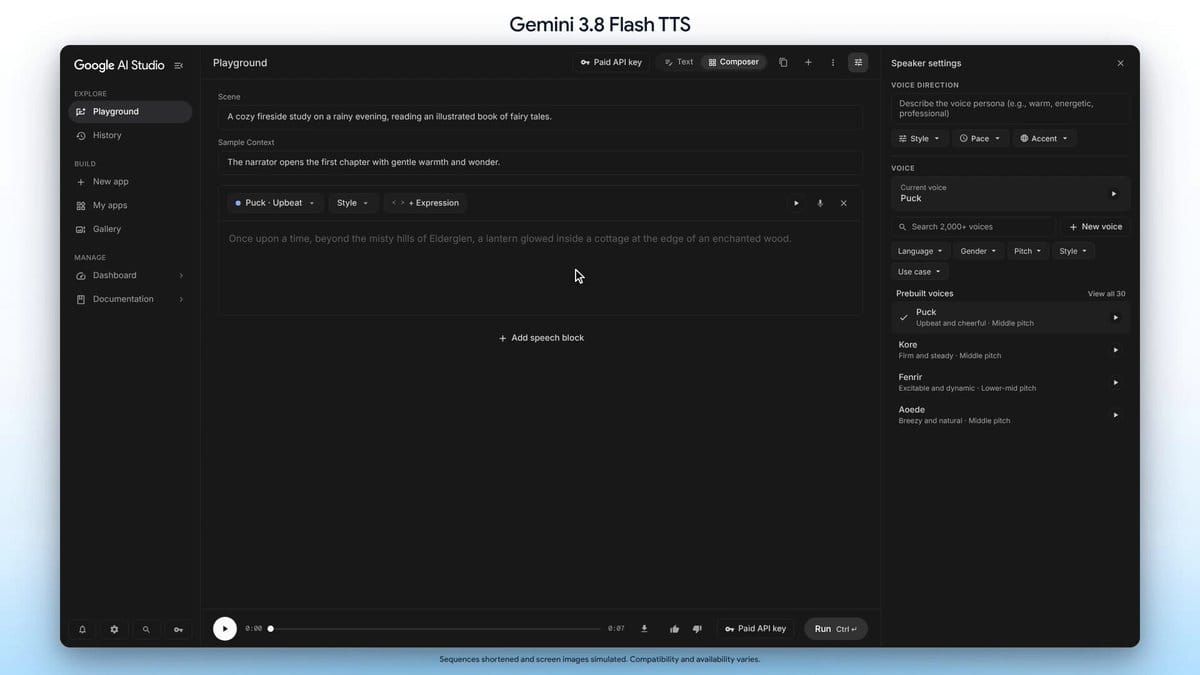
替系列影片挑好配音後,創作者常常只想調整一點速度或音色。
Google 在二〇二六年十一月四日宣布,Gemini 3.8 Flash TTS 的 Voice Remixing 已在 Google AI Studio 與可供程式呼叫的 Gemini API 介面開放。
使用者可以從現有聲音出發,用文字描述希望改變的特徵。
這項功能在九月的模型發布公告中還被列為即將推出,如今已有獨立文件說明操作。新聲音如何保存、哪些模型可以使用,以及付費資格與專案配額,都是持續製作配音時會遇到的條件。
我會先固定一份試聽稿,每次只改一兩個特徵,讓聲音變化可以被比較。要做到這件事,首先得分清修改聲音本身與改變一句台詞表演的差別,再把滿意的版本放進後續作品。
Voice Remixing 和一般配音提示有何不同?
這項功能會建立新的聲音資源,讓調整後的角色能在後續稿件重複使用。官方文件把它描述為以自然語言修改既有聲音,再產生一個獨立保存的新聲音。修改可以針對音色、音高、年齡感、節奏、口音或聲音能量。
這和每次合成台詞時給一句「用興奮的語氣說」有所區別。角色的基礎音色可以長期保存,單句的表演則依當次內容調整。
官方建議,把角色較固定的特徵交給 Voice Remixing,把暫時的低語、興奮或其他逐句表演放在語音合成的風格設定。
例如系列節目希望旁白維持溫暖而沉穩的聲音,可以先建立適合的角色版本。當某一段劇情需要壓低音量或增加緊張感,再在那次朗讀設定表演。
這樣比較容易區分「換了一位說話者」和「同一位說話者換了情緒」,也比較方便團隊持續使用同一角色。
官方流程會保留原來的基礎聲音,並回傳新的聲音識別碼。也就是說,一次修改建立的是新資源,原始聲音不會被直接覆寫。若之後刪除基礎聲音,從它衍生出的聲音也不會因此自動消失。
這個設計有利於比較版本,但同時需要管理逐漸增加的聲音清單。
功能名稱中的 Remixing 也不等於任意複製真人聲音。文件列出的起點包含預設聲音、聲音資料庫,以及專案擁有的設計或先前重混聲音。
若要從真人參考錄音建立聲音,屬於另一項 Voice Replication 功能,必須另外確認其規則與權限。角色的固定特徵確定後,下一步就是選出適合當起點的基礎聲音。
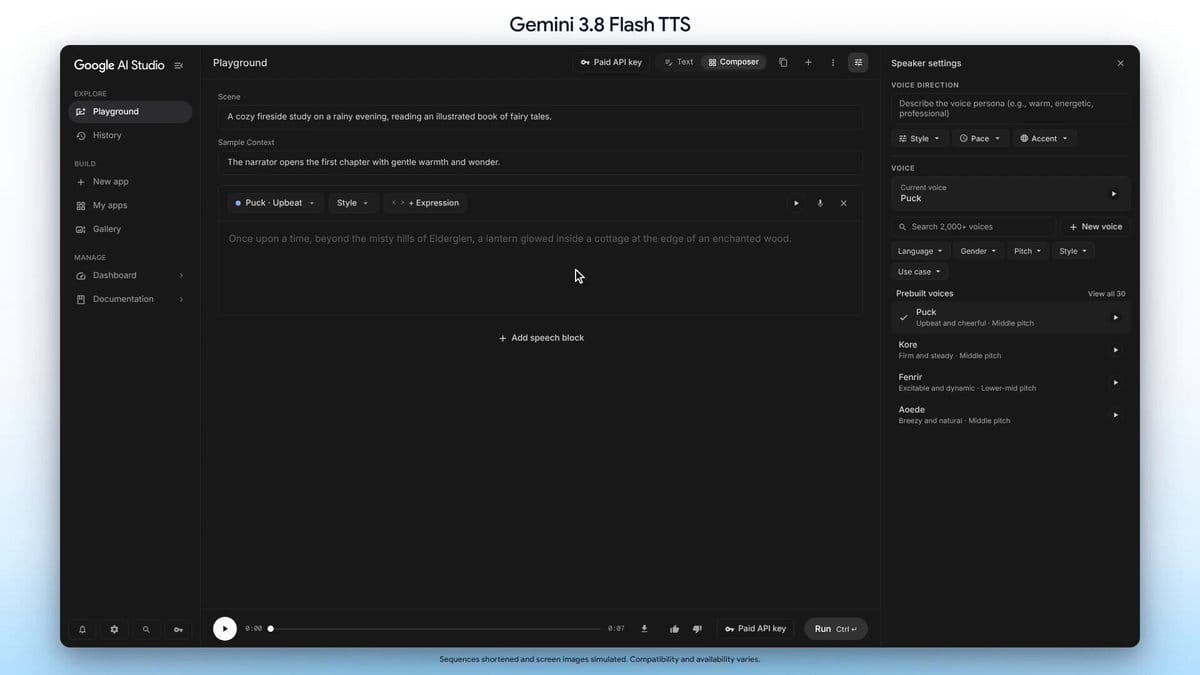
Voice Remixing for Gemini 3.8 Flash TTS is now live in @GoogleAIStudio and the Gemini API.
— Google (@Google) November 4, 2026
Start with a preset from our library of 2,000+ voices or a custom-designed voice, and use prompts to fine-tune timbre, pitch, pace, and accent, like "add a subtle Southern U.S. accent" or… pic.twitter.com/IixWu8wZV6
如何選擇基礎聲音與相對修改?
既有聲音提供一個可聽見的起點,修改指令只需描述希望發生的差異。Google 提供三十種預設錄音室聲音,也有超過兩千個聲音的資料庫。使用者還可以選擇自己專案裡已設計或已重混的聲音,繼續細調。
挑選起點時,我會先找最接近用途的聲音,再決定要改哪一部分。若原始聲音的節奏、清晰度與角色感都很合適,只需要稍微降低音高,就沒有必要在一輪要求裡重新描述整個人物。這符合官方文件所建議的相對修改方式,也讓試聽比較更直接。
例如可以要求「保留原本親切的感覺,放慢節奏,讓聲音稍微低一些」。這是一個製作示例,不代表我們已經實際測得模型會如何表現。若希望改口音,應明確指定。依文件說明,沒有要求改變時,系統預設會保留基礎語言與地區口音。
一次修改一兩項特徵,有助於辨識差異。如果同時要求更年輕、更低沉、更快速、換成另一種口音,又要保留原本角色,就可能難以判斷最後是否符合需求。先試聽一個小幅版本,確認方向後再往下一輪調整,比較容易知道哪一步造成變化。
台灣創作者還應特別檢查中文發音、專有名詞與語句節奏。官方範例包含英語口音與角色聲音示範,但本文沒有自行測試所有語言,也沒有把自然語言可調整功能當成台灣口音品質的保證。實際接受與否,仍要讓熟悉目標語言的人聽過完整稿件。
每一步都能試聽之後,才適合把滿意的聲音版本帶進正式合成。這也讓後續工作有明確的接受點,避免同一角色在不同作品裡因反覆重新設計而逐漸改變。
新聲音 ID 怎樣接進配音流程?
官方流程先建立聲音資源,再把它用於朗讀。使用者在建立聲音的介面選擇基礎聲音,並提供修改描述。系統回傳新的 voice_... 識別碼,以及可供試聽的音訊。
第二步才把這個識別碼指定給文字轉語音,讓模型朗讀實際稿件。
這個分工對不寫程式的人也有意義。在 Google AI Studio 中,可以先互動式調整與試聽,再把通過的角色用在作品中。開發者則可以透過 Gemini API,把同一流程放進應用程式。
介面操作與程式整合的入口不同,接受聲音前先試聽的原則相同。
在 API 文件中,建立新聲音使用 Gemini 3.8 Flash TTS,設定儲存為真,聲音類型為提示式,並提供基礎聲音與相對修改文字。這些欄位決定了新資源從哪個版本衍生。
本文沒有執行付費 API,所述操作依官方文件整理。
回傳的試聽音訊是二十四千赫的 WAV。試聽通過後,新聲音識別碼可用於 Gemini 3.8 Flash TTS,也可用於 Gemini 3.8 Flash-Lite TTS 合成。
這不代表兩個模型都具備完全相同的聲音建立功能,文件明確把新聲音的建立放在 Flash TTS。
新識別碼也可以再作為下一輪的基礎聲音。當角色已經接近需求,可以逐步調整節奏或投射感,保留各輪試聽與修改文字。這種版本鏈能幫團隊回看每個聲音的來歷,但「要求保留身份」仍是一項生成指令,實際一致性要透過試聽確認。
若同一份稿件需要不同模型輸出,應用同樣的文字比較。除了聽角色是否接近,也要檢查朗讀內容、停頓與語氣。聲音版本增加以後,管理配額與保存期限就會成為持續製作的一部分。
付費資格、兩百個配額與保存期限怎麼看?
文件要求付費等級專案,並為保存中的聲音設定共同上限。Voice Remixing 的 Gemini API 專案需要付費層級一或以上,不能因為功能能在公開文件看到,就認定所有免費專案都可直接使用。
AI Studio 的介面可見性與所連接專案條件,也應在實際操作前確認。
每個專案最多保存兩百個有狀態的聲音資源,設計、重混與已保存的複製聲音共同使用這個額度。這和超過兩千種的官方聲音資料庫是不同概念。前者是自己專案保存版本的上限,後者是可選擇的起點,不能混稱為可以無限保存自訂聲音。
當每輪修改都建立新版本,額度可能比想像中更快增加。因此,實際製作時可以把試聽版本與正式採用版本分開標記,定期清理不再需要的資源。刪除之前仍應確認是否有作品流程使用該識別碼,避免後續合成找不到角色。
保存期限以最後一次使用為基準,文件列為一年。當使用這個聲音合成,或把它當作新一輪重混的基礎,期限就會重新計算。長期沒有使用的聲音會自動刪除,因此保存識別碼本身不代表聲音永久存在。
官方提供列出、取得與刪除聲音的管理方式。資源也會保留基礎聲音與修改文字,讓開發者追蹤版本關係。團隊可以把用途、接受日期與試聽結果一起記錄,讓同事知道哪個版本適合哪一種作品。
至於費用,應依當前模型定價與專案帳務確認。本文沒有為未核實的用量提供固定價格,也沒有假設建立聲音、重試與朗讀全部免費。把使用資格與版本清理納入流程後,還要確認聲音在不同稿件中是否符合需求。
建立一份聲音版本紀錄
聲音資源可以用識別碼追蹤,但製作團隊仍需要人能看懂的用途說明。例如,同一個旁白可能有一般解說、夜間故事與活動宣傳三種版本。若只保存一串代碼,隔一段時間就很難知道各自適用什麼稿件。
可以為每個採用版本補上角色名稱、基礎聲音、修改方向與試聽檔位置。
每次新增版本時,先確認它和原版的差別是否真的值得保存。若只是某句台詞需要更興奮,逐句表演設定就可能足夠。若整個系列都要改變音色,再保留新角色會比較合理。這樣既能減少混淆,也有助於管理共同配額。
正式交接時,還可以讓另一位同事用相同角色朗讀一段新稿,檢查識別碼是否正確、發音是否符合需求,以及輸出是否接近先前接受的聲音。這是團隊可自行執行的驗收方法,本文沒有代替讀者測試帳號。
把角色版本和實際稿件接起來,才能確認保存功能確實融入製作流程。
怎樣驗收一個可持續使用的角色聲音?
固定試聽稿可以讓團隊比較發音、節奏與情緒改變是否符合預期。一份實用的稿件可以包含品牌名稱、數字、短句與稍長的敘述,讓不同版本都讀相同內容。這樣比較時,注意力可以放在聲音差異,而不會被不同文字內容干擾。
第一輪可以先聽清晰度。若模型漏字、數字念法不合需求或專有名詞讀錯,即使音色很漂亮,也需要再處理。第二輪再聽角色與節奏,例如旁白是否太快、情緒是否過強,以及句尾是否自然。
把內容與表演分開檢查,通常更容易找到需要修改的部分。
角色穩定性還要跨稿件觀察。同一聲音在短廣告、長旁白與多人對話中,可能有不同聽感。至少用兩種接近實際用途的文字測試,再決定是否列為正式角色。對需要多人審稿的團隊,可以讓同事比較相同片段並記錄接受理由。
如果要改變一段台詞的情緒,先想想它是否屬於角色的永久特徵。固定聲音已經合適時,逐句表演設定可能更適合。反之,若整個系列都希望角色更低沉或帶另一種口音,再建立新的重混版本會比較清楚。
Voice Remixing 的價值,是讓配音設計有可延續的起點與版本,而非每次從零挑選。保存基礎聲音、修改文字與試聽結果,才能讓下一次調整有清楚依據,也讓團隊知道自己實際接受的是哪一個角色。
常見問題
Voice Remixing 會覆寫原來的聲音嗎?
依官方文件,每次重混會建立新的獨立聲音資源。原本的基礎聲音不會被覆寫,後續刪除母聲也不會自動刪除已建立的衍生聲音。
Flash-Lite TTS 也能建立重混聲音嗎?
文件中的建立流程使用 Gemini 3.8 Flash TTS。完成後的新聲音識別碼可供 Flash TTS 與 Flash-Lite TTS 合成,應分清建立與朗讀兩個階段。
保存後可以永久使用嗎?
官方保存期限為最後使用後一年,合成或作為新重混的基礎會更新期限。每個專案還有兩百個保存聲音的共同配額,需要持續管理。