Grok 4.7 發表:價格不變、長任務更強,程式開發與知識工作升級了什麼?
Grok 4.7 維持前代 API 價格,並在程式、終端機與專業工作評測取得進步。本文解析規格、價格、實測數據與適用情境。
SpaceXAI 在 2026 年 9 月 21 日發布 Grok 4.7。原始貼文只有一句很直接的宣傳:新模型比 Grok 4.6 有明顯進步,但價格與速度維持不變。
版本號增加 0.1 只是表面變化。真正值得注意的是,SpaceXAI 把升級重點從「回答一道難題」移向「把一份工作做完」。Grok 4.7 主要改善長時間寫程式、跨檔案修改、製作簡報與文件,以及需要多次檢查的知識工作。
我的結論是,Grok 4.7 是一次有實際價值的性價比升級,現有 Grok 4.6 使用者值得測試遷移。不過,它並非每項評測都拿第一,官方公布的比較也使用不同推理強度。企業若要更換主力模型,仍應用自己的程式庫、文件與工作流程進行測試。
Grok 4.7 是什麼?
Grok 4.7 是 SpaceXAI 面向程式開發、AI 代理與知識工作的前沿模型。這裡的「AI 代理」會使用工具、讀取多個檔案,並連續執行許多步驟來完成任務,能力比只回答問題的聊天機器人更完整。
根據 SpaceXAI 的發布說明,Grok 4.7 換用比 Grok 4.6 更大的基礎模型,也進行了更長時間的強化學習。強化學習可以理解為讓模型反覆嘗試任務,再根據結果調整行為。這次的訓練特別提高需要數小時完成的題目比重,目的不是只讓模型答得更難,而是讓它更能規劃步驟、管理長篇內容並檢查自己的成果。
官方開發文件顯示,Grok 4.7 可接收文字與圖片,輸出文字,並支援函式呼叫、網路搜尋、X 搜尋與程式執行。它的上下文視窗為 50 萬個 token。Token 是模型切分文字的基本單位,而上下文視窗代表一次請求能讓模型參考的內容上限。對需要讀取大型程式庫或大量文件的任務來說,容量越大,越有機會減少來回拆檔與遺漏資訊。
模型的知識截止日為 2026 年 5 月。換句話說,5 月之後的新事件仍需要搭配搜尋工具或外部資料,不能只靠模型內建知識。
Grok 4.7 比 Grok 4.6 強多少?
如果只看 SpaceXAI 公布的同系列比較,進步最明顯的項目出現在長時間操作電腦與處理專業任務,而不是單純聊天。
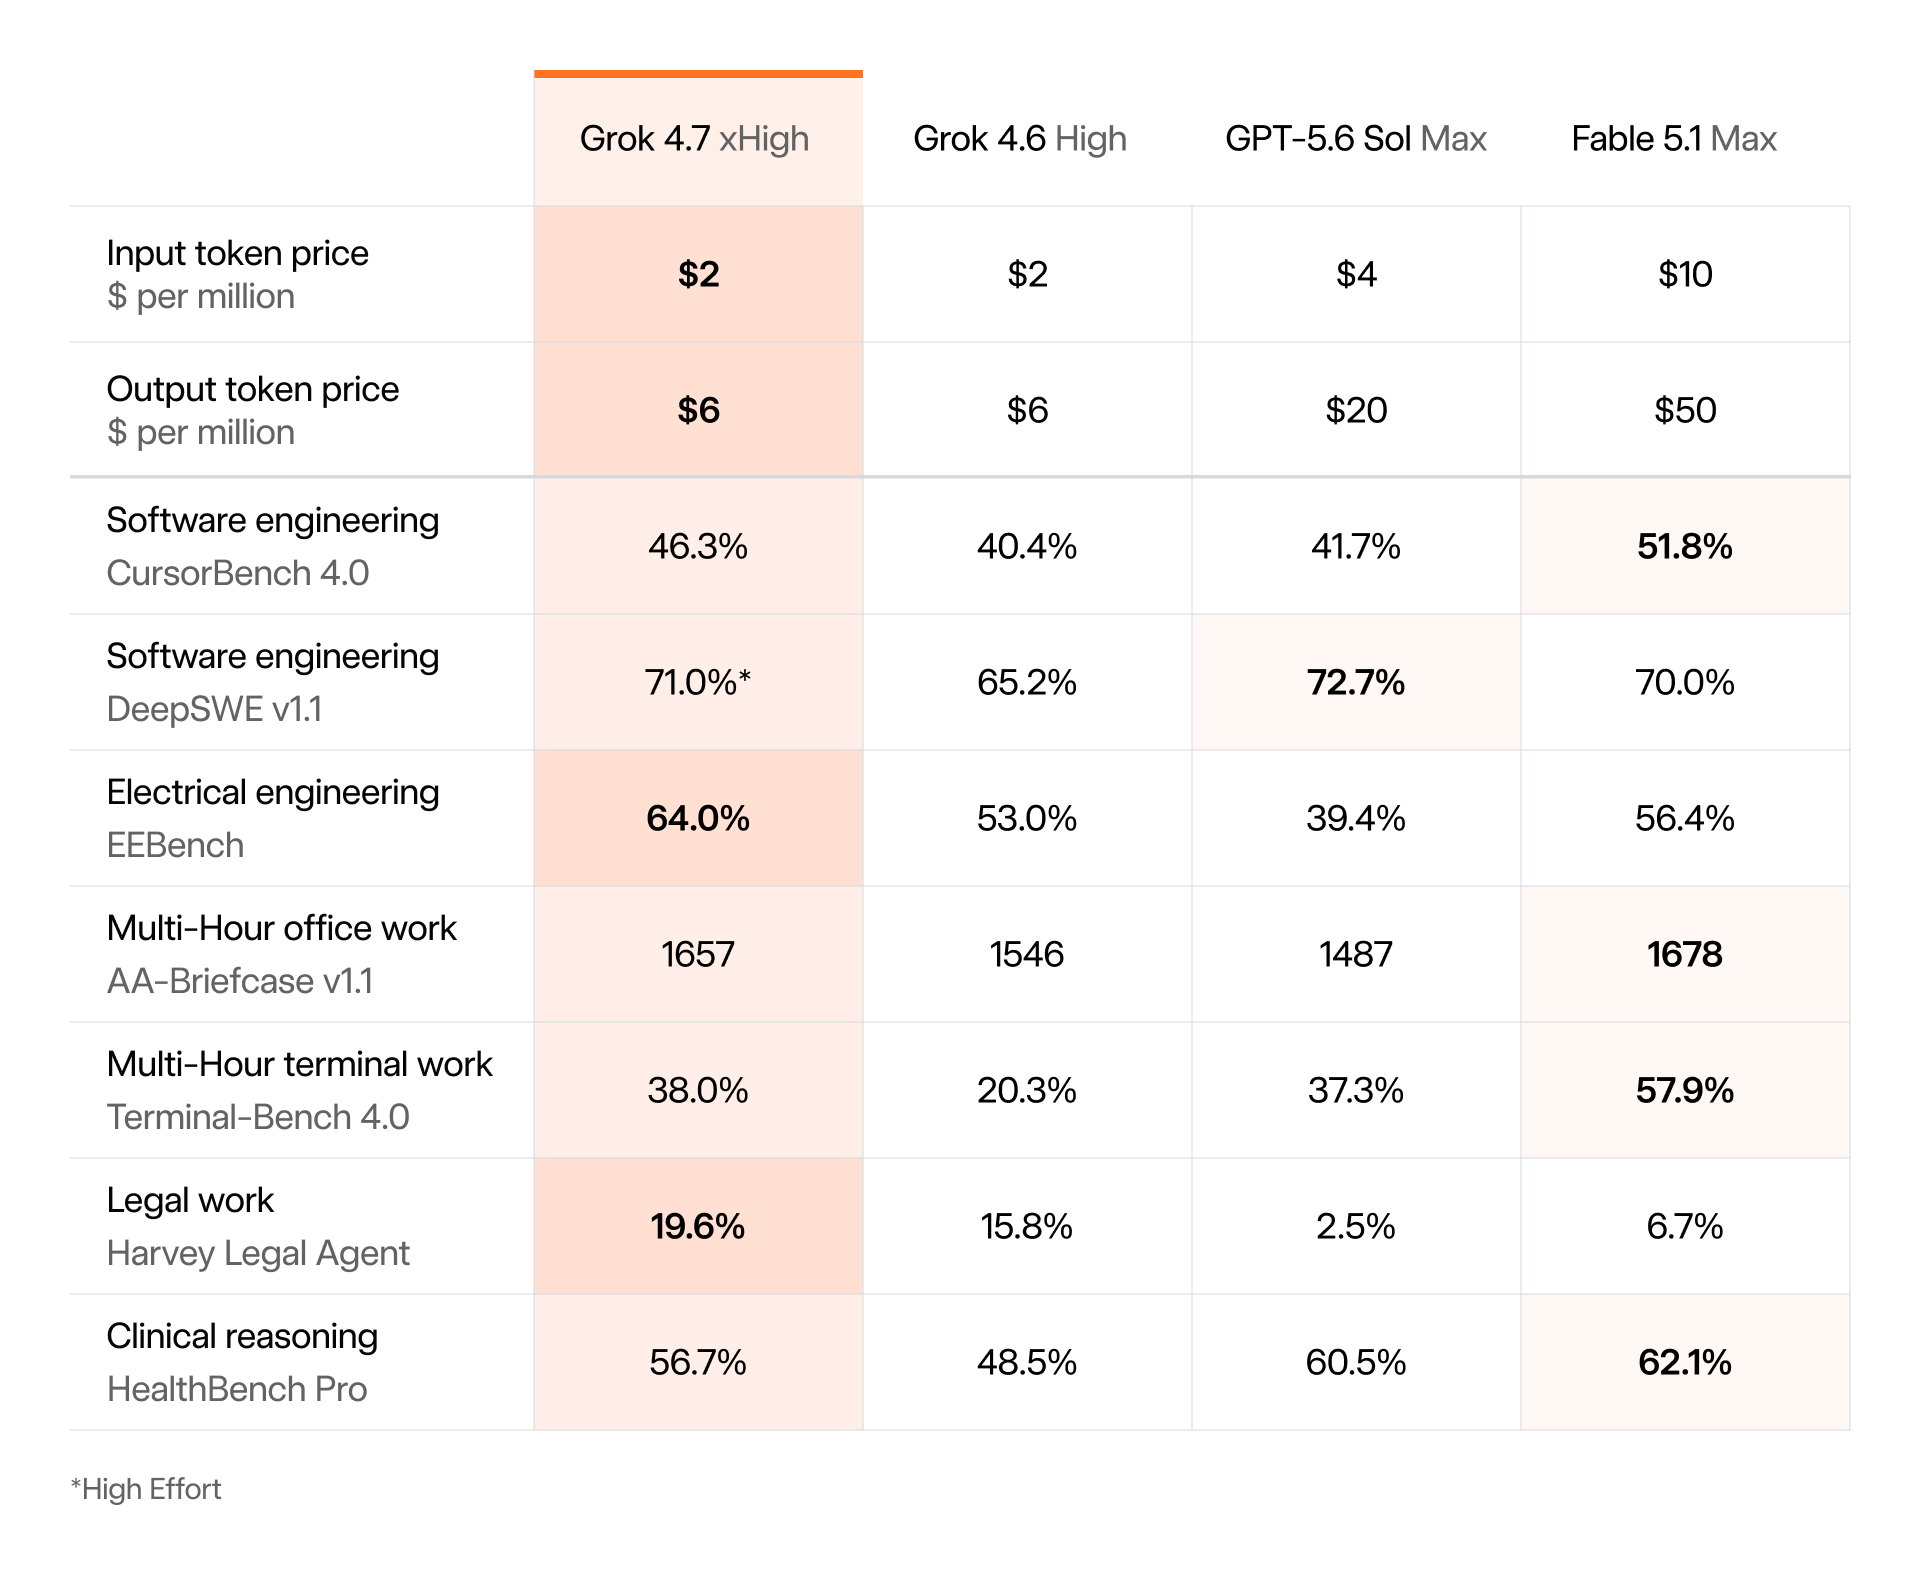
| 評測項目 | Grok 4.7 | Grok 4.6 | 差距 |
|---|---|---|---|
| CursorBench 4.0 程式開發 | 46.3% | 40.4% | +5.9 個百分點 |
| DeepSWE v1.1 軟體工程 | 71.0% | 65.2% | +5.8 個百分點 |
| AA Briefcase v1.1 知識工作 | 1,657 | 1,546 | +111 |
| Terminal-Bench 4.0 終端機工作 | 38.0% | 20.3% | +17.7 個百分點 |
| Harvey 法律代理評測 | 19.6% | 15.8% | +3.8 個百分點 |
| HealthBench Professional 臨床推理 | 56.7% | 48.5% | +8.2 個百分點 |
| EEBench 電機工程 | 64.0% | 53.0% | +11.0 個百分點 |
資料來源:SpaceXAI Grok 4.7 官方發布頁。DeepSWE 的 Grok 4.7 成績使用 high 推理強度,其餘表中官方主比較使用 xhigh。Grok 4.6 則使用 high,因此這張表適合觀察產品定位,不適合視為完全相同條件的科學對照。
其中最有感的訊號是 Terminal-Bench 從 20.3% 上升到 38.0%。這類評測要求模型在終端機環境完成多步驟工作,比一次回答程式題更接近 AI 代理實際操作電腦的方式。分數接近翻倍,支持 SpaceXAI 所說的「更能完成長任務」,但 38.0% 也表示仍有大量任務無法完整通過,不能因此取消人工檢查。
CursorBench 4.0 則使用真實 Cursor 工作階段中的模糊、多檔案任務,包含編輯、重構、調查問題與理解使用者意圖。Cursor 的公開榜單顯示,Grok 4.7 xhigh 得分 46.3%,高於 GPT-5.6 Sol max 的 41.7%,但低於 Fable 5.1 max 的 51.8%。Grok 4.7 的平均單題成本為 6.01 美元,另外兩者分別為 8.23 與 17.28 美元。
這組結果較能支持「價格效能很有競爭力」,不能直接推導出「Grok 4.7 是最強程式模型」。Cursor 也提醒,評測存在波動,小幅分數差異不一定具有統計意義。
不只寫程式,Grok 4.7 也在搶知識工作
SpaceXAI 這次把文件、簡報、法律、醫療與工程評測放在同一份發布內容,反映 Grok 4.7 想競爭的不只是開發者市場,而是可以交付成品的辦公室 AI。
例如,AA Briefcase會要求 AI 完成試算表、簡報與備忘錄。它包含 4 個模擬數週進行的專案與 91 項任務,涵蓋資料科學、產品管理與企業策略。Grok 4.7 的分數從前代 1,546 提升到 1,657,已接近 Fable 5.1 的 1,678,也高於官方比較中的 GPT-5.6 Sol 1,487。
這代表 Grok 4.7 的升級不只對工程師有意義。需要整理多份檔案、建立表格、寫報告或製作簡報的使用者,也可能感受到差異。不過,評測分數只能證明模型在指定環境中的表現,無法保證它理解每家公司的格式、內規與資料品質。
醫療數據更需要保守解讀。Grok 4.7 在 HealthBench Professional 得到 56.7%,比 Grok 4.6 的 48.5% 高,但仍低於官方表中的 GPT-5.6 Sol 60.5% 與 Fable 5.1 的 62.1%。這套評測來自臨床人員實際會提出的照護諮詢、文件撰寫與醫學研究任務,並由醫師制定評分規則。它適合用來比較模型的臨床推理能力,但不是醫療器材認證,也不代表模型可以取代醫師。
Grok 4.7 API 價格多少?
Grok 4.7 標準版的 API 價格為每 100 萬個輸入 token 2 美元、每 100 萬個輸出 token 6 美元,與 Grok 4.6 相同。對已經使用前代 API 的團隊來說,這是這次更新最直接的價值:在單位價格沒有上升的前提下,模型在多項長任務評測取得更高成績。
| 版本 | 輸入價格 | 輸出價格 | 主要差異 |
|---|---|---|---|
| Grok 4.7 | US$2/百萬 token | US$6/百萬 token | 標準速度,可透過公開 API 使用 |
| Grok 4.7 Fast | 標準版的 2 倍 | 標準版的 2 倍 | 輸出速度約為 2 倍 |
Grok 4.7 Fast 使用同一個模型與更快的運算資源,目前只在 Cursor 與 Grok Build 提供,未開放於公開 xAI API,也不包含在 Grok Build 免費方案內。這個版本適合在意等待時間的互動式開發。若是可以排隊執行的批次任務,標準版通常更符合成本效益。
Grok 4.7 已可透過 xAI API、Cursor、Grok Build,以及 OpenRouter、Vercel 與 Cloudflare 等模型閘道使用。模型閘道可以理解為統一連接多家 AI 模型的服務,方便團隊切換供應商或集中管理用量。
安全性進步了嗎?官方數字該怎麼看?
SpaceXAI 表示 Grok 4.7 採用全新的安全防護架構,在拒絕危險要求與抵抗「越獄」方面是該公司測過最強的模型。越獄是指使用特殊提示,誘導模型繞過原本的安全限制。
在官方公布的資料中,Grok 4.7 於 LatchBio 生物安全評測得到 62.4%,在 HackerBench v0.3 只放行 3.3% 的高風險雙重用途提示。雙重用途指同一種技術既能用於合法防禦,也可能被拿來造成傷害,例如資安掃描與入侵工具可能使用相似能力。
這些數字支持 Grok 4.7 在安全訓練上有進展,但仍是供應商公布的評測結果。真正部署時,企業還要測試模型是否會洩漏內部資料、誤用工具、接受提示注入,或在權限過大的情況下執行錯誤操作。模型更會拒絕危險問題,不等於整個 AI 系統已經安全。
Grok 4.7 值得改用嗎?
如果你已經使用 Grok 4.6,Grok 4.7 值得列為優先升級測試。價格維持不變,程式、終端機、法律、臨床與電機工程評測都高於前代,沒有明顯的成本懲罰。較穩妥的做法是先選出一批具有標準答案的真實任務,平行比較成功率、總 token、完成時間與人工修正時間,再決定是否全面切換。
如果你正在比較不同公司的前沿模型,結論就沒有那麼單純。Grok 4.7 在部分程式與電機工程評測領先,但在 CursorBench、Terminal-Bench 與臨床推理等項目仍有對手得分更高。它目前最清楚的優勢是用較低 API 單價取得接近第一梯隊的長任務能力,而不是每一項能力都排名第一。
我會把 Grok 4.7 定位成「值得納入實測的高性價比前沿模型」。如果後續獨立測試無法重現長任務的提升,或實際工作需要更多人工返工,這個評價就應下修。對團隊來說,真正重要的指標不是發布會上的總分,而是每一份合格交付成果需要花多少成本與人工時間。
Grok 4.7 常見問題
Grok 4.7 的知識更新到什麼時候?
官方文件標示的知識截止日是 2026 年 5 月。需要處理更新事件時,應搭配網路搜尋、X 搜尋或自行提供資料來源。
Grok 4.7 可以看圖片嗎?
可以。它支援文字與圖片輸入,但只輸出文字。若需要生成圖片或影片,必須使用 SpaceXAI 的 Imagine 系列或其他媒體模型。
Grok 4.7 比 Grok 4.6 更貴嗎?
標準版沒有漲價,兩代都是每百萬輸入 token 2 美元、每百萬輸出 token 6 美元。速度加倍的 Grok 4.7 Fast 收費為標準版的 2 倍。
Grok 4.7 是目前最強的 AI 模型嗎?
不能只靠這次發布的數字下這個結論。Grok 4.7 在多項測試超越 Grok 4.6,也在部分項目領先其他前沿模型,但並未橫掃所有評測。不同推理強度、工具與執行環境也會影響結果。
一般使用者與企業該怎麼選?
個人使用者可先看自己常用的平台是否已提供 Grok 4.7,再用熟悉的任務比較輸出品質。企業則應先建立內部測試集,並同時記錄成功率、成本、延遲、返工時間與安全問題,再決定是否更換主力模型。
結論:Grok 4.7 的重點是完成工作,不是多一個聊天模型
Grok 4.7 最有意義的改變,是在維持前代價格與速度的情況下,提高長時間程式開發、終端機操作、文件製作與專業推理能力。這讓它從「能回答問題的模型」更接近「能持續處理一份工作的代理核心」。
它還不是所有評測的冠軍,也不能因為安全分數提高就省略人工與系統層防護。對現有 Grok 4.6 使用者而言,升級測試的理由已經足夠。對正在跨品牌選模型的團隊而言,Grok 4.7 最強的賣點是價格效能,最終決定仍應交給自己的真實任務。