Hugging Face Decision Models 整合:AI 分類不用先寫一段話,機率又能信多少?
Hugging Face Decision Models 整合固定選項、分數與是非判斷,說明零輸出 token 的意義、信心和正確率差異,以及客服路由如何設定覆核門檻。

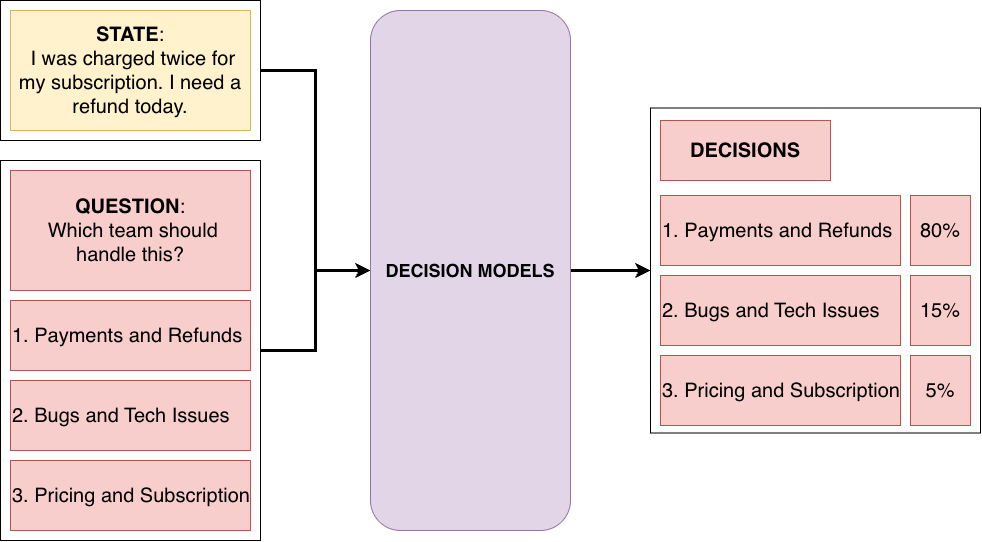
客服信件要分到哪個部門,常常只需要一個類別。若先請語言模型寫完整回答,再從回答裡抽出標籤,就會多出格式解析與輸出文字的步驟。
Hugging Face 在 11 月 10 日介紹 Decision Models 的共同介面,把輸入狀態、問題與允許答案交給模型,直接取得決策和機率。這次新聞是框架整合,分類和機率判斷本身早已存在。
這套方式可處理固定選項、順序分數與是非判斷。因為答案範圍先被定義,應用程式比較容易把結果接到後續流程。
部分相容語言模型可以直接比較候選答案的分數,而不必逐字生成解釋。因此回傳零個輸出 token,仍然需要讀取輸入與執行推論。
更重要的是,介面提供的信心分數只描述模型如何分配機率。模型很肯定也可能分錯,無法把畫面上的數字直接當作真實正確率。
對有大量分類或路由工作的人,這次整合值得測試是否減少解析問題。先定義應該判斷什麼,才知道模型回傳的機率能支援哪種動作。
Decision Models 如何把狀態變成固定選項?
新介面把背景資料、問題與可選答案分開,讓結果以可處理的決策和機率回傳。它可以協助應用程式取得明確類別,減少從長篇回答猜測模型意思的步驟。
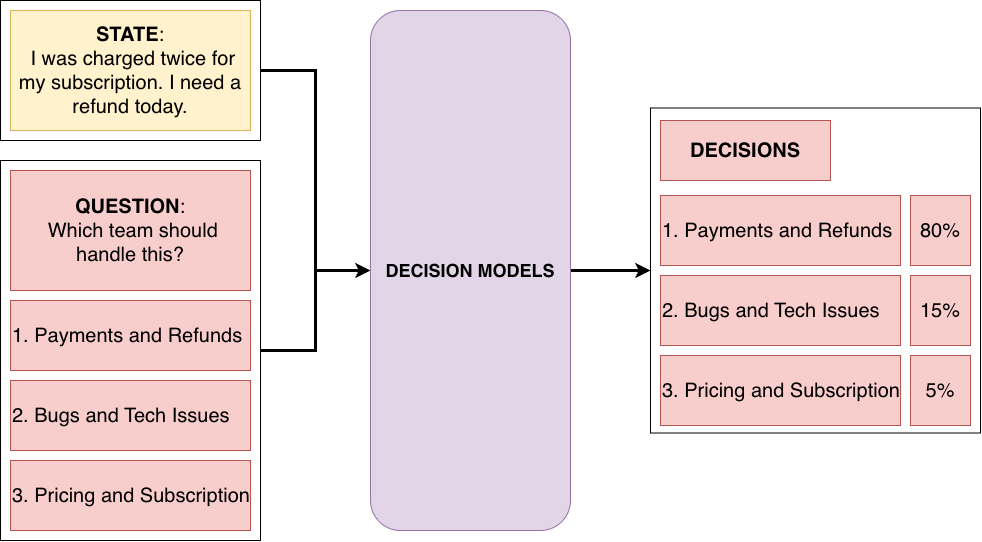
這裡的狀態,就是做判斷所需的背景。例如客戶說自己被重複扣款、希望退款,這段文字是輸入資料;要交給哪個團隊處理,則是應用希望模型回答的問題。
允許答案可以定義成退款、技術問題與方案諮詢。因為候選範圍已經列好,結果就能直接連到相應流程,而不必先處理「我建議您可能可以聯繫」這類自然語言。
Hugging Face 公告把這種輸入和輸出整理成共同介面。本次更新的重點是框架支援和使用方式整合,並不是宣稱分類模型在 11 月才首次出現。
分類、排序和機率判斷早已是機器學習工作的一部分。新的共同格式,讓不同模型和應用比較容易共享決策方式,但不會自動消除每個任務自己的定義問題。
例如同一封信也可能同時包含扣款與登入故障。如果應用只允許選一個類別,就要先決定選主要訴求、最高風險或其他標準,否則人類標記也可能彼此不同。
因此,固定格式能解決輸出怎麼讀的問題,卻不能替使用者決定分類原則。原則定清楚之後,機率和標籤才有可以驗收的目標。
答案的型態不同,機率應該如何用也會不同。共同介面把這些差異拆成選項、順序分數與是非判斷,讓應用明確選擇需要的結果。
選一個、給分、判斷是非,三種輸出怎麼用?
固定選項選出最高機率答案,順序分數可算期望位置,是非機率則交由應用設定門檻。這些結果雖然都包含數字,數字所代表的意思卻不相同。
名為 Choice 的類型,適合從已定義候選中選一個答案。例如客服路由的幾個部門,結果可以包含各選項機率,再由最高值決定預設處理方向。
這種選擇仍取決於候選是否完整。若一封信其實是合作邀約,但選項只有退款與故障,模型就只能在不合適的答案裡做相對判斷,最高機率不會憑空創造缺少的類別。
Score 則把答案視為有順序的刻度,利用機率計算預期位置。假設刻度為零、一、二,機率分別是 0.1、0.2、0.7,期望位置就是 1.6,這是說明性的數學算例。
期望位置並不表示模型新增了一個名叫 1.6 的類別。它是依既定刻度做的加權結果,適合用來表示分布偏向哪個位置,後續仍要依工作意義解讀。
Noul 是是非機率判斷,可以理解成對一個命題估計「是」的機率。應用可以針對不同錯誤代價設定門檻,而不是所有工作都一律採相同分界。
例如判定內容是否需要人工覆核,漏掉高風險內容和多送幾件覆核的代價不同。門檻應反映這種差異,不能因為介面回傳了數字,就把決策責任完全交給模型。
這些類型也能出現在同一份輸入的多個問題中。若同時需要主要類別和是否緊急,就應分別定義它們,而不是用一個標籤暗示所有意思。
有了規則化輸出,接著才看模型能省去哪段文字生成。省下格式整理固然有幫助,但能否降低整體費用,還要回到實際推論流程。
零輸出 token,為何不代表零算力?
部分模型可直接讀取候選答案的分數,所以不必為分類另外生成一段自然語言。這與先產生長篇解釋,再從字串中抽出結果,是不同的處理方式。
語言模型原本就會計算接下來文字的可能性。對相容模型,可以用候選標籤的分數換算機率,把運算集中在已定義的答案,而不是逐字寫出完整回答。
公告介紹這種方式可以在批次推論中處理多個問題。批次是把多項工作一起安排運算,有機會減少零碎請求的負擔,但實際效益仍取決於模型和部署方式。
回傳零個輸出 token,只表示沒有用一般生成方式輸出回答文字。模型仍需讀取輸入、建立內部表示並計算候選分數,因此依然需要硬體與推論時間。
這點對費用比較很重要。若一邊記錄完整請求的耗時,另一邊只看輸出 token 數,就可能把不同計量單位當成同一種節省,得到過度樂觀的結論。
真正需要比較的是固定工作量下的延遲、設備占用與結果品質。若是外部服務,還要確認供應方如何計費,不能由輸出欄位直接推斷免收輸入費用。
模型也可能在較少輸出的情況下分錯。省略解釋能讓介面簡潔,但如果原本需要人員查看推理依據,應另外安排可追溯的來源或判斷記錄,而非假設機率就是理由。
因此,這種方法主要提供另一種計算與整合選擇,並沒有把所有生成任務都變成免費分類。需要創作、摘要或開放問題解答時,仍有其他輸出要求。
省下輸出之後,分類品質和機率可靠性仍要另外量測。因為應用接收到的結果越容易直接執行,錯誤也越可能順著流程往下傳。
信心高不等於答對,門檻要怎麼驗證?
信心反映候選機率的集中程度,只有拿有標準答案的資料測試,才能知道錯誤比例。模型若把大多數機率給同一個選項,就顯得很有把握,但這不等於該選項必然正確。
例如客服文字使用了模型不熟悉的產品名稱,它可能仍偏向某一類。分布很集中,只能說明候選之間的相對偏好,無法直接證明輸入已被正確理解。
這就是信心與實證正確率的差異。後者需要把預測結果和人員標記相比,再依不同信心區間,檢查真正答對與答錯的數量。
若某個區間常常高信心卻答錯,就不能只提高顯示小數位數來解決。團隊需要回頭看類別定義、訓練資料與模型適用範圍,才能知道錯誤從哪裡來。
測試也應保留容易混淆的案例。只拿語句清楚、每類特徵明顯的資料驗證,得到的數字可能很好看,卻無法反映同時有退款、故障與情緒字眼的真實信件。
這裡的實用做法,是先把不同錯誤代價標出來。一般詢問送錯部門可能只是多一次轉交,但緊急問題被當成普通信件,就可能需要完全不同的覆核門檻。
模型低於門檻時,可以交回人員或保留更多資訊,而不是硬選一個答案後自動執行。這種流程設計不會由模型介面自動完成,仍需應用程式明確實作。
分類規則改變後,也要重新檢查門檻。因為新類別加入會改變候選之間的機率分配,舊的信心數字不一定保留相同的錯誤意義。
這種品質檢查會直接決定哪些結果可以自動執行,哪些要交回人員。接下來的框架支援,主要是讓這些決策比較容易接到既有系統。
接上 Transformers 與 llama.cpp,整合了哪些工作?
共通介面讓不同模型能以相近方式提供判斷,但部署、模型授權與訓練支援仍各有條件。公告介紹 Transformers 的決策管線與相關模型介面,也列出 llama.cpp 的既有支援路徑。
後者的原始介紹發布於十月,屬於這次整合文章引用的背景,不能當成十一月首次推出。
這些框架是模型運行與整合的工具,不是新的單一模型。開發者仍需要選擇適合的權重、確認輸入格式,並使用對應版本的實作,才能得到預期結果。
相同格式的好處,是應用程式不必為每個模型重寫全部解析流程。若要更換模型,就比較容易保留同一組問題和候選,再用既有測試集檢查品質是否改變。
但相同格式不保證不同模型有相同語言能力、延遲或授權範圍。某個模型在英文客服上表現良好,也不能直接視為台灣繁體中文與在地產品名稱都能處理得一樣可靠。
公告同時討論專門訓練與之後的整合方向,部分訓練支援仍以進行中描述。讀者應依自己使用的版本確認功能,而不是把文章裡所有示例都當成已完成的通用產品承諾。
延伸閱讀:Hugging Face 多框架強化學習:同一個 AI 模型,換工作工具為什麼就變了?
延伸閱讀:JEMM-27B 是什麼?開源多模態判斷引擎,93.3% 工具呼叫成績怎麼看?
採用時應先挑一個可驗收的工作,而不是把所有對話都改成固定選項。當問題本來就需要開放解釋,過度限制答案反而可能丟失重要資訊。
Decision Models 常見問題
固定格式是否代表不會分錯類別?
固定格式能讓輸出更容易被程式處理,但類別是否正確仍要測試。若輸入超出候選範圍,或類別定義互相重疊,模型可能用很整齊的格式交出錯誤答案。
可以把信心 0.9 當成九成會答對嗎?
不能直接這樣換算。信心描述機率集中程度,必須透過有標準答案的測試資料,才能檢查這個分數區間的實際正確率,而且結果會受到資料和模型版本影響。
它是否適合替代所有聊天模型?
較合適的情境是答案範圍明確的分類、路由或是非判斷。需要產生完整文字、探索未知問題或創作內容時,任務本身就超出單一固定選項的用途。
先拿客服路由試驗,再決定自動處理比例
有清楚類別與人工標記資料的團隊,較能檢查這種介面是否減少延遲和維護成本。這次整合降低的是接出決策的摩擦,分類品質仍要由自己的資料回答。
可以先從只產生建議、不直接執行的路由試驗開始,保留模型答案、人員答案與處理時間。當錯誤集中在哪些類別變得清楚,才容易調整候選和覆核門檻。
把錯分代價與人工處理比例一起量出來,再決定哪些結果可以自動接續。如此才能讓共同介面的便利,轉成可驗證的流程改善,而不是只是多了一個好看的信心數字。