JEPA 柏拉圖表徵研究:小模型為何能更對齊影像,42倍又代表什麼?
JEPA柏拉圖表徵研究以同場景不同描述改善圖文對齊。解析109M模型、42倍樣本與14倍文字量的不同分母,以及定理、配對資料和圖片描述示範的限制。

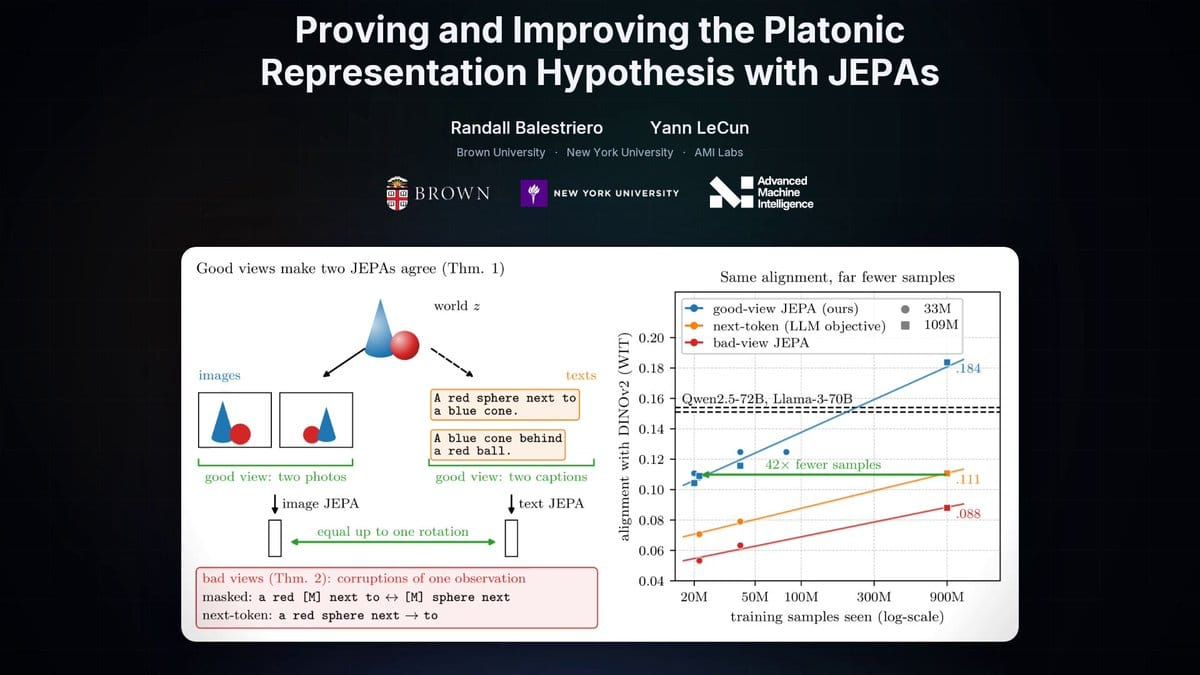
JEPA 這次受到注意,是因為一個小型文字模型,和影像模型對同一批內容的分類方式,竟比受測的大型語言模型更接近。
這裡的接近指表徵對齊,也就是模型轉換出的數值特徵,是否把相似內容放在相近位置。它不等於小模型聊天、寫程式或解題都比較強。
Randall Balestriero 與 Yann LeCun 在 2026 年 10 月 29 日公開論文,研究分開學文字與影像的模型,什麼時候會形成可互相對應的內部表示。
他們把答案放在訓練時如何挑選同一件事的不同觀察,並在理想化條件下提出定理。實驗則比較這種安排和預測下一個文字的差別。
論文最醒目的四十二倍,指同一對齊程度所需的訓練樣本差距,沒有直接證明運算費用也省四十二倍。理論前提和資料來源同樣需要保留。
對想看懂世界模型路線的讀者,這項研究提供的是訓練目標的新證據。要理解為何挑對觀察有用,先從兩種模型怎麼描述同一場景開始。
JEPA 的表徵對齊,是讓兩個模型學會同一種語言嗎?
兩個模型可以用不同數值座標表示相近的內容,對齊要找的是兩邊結構能否對應。它不要求文字模型直接讀圖片,也不要求兩個模型輸出完全相同的數字。
依原始論文,表徵是模型從輸入提取的內部特徵。文字和影像原本形式不同,研究關注的卻是它們是否都保留了所描述世界的相似關係。
座標不同,仍可能描述同一種結構
可以把它類比為兩張方向不同的房間地圖。一張把門畫在上方,一張把門畫在右方,只要家具彼此的位置關係對得起來,轉動地圖仍可能找出對應。
這是幫助理解的類比,不是定理的完整證明。論文在特定條件下討論旋轉對應,重點是表示可以不同,而內容關係仍具有共同結構。
JEPA 是聯合嵌入預測架構,讓模型根據一種觀察,預測另一種觀察的表示。它關注特徵之間的預測,而不是一定要把原始畫面或整段文字逐字重建。
相似內容是否互為鄰居?
實驗可以檢查某個項目在文字特徵裡的近鄰,是否也和影像特徵裡的近鄰相近。如果兩邊都把相近內容放在一起,就形成可測量的幾何對應。
這種量測描述的是特徵空間,並沒有直接測模型能否替使用者完成一份報告。兩種能力可能有關,仍不能用其中一個分數替另一個問題作答。
因此,比模型大小以前,先要知道訓練把哪些輸入視為彼此相同。
The Platonic Representation Hypothesis is now a Theorem ◼️
— Randall Balestriero (@randall_balestr) October 30, 2026
Train JEPAs separately, on any modalities: they provably learn the same representation up to one rotation.
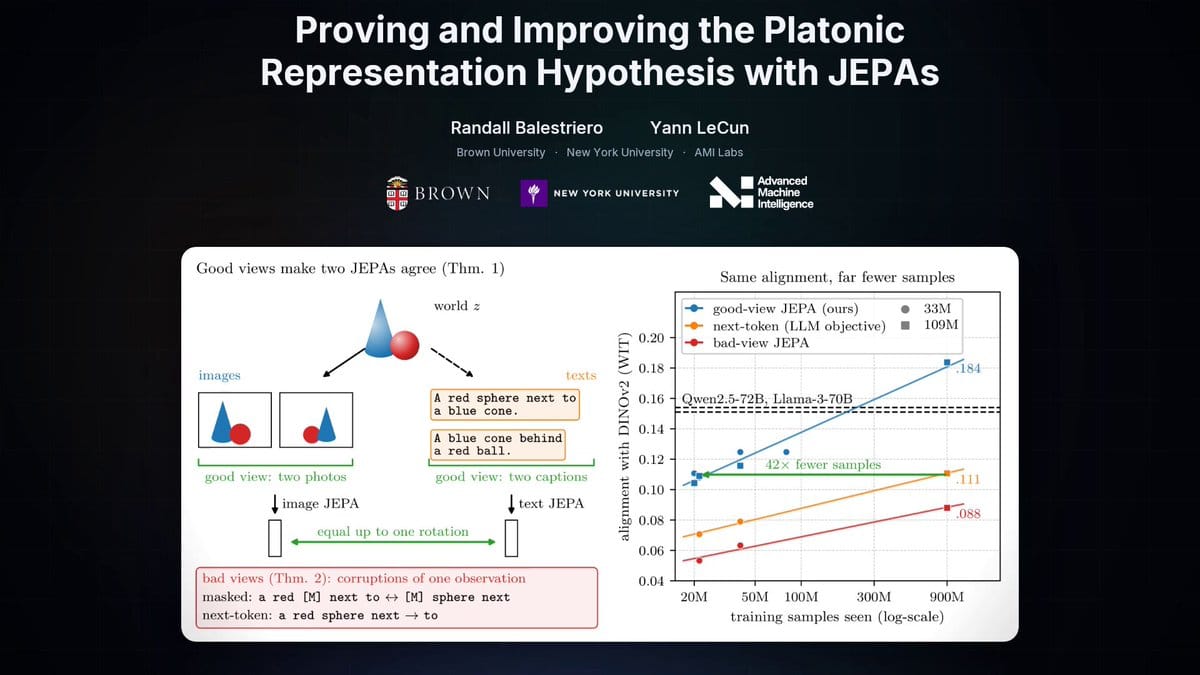
The result? A 109M JEPA-Text model that aligns with vision models better than 72B LLMs.
w/ @ylecun 🧵 pic.twitter.com/WoLptHo5a4
同一場景的不同描述,為何比遮住同一句話更有效?
讓模型抓住不同描述共有的內容,有助於減少它只記住某一種寫法。關鍵是兩份輸入共享什麼,而不只是兩份文字看起來有多像。
論文把同一個潛在世界的不同觀察稱為好的視圖。例如,同一張圖片有多種描述,句子可能選擇不同詞彙,卻仍指向相同的內容。
共有的事情,和同一份輸入的痕跡
假設一張圖有一個人騎車,兩段描述分別強調人物與交通工具。要從兩者學到共同特徵,模型就需要抓住場景,而不是只記得某一句的字序。這是本文自編的說明例子。
相對地,對同一句話做兩次不同遮蔽,兩個輸入仍可能保留同一份原始觀察特有的痕跡。模型可以預測這些痕跡,未必需要進一步抽取更一般的內容。
作者用這個差異解釋,為什麼有些文字自監督安排未必產生較好的跨模態對齊。這不是說遮字或裁切對任何任務都沒有價值,而是它們可能保留不同的資訊。
文字訓練仍使用了圖像分組資訊
這項實驗的好視圖來自同圖多種描述。資料中也使用由既有模型產生的重新描述,而該描述模型包含已接觸圖文對應的影像編碼器。
因此,文字模型雖然不直接讀取圖片像素,訓練資料仍帶有圖片分組和先前模型傳來的資訊。把它說成從頭到尾完全沒有圖文配對,是超出研究設定的簡化。
這也讓實驗的問題更明確:在已具備這類觀察的情況下,哪種訓練目標比較能保留共同結構?這項 JEPA 比較沒有同時排除資料來源對結果的影響。
不過,這個機制能提供多大改善,仍要回到同資料與具體指標比較。
42倍樣本與109M參數,實驗究竟比較了什麼?
論文顯示的優勢集中在表徵對齊,樣本、文字量與模型參數是不同尺度。把這三種數字混在一起,會讓研究看起來像是同時證明了費用與所有能力的巨大差距。
在相同語料的比較裡,JEPA 使用約二千一百六十萬個樣本,得到 0.109 的對齊分數。預測下一個文字的模型使用九億樣本,分數為 0.111,兩者才是四十二倍樣本說法的依據。
樣本不是相同數量的文字
JEPA 的一個訓練樣本會讀三段文字,因此換成實際文字量,差距約為十四倍。作者沒有提供能直接把這個倍數換成整套訓練美元費用或執行時間的結論。
不同訓練安排的學習率、批次和每個樣本要做的計算,都可能影響成本。樣本效率值得注意,但若要談省下多少運算,還需要另一組對應量測。
一億參數的優勢,限定在什麼指標?
109M 指約一億零九百萬個參數,是模型可學習數值的數量,不是佔用一億單位的記憶體。這項 JEPA 研究用這種規模的模型,檢查較小文字編碼器能形成什麼樣的特徵。
在與影像模型對齊的一組測試中,它的分數為 0.184,受測 Qwen2.5-72B 為 0.154。這是近鄰結構的量測,不是答題正確率,也沒有測完七百二十億參數模型的各種用途。
所以,小模型在這裡較高,支持訓練目標可能比單純放大文字預測模型更有效率地塑造這種特徵。它沒有證明較大的模型已經失去其他任務優勢。
重跑差異仍需要保留
論文也指出,第四個隨機種子改變了有效正則化權重,得到較低結果。四次平均仍比受測大型語言模型高,但這提醒讀者,單一最佳結果不是唯一應看的數字。
調參本身也沒有在所有比較方法上同樣完整進行。因此,結果可以支持這條路線值得追蹤,還不適合視為所有可能配方的最終排名。
表徵更容易對上之後,研究才進一步測試能否把兩端接成圖片描述工具。
只轉一個座標系,就能讓模型描述圖片?
圖片描述示範把既有影像編碼器接到文字端,中間那個對應映射仍需特定資料建立。它展示了對齊能怎麼用,而不只是在圖上看到兩組點接近。
影像編碼器負責把畫面轉成特徵,文字端則接到能產生句子的解碼器。研究使用既有、固定的影像編碼器,沒有把整套系統從零開始共同訓練。
單一映射,不是只用一個圖文配對
研究以三萬組 Flickr 圖文配對,擬合一個線性映射。這裡的一個指映射本身是一套共同的數學轉換,並不是只給模型看一張圖與一句話。
把影像特徵轉到文字模型的座標後,後端才有機會產生圖片描述。論文在 COCO 上報告的 CIDEr 為 0.838,採零到一的表示尺度,是特定描述品質指標。
這個數字不能直接當成看圖有八成三把握正確,也沒有證明任意圖片都會得到完整敘述。它提供的是應用示範與一種可比較的量測。
不用配對的分類,是另一個設定
論文另做不使用配對資料的分類實驗,在 ImageNet100 的前五名命中率為 64.4%。前五名的意思是答案落在模型提出的五個類別之中,不是第一名就一定答對。
該設定高於作者列出的部分無配對比較,但受測 CLIP 文字編碼器仍有 68.7%。這些結果各自說明一種設定,不能把圖片描述的配對映射和無配對分類合併成完全不需圖文資料的產品。
這些應用顯示對齊有用途,也讓理論和現實資料之間的限制變得更具體。
柏拉圖表徵定理的邊界,為何影響新聞怎麼讀?
這是特定 JEPA 設定的充分條件,沒有證明任何模型只要變大都會理解同一個世界。數學證明可以說明某些條件如何導向共同結構,現實模型是否符合,仍要檢查。
理論採用有限世界、能保留相關資訊的觀察、相符的分布,以及理想化的最佳解條件。現實圖片可能被遮住,文字也可能省略細節,觀察通常沒有這麼完整。
為什麼最佳解的條件很重要?
定理討論的不是任意訓練中途的模型,而是在所設目標下達到理想解的情況。實際訓練可能受資料量、最佳化和模型容量影響,因此理論允許對齊,不等於每次實作都會自然到達那個位置。
觀察是否保留足夠資訊也有差別。假設兩張照片只各拍到房間的一角,某些家具根本沒有出現,就不能要求兩份表示憑空包含所有相同細節。這是理解前提的類比,不是論文新增的視覺測試。
同理,兩份文字若主要共享同一句的形式,學到的共同結構可能更多關於那份觀察本身。作者要強調的,是如何設計觀察之間的關係,而不是只把預測目標換一個名稱。
這使資料整理也成為方法的一部分。先決定哪些描述真的來自同一內容,再訓練模型保留共通資訊,和把任何兩段相似文字當成正例,回答的是不同問題。
從新聞中的數字回到這些條件,讀者才比較能判斷後續進展。如果新研究改用別的資料來源,除了看最高分是否上升,也要確認共同結構是不是仍由相同方式形成。
能預測觀察,還不是能規畫動作
這次論文也沒有完整涵蓋所有帶動作條件、學習預測器的世界模型。代理如果要判斷推動物件之後會怎樣,還涉及行動如何改變環境,不能只靠跨模態對齊分數作結論。
對一般讀者,這個區分有助於辨認路線的進度:模型可能先學會更一致地表示內容,再研究這些表示能否支援生成、推理或控制。後面的能力仍需各自的證據。
研究程式已公開,官方程式庫提供重現與示範入口。程式採 MIT 授權,不表示每個外部資料集、預訓練模型和示範素材都自動具有相同權利。
目前它是研究方法與公開示範,沒有一個可直接比較月費的新聊天方案。後續若能在更多實際資料和任務維持這種對應,才會把這次研究推向更廣的應用。
想持續看懂世界模型研究,歡迎免費訂閱 AI 郵報。
JEPA 常見問題
四十二倍能直接換成訓練費用嗎?
不能。它是達到相近對齊程度的樣本量比較。每樣本讀取的文字、計算安排與系統成本不同,文字量比較約十四倍,仍不是美元或時間量測。
這表示小模型比大型模型更聰明嗎?
測試聚焦內部特徵能否與影像對應,沒有比較所有聊天、程式和推理能力。較好的對齊說明一種特定優勢,不能替代完整能力評估。
一般人現在可以試什麼?
原作者提供示範與程式庫,可以觀察特徵對接後的圖片描述。示範輸出仍可能有錯,也不代表所有裝置都能以相同速度執行。
延伸閱讀:H-JEPA 是什麼?世界模型先學會控制狀態,從看懂畫面走向規劃動作
延伸閱讀:L3G-World 研究:讓 AI 記住走過的場景,9FPS世界生成怎麼來?
原始資料來源