權重空間程式設計研究:AI 改掉 Qwen 推理迴圈,7.9% 到 48.1% 代表什麼?
權重空間程式設計讓AI直接分析與修改模型參數。解析MIT CSAIL早期研究的四款遊戲辨識、Qwen推理迴圈修補與MATH-500成績,說明工具、回饋預算及Gemma未改善的限制。

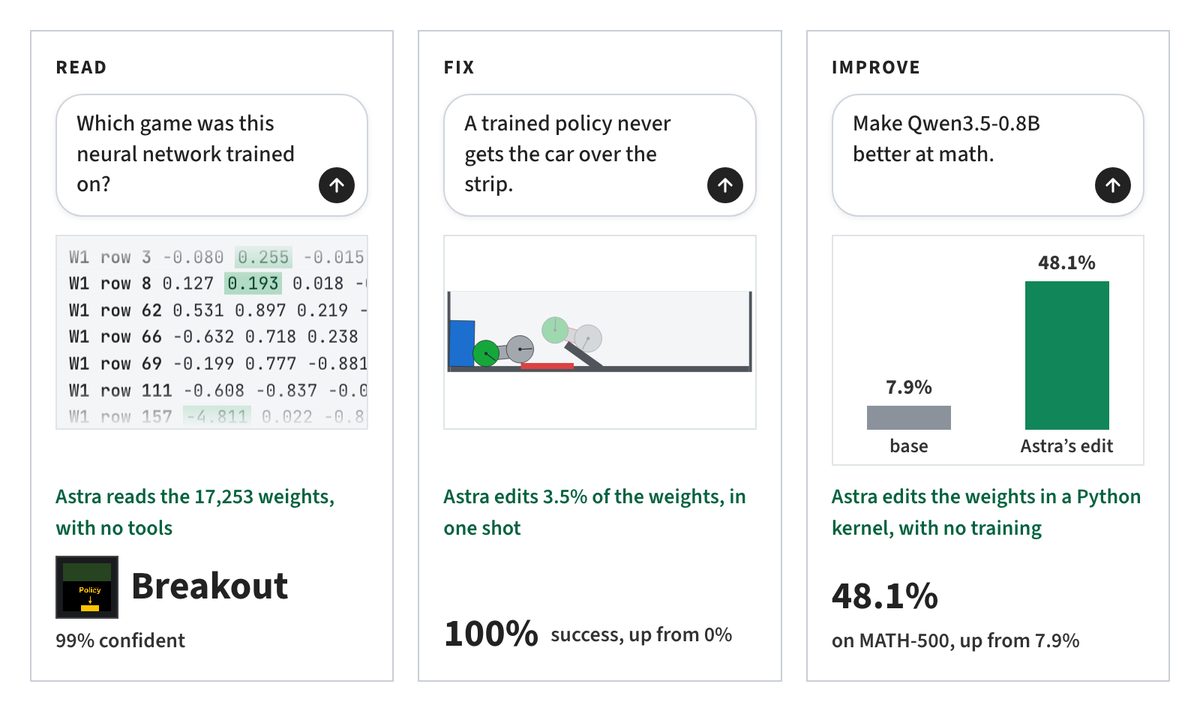
權重空間程式設計把 AI 模型內部的數字,變成另一個模型可以分析與修改的對象。權重就是模型在訓練後留下、決定計算方式的參數。
一般修改程式可以直接改一行,但神經網路的能力分散在許多參數中,所以修補行為通常需要資料與重新訓練。
MIT CSAIL 團隊在 2026 年 11 月 2 日發布早期結果,讓 GPT-6 Astra 直接讀寫其他網路的權重,部分任務不用工具,較大模型則搭配受限制的 Python 環境。
其中一項實驗把 Qwen3.5-0.8B 在 MATH-500 的分數從 7.9% 提升至 48.1%。但改善主要來自解除重複推理迴圈,不能直接讀成憑空增加數學知識。
對研究模型除錯的人,這提供了可追查的編修方向。要判斷成果能否重現,必須保留每項實驗不同的工具、回饋與測試條件。
先分清閱讀小網路、修補既有行為和建立新網路三種任務,後面的成績才有共同的解釋起點。
權重空間程式設計如何把模型參數當成可分析結構?
這項研究把修改目標交給通用語言模型,讓它判斷應該讀哪些參數、改哪些位置。作者稱之為權重空間程式設計,重點在於以推理決定修改,而非先指定一套固定的更新規則。
依作者研究原文,整組工作包含讀取、修補與從零建立網路。
這些任務共用直接操作權重的方向,卻沒有共用相同的資訊與工具限制。
例如,辨認小型遊戲網路時,模型看到的是可放進提示詞的浮點數。到了較大的語言模型,參數放不進對話,所以研究改提供程式環境,讓它用計算工具分析。
沒有梯度,不等於沒有運算或回饋
梯度可理解為根據目前誤差,告訴訓練程序應往哪個方向微調參數的訊號。這次實驗禁止以梯度下降訓練目標網路,改由代理直接決定新權重。
但代理本身仍要推理,有些實驗也能執行程式或觀察網路表現。因此,「沒有重新訓練」描述的是修改方式,不能換算成完全不花算力、沒有練習題或沒有試錯。
這也不同於把神經網路變成一般可讀程式碼。某組權重能被解釋出特定結構,不表示所有參數都已有清楚的人類語意,更不表示每次修改都會成功。
因此,評估這項成果應先問目標是什麼、代理拿到哪些資訊,再看修改前後如何測試。最容易看清這些條件的起點,是規模較小的遊戲辨識實驗。
3/6 Next, fixing weights: A PPO car policy kept getting stuck on a ramp.
— Rikiya Takehi (@rikiyatakehi) November 2, 2026
Given the weights, scene, and 1 failed trace, Astra wrote a patch in one reply with no tool-use.
By editing just 3.5% of the weights, it achieved 100% success. pic.twitter.com/DRol7bVnR1
只看數字辨識遊戲,實驗到底提供了什麼?
遊戲辨識測試嘗試排除靠網路外形猜答案的捷徑,因為四個目標網路使用相同的輸入、動作與層級尺寸。
它們分別在作者自製的打磚塊、乒乓球、小精靈與過馬路環境中訓練。場景都放在十乘十的網格,網路共有一萬七千二百五十三個權重。
研究者提供原始權重文字,也解釋網格與動作如何表示,但沒有說出遊戲名稱。因此,模型需要自行判斷遊戲用途,同時可以利用明確的輸入格式進行分析。
從參數分布找出可能用途
作者報告 Astra 正確辨識四個網路。其解讀包括觀察輸入位置的權重集中在哪裡,以及輸出動作如何區分,藉此推斷網路可能控制哪種遊戲行為。
這提供了參數結構與任務用途可能相連的例子,但樣本只有這組小網路。單次展示不能推算成任意模型的辨識準確率,模型表達的信心也不等於外部量測的可靠度。
另一組擴散模型實驗,要求代理從權重辨識它會生成哪種形狀。擴散模型是逐步處理雜訊、形成圖像的網路,這裡使用的也是小型、受控的設定。
作者注意到,代理把形狀畫成輪廓,但目標網路生成的是實心形狀。這個不一致很有意義,因為它顯示讀出幾何線索,和完整預測網路輸出仍有距離。
較大網路開始需要分析工具
字元語言模型的實驗則移除輸入與輸出層,只交出中間的 Transformer 區塊。代理可以用 Python 分析權重,卻不能把文字送進網路執行。
目標語料包含 Python 程式、羅馬字日文與英文。作者報告它能辨識語料,並找出與重複文字有關的注意力頭。這裡已不是無工具直接閱讀的同一個條件。
當分析工具和觀察範圍逐步改變,問題也從辨識用途,走向如何把想要的行為寫回網路。修補小車和建立圍棋網路,正好展示兩種不同的修改目的。
修補小車與寫圍棋網路,工具條件如何改變?
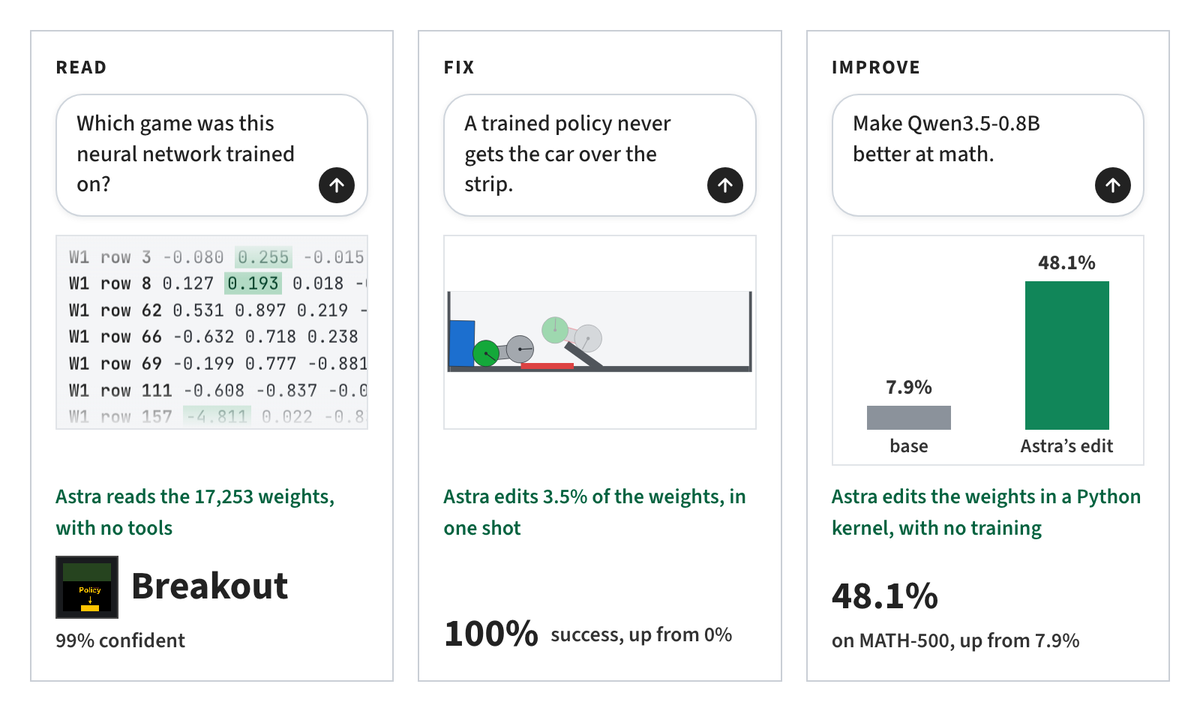
小車實驗要修的是既有策略的一個特定失敗,而不是重新教會它整個環境。代理拿到網路權重、場景說明與一段已錄下的執行軌跡,再提出一次修改。
在 Kinetix 關卡中,小車需要先後退取得助跑距離,才能跨過障礙。原本訓練出的策略直接往斜坡開,最後卡住,所以失敗原因可以透過場景和軌跡具體檢查。
作者報告,修改只動到百分之三點五的權重,修改後在一千零二十四次執行中全部成功。這是指定關卡的實驗結果,測量的是這個行為修補有沒有奏效。
一次成功仍需要保留測試範圍
原文將修改描述為加入一條讀取位置與速度的路徑,讓小車先倒退,再前進。這比「模型看穿所有物理問題」更接近研究實際驗證的事情。
因為它取得了場景與失敗軌跡,結果也不能被拿去證明代理只看裸權重就能修復任何未知行為。輸入資訊本身,是成績能成立的一部分。
圍棋實驗的目的則改為從零建立網路,棋盤是九乘九,約有一百四十八萬個參數。這個規模已無法把所有權重直接貼進上下文,因此研究提供 CPU 上的 Python 沙盒。
零回饋與有回饋,應分開比較
作者分別設定零次到五十次的前向執行預算。前向執行就是讓目標網路依輸入算出動作或答案,這裡可用來觀察對局,再決定是否繼續編修。
零次回饋時,代理寫出的網路能擊敗部分較小的訓練基線。五十次回饋時,則能超過同尺寸的指定 PPO 基線。兩者的對手與可用觀察不同。
因此,這些結果支持「推理加上適當工具能直接構造部分策略」,但沒有證明它已取代成熟圍棋系統或一般強化學習。接著的語言模型實驗,更清楚顯示修補能力與新增能力的差別。
Qwen 的數學改善為何與推理迴圈有關?
Qwen 實驗的突破點,是讓原本反覆繞圈的回答有機會走到結尾。作者並未把它描述成重新學到整套數學知識,而是找出妨礙既有能力表現的行為方向。
目標使用 Qwen3.5-0.8B,開啟思考模式。代理拿到權重、CPU 程式環境,以及來自 GSM8K 和 MATH 訓練集的練習題,但不能使用梯度訓練或 GPU。
研究另外保留測試題,不讓代理在編修時看到。這個分工很重要,因為拿練習題判斷修改,和直接針對最後評分題調答案,是兩種不同的驗證方式。
修改少量參數,減少重複推理
在五十次前向執行預算下,代理追到第十五與第十九層的前饋網路方向,再從部分輸出欄位減去它。總共修改十三萬一千零七十二個權重,約占全模型百分之零點零一六。
在公開模型卡與研究表格中,MATH-500 從百分之七點九升至百分之四十八點一,GSM8K 則從百分之十三點八升至百分之六十七點一。
這些分數保留相同取樣設定,且不同題組使用指定的多次取樣平均。因此,它們是研究評估的成績,不能直接當作任何使用情境的一次答對率。
回答能完成,影響不只在數學
在 MATH-500 中,碰到三萬二千七百六十八 token 輸出上限的比例,也從百分之九十三降至約百分之三十三。Token 是模型處理或生成文字的單位,不能固定換算成中文字數。
這表示修改後仍有回答碰到長度上限,但繞圈情形已有下降。指令遵循測試 IFEval 也改善,與迴圈並非只影響數學回答的解讀一致。
不過,十次和二十五次預算的結果,並未取得五十次時相同的改善。因此,不能只看最後的最高分,就省略試探預算和效果的關係。
這組結果最值得追查的是,代理如何定位一個有具體症狀的障礙。若模型本來就沒有這種障礙,同樣的編修方式是否有效,作者也做了反向測試。
沒有改善的 Gemma,如何界定研究邊界?
Gemma 3 270M 的測試沒有得到明確改善,正好限制了「直接改權重就能讓模型變聰明」的解讀。它較少陷入迴圈,錯誤多是算錯或推導不成立。
作者讓代理在同樣不能訓練的方向下嘗試修補,但 MATH-500 的分數只在原本百分之六點八附近小幅變動。研究沒有把這些變動認定為確立的增益。
因此,去除一個阻礙原有能力的方向,與補進模型尚未掌握的能力,並不是同一個問題。Qwen 的成功案例,不能代替其他模型和錯誤類型的驗證。
辨識行為也有失敗案例
另一項討好行為實驗,讓代理比較兩個經不同方向微調的 Gemma 副本。只看權重時,它四次嘗試都沒有可靠辨識哪個模型會附和使用者。
當研究放寬條件,允許它查看自行設計文字所引發的注意力分布後,才成功區分三組模型。因此,這個結果支持的是加入有限動態觀察後的辨識,不是已完成討好行為修復。
對研究者來說,可用的下一步是挑一個明確失敗、保留原模型與評估題,再比較修改是否穩定改善。若需要大量試探或造成其他能力退步,直接編修的價值就必須重新衡量。
重現時要同時保留取樣與評分方式
作者在不同題組上使用不同次數的取樣平均,所以重現者不能只挑一次答對的輸出,便宣稱取得同樣成績。輸出長度上限、取樣溫度和思考模式,也都會改變迴圈出現的機會。
同樣地,若只檢查修改後的數學題,可能看不到其他能力的變化。研究有納入更多評估項目,但這仍不等於所有語言、任務與部署條件都已經測過。
因此,公開修改檔和對話紀錄的意義,是讓別人沿著相同條件核對,而非要求讀者相信一次展示。當外部重現累積後,才更容易判斷這類修補是否穩定、成本是否合理。
權重空間程式設計常見問題
權重空間程式設計會讓模型訓練不再需要 GPU 嗎?
這些實驗仍建立在已訓練好的基礎模型與強大代理之上。禁止目標模型的梯度訓練,只限制了本次修改方法,沒有消除先前訓練和代理推理所需的資源。
公開權重是否代表可以放心使用修改版本?
開放檔案讓他人能檢查與重現,但用途仍要依模型授權、硬體需求與自己的評估決定。若要部署,除了目標題組,也應測原有能力與失敗行為是否改變。
小車成功是否能推論到真實機器人?
小車是指定模擬關卡,輸入和評分均有明確設定。真實機器人還包含感測誤差、設備限制與未知場景,所以需要另外的實體測試證據。
把可重現的行為修補,作為下一步觀察重點
這項研究適合從模型除錯的角度追蹤:先找出可描述的症狀,再問權重修改是否能有針對性地改善。公開紀錄的價值,在於能檢查成功與失敗如何隨工具和預算改變,而不只留下最高分。
想持續追蹤 AI 研究方法與可驗證的技術進展,歡迎免費訂閱 AI 郵報。
延伸閱讀:誠實注意力頭研究:調整Qwen的29個頭,18/34案例變化代表什麼?
延伸閱讀:Tess-4.5 本機模型開放權重:與 Qwen 並列總分,較少輸出能省多少時間?