NVIDIA DGX Spark(GB10 128GB)本地實戰解析:單機跑 200B 大模型的桌面超算值不值得買?
NVIDIA DGX Spark 是什麼?搭載 GB10 Grace Blackwell 超級晶片與 128GB 統一記憶體,能單機運行高達 200B 參數本地大模型。解析它與 RTX 5090 桌機及 Mac Studio 的真實定位差異。

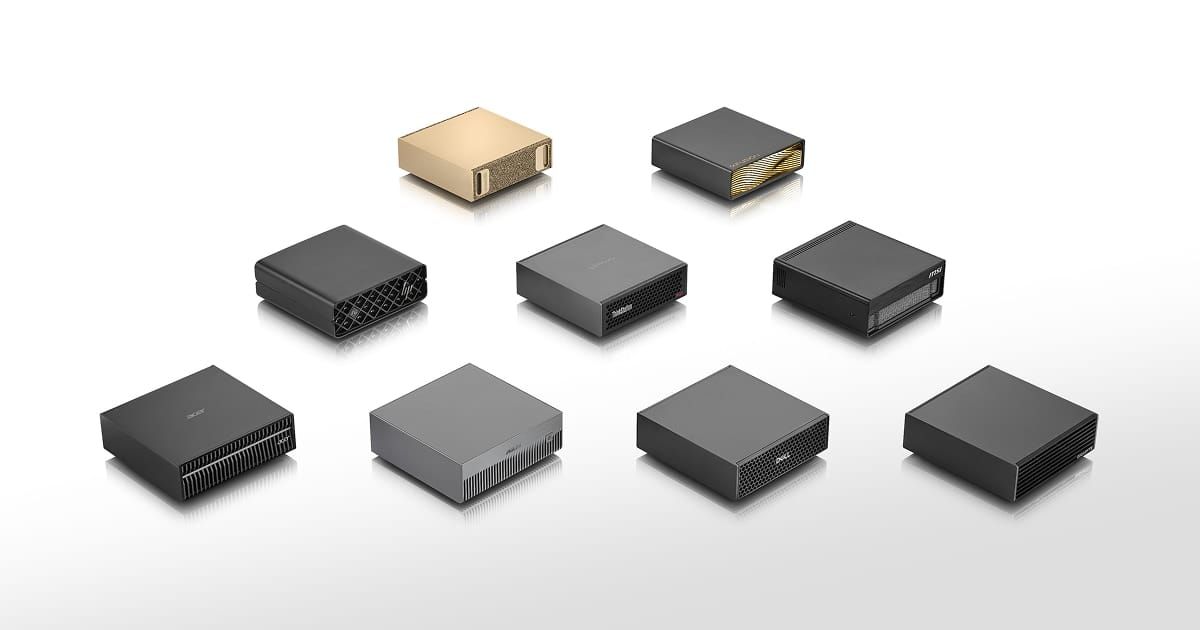
過去想在本地端微調或運行 120B 到 200B 參數等級的開源大模型,開發者只有兩個選擇:要嘛花上百萬元買一台吵到像吸塵器的機架式伺服器,要嘛改買蘋果最高階的 Mac Studio 忍受特定框架限制。
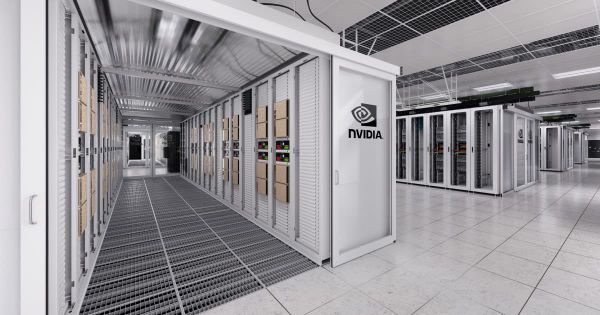
輝達推出的桌面級個人 AI 超級電腦 NVIDIA DGX Spark(核心搭載 GB10 Grace Blackwell 超級晶片),正是為了把「百億甚至兩千億參數級別的 CUDA 開發環境」直接放上工程師的辦公桌。
這台體積迷你的工作站透過 NVLink-C2C 互連技術,把 20 核心 Arm 架構 Grace CPU 與 Blackwell GPU 綁在一起,並共享高達 128GB 的 LPDDR5X 統一系統記憶體。
這意味著你不用組裝四張獨立顯卡,就能在完全原生支援 NVIDIA CUDA、TensorRT-LLM 與 DGX OS 的環境裡,單機載入並測試過去只有機房才跑得動的超大型模型。
對正在做私有模型微調、需要原生 CUDA 生態來對齊雲端機房環境的台灣 AI 新創與研發工程師來說,看懂 DGX Spark 與 RTX 5090 之間的「容量 vs 頻寬」取捨,才能決定預算該投在哪一邊。
接下來,我們拆解它的架構特性與實務限制。
延伸閱讀:輝達 RTX Spark 迷你 AI 桌機全面開賣!華碩、戴爾、微星齊發,128GB 統一記憶體把 120B 大模型搬上桌面
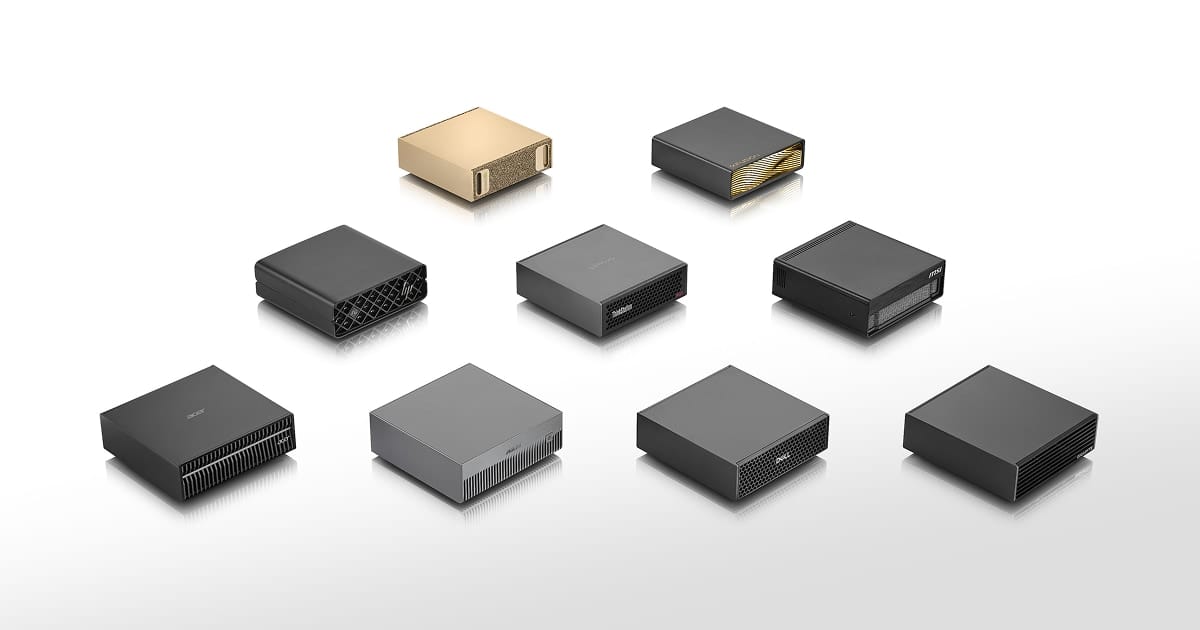
為什麼輝達要做一台「用統一記憶體、而不是塞滿 HBM」的桌面機?
傳統企業級 GPU(如 H200 或 Blackwell 資料中心卡)雖然擁有極高的記憶體頻寬,但單張售價動輒數萬美元且功耗驚人,不可能買來放在每位研究員的書桌上當開發測試機。
NVIDIA DGX Spark 官方設計 借用了與蘋果類似的統一記憶體思路,但保留了輝達最無可取代的 CUDA 軟體護城河。
這讓開發者在個人桌面上寫完的訓練、量化與微調腳本,幾乎不用修改底層程式碼就能直接推上雲端 DGX 機房大規模擴展,甚至也能透過兩台 DGX Spark 串聯挑戰更大規模的參數。
| 本地 CUDA 開發機對比 | 單張 RTX 5090 桌機工作站 | NVIDIA DGX Spark(GB10 128GB) |
|---|---|---|
| 可用統一/顯存容量 | 32 GB VRAM(受限於單卡顯存) | 128 GB 統一記憶體(可載入 ~200B 模型) |
| 單人生成吐字速度 | 極快(GDDR7 超高頻寬優勢) | 中等(受限於 LPDDR5X 統一記憶體頻寬) |
| 核心定位與最佳用途 | 單卡極速推論、27B–32B 日常寫碼 | 超大模型原型驗證、LoRA 微調與雙機串聯 |
購買前必須認清的兩個物理現實:頻寬與 Arm 架構
雖然 128GB 統一記憶體聽起來非常夢幻,但採購前有兩個現實一定要先看清楚。
第一是 LPDDR5X 統一記憶體的頻寬先天低於獨立顯卡的 GDDR7 或資料中心 HBM,因此拿它來跑 120B 以上巨型模型時,定位偏向「跑得動、能做研究與微調驗證」,吐字速度不會像 RTX 5090 跑 32B 模型那樣飛快。
第二則是它的處理器屬於 20 核心 Arm 架構(Grace CPU),搭配的是以 Linux 為基礎的 DGX OS。
如果你的日常工作高度依賴某些只提供 x86 Windows 圖形介面的傳統軟體,它並不能當成你唯一的萬用辦公桌機,而是最適合當成「接在內網角落的專用 AI 開發節點」。
延伸閱讀:24GB 顯卡能跑多大本地模型?RTX 4090 與 RTX 5090 的 4-bit 量化與 KV Cache 實戰門檻
誰最適合入手 DGX Spark?誰又該回頭買顯卡或 Mac?
如果你的團隊需要每天在 純 CUDA / PyTorch / vLLM 環境 下測試超過 70B 參數的模型、做企業私有資料微調,而且不希望為了裝多張卡去改造辦公室電力與冷氣,DGX Spark 是最省空間的標準化方案;反過來,若你只是想自己安靜地跑現成 GGUF 模型寫程式,單張 RTX 5090 桌機或 128GB Mac Studio 在價格與互動速度上往往更符合個人體感需求。
常見問題(FAQ)
Q1:DGX Spark 可以安裝 Windows 系統拿來玩遊戲嗎?
不行。它是專為 AI 開發與運算設計的桌面超級電腦,搭載 Arm 架構 Grace CPU 與輝達官方 DGX OS(Linux 生態),並非一般消費級 x86 遊戲桌機。
Q2:128GB 記憶體真的能跑得動 200B 參數的模型嗎?
透過 4-bit(如 FP4 / Q4)量化壓縮後,約 200B 參數的模型權重正好能塞進 128GB 記憶體範圍內進行單機推論;但若要同時做全參數微調或開極長的上下文視窗,仍建議留足緩衝或利用雙機互聯擴展。
Q3:它跟華碩、戴爾或微星推出的 RTX Spark / GB10 桌機有什麼關係?
底層同樣採用輝達 GB10 超級晶片與 128GB 統一記憶體架構,屬於同系列的桌面級 AI 運算平台生態,台灣消費者在通路採購與保固維修上也多了各家台廠品牌選項。
Q4:已經有 Mac Studio 128GB 了,還需要買 DGX Spark 嗎?
如果你只是跑推論對話,兩者在容量上重疊度很高;唯有當你的工作流程強制依賴 NVIDIA CUDA、TensorRT-LLM 或需要把開發完的容器原封不動推上雲端 NVIDIA 叢集時,DGX Spark 才具有不可取代性。
結語:把「原本屬於機房的開發環境」縮進便當盒裡
NVIDIA DGX Spark(GB10 128GB) 並不是要取代消費級遊戲顯卡,而是幫 AI 工程師解決「本地筆電顯存太小、雲端租多卡 H100 又太貴」的中間斷層。
評估採購前,記得先問自己一個問題:你需要的是「單人極速吐字」,還是「單機裝得下 120B+ 的原生 CUDA 沙盒」?想清楚這點,錢就不會花錯地方。
歡迎免費訂閱 AI 郵報,每週追蹤更多實測工具教學與本地硬體深度評測。