ReGap-Bench 視覺推理研究:圖上加編號,如何補上物件參照?
ReGap-Bench以成對視覺題研究參照落差,解析編號、著色與格線對計數、時鐘及地圖代理的不同影響。說明11.3個百分點改善、格線退步,以及小樣本和模型規模的限制。

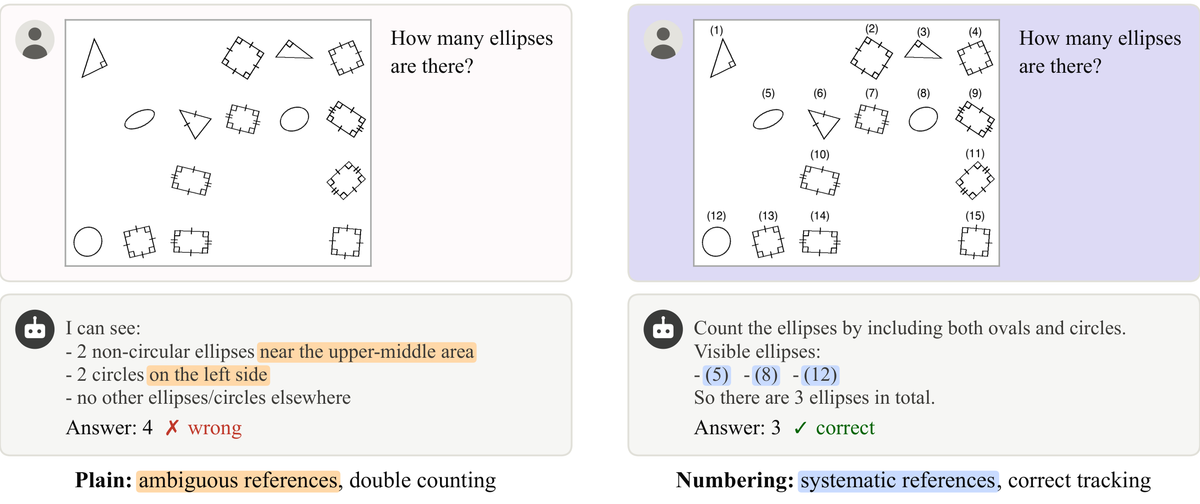
ReGap-Bench 把視覺 AI 容易答錯的一種情境拆出來:模型認得圖形,卻在多步推理時弄混自己正在說哪一個物件。
例如計算橢圓數量時,用左上方或中間描述位置,可能讓同一個橢圓被重複算進答案。
作者在 2026 年 11 月 3 日介紹這套成對評測,讓場景、問題與答案維持一致,只改圖片上提供的參照。
結果顯示,編號、著色與格線需要配合任務使用。加錯標記可能沒有幫助,甚至讓答案更不準。
這讓圖像前處理有了可測試的用途。對開發視覺代理的團隊,應先問推理缺少哪種定位依據,再決定是否標圖。
要理解效果從何而來,先得把認得物件和持續指向同一物件分開。
ReGap-Bench 如何區分看見物件與指對物件?
視覺模型回答問題時,經常需要先看見物件,再持續追蹤它。例如比較兩個圖形大小,必須確定後面提到的「這一個」仍是原來那個物件。如果參照在推理過程中漂移,即使每個圖形都被辨識出來,最後答案仍可能錯誤。
ReGap-Bench 把這種現象稱為參照落差,重點在於模型能否穩定指向同一個目標。研究並未把所有視覺錯誤都歸因於參照。
影像模糊、辨識失敗與知識不足,仍可能造成其他問題。這次評測希望先把其中一項可控制因素拆開。
相關論文於十月二十九日公開,作者在十一月三日介紹研究。研究提出的編號、著色與格線,像是替推理增加可引用的座標或名稱。它們沒有更換場景裡的真實答案,而是改變模型組織證據時可以使用的依據。
這類輔助標記看起來簡單,卻有明確的失敗風險。編號可能遮住細節,格線可能讓原本簡單的畫面更雜亂。如果不知道題目缺少什麼參照,只是一律把圖片標滿,就可能增加負擔,而非改善推理。
因此,研究真正值得追問的不是「標圖有沒有用」,而是「哪一種標記對哪一種任務有用」。這個問題能讓影像前處理從裝飾或經驗法則,變成可以與原圖對照驗證的設計。
成對題目如何控制場景與參照差異?
ReGap-Bench 包含五類視覺任務,使用成對設計比較有無輔助標記的表現。每一對維持相同場景、問題與答案,只改提供的參照。這讓分數差異更能對應標記條件,而不是圖片內容或題目難度剛好不同。
計數任務例如讓模型辨認一群目標,再給每個目標穩定編號。時鐘任務則能控制錶面數字的密度,觀察時間判斷是否改善。角度與大小問題可以透過著色突顯比較範圍,格線則提供空間位置與變換的依據。
這些輔助的作用不同。編號偏向讓同一物件具有固定名稱,著色偏向區分要比較的區域,格線則提供共同的空間基準。它們可能都讓圖片更容易描述,但不應被當成可互換的同一種方法。
研究設計也提醒實作者,必須保存原圖與處理後圖片。若前處理意外改變了物件輪廓、遮住關鍵數字或移動了位置,題目本身就可能不再相同。這時成績變化不能單純解釋為參照改善。
不讓標記偷偷帶入答案
一個好的標記應協助定位,而不是直接提供題目的答案。例如替每個物件編號,與把正確答案寫在角落,顯然不是同一件事。使用外部工具產生標記時,也要確認工具沒有利用評估答案來挑選有利畫面。
在自己的產品中重現這種比較,應先固定問題與評分方式,再讓同一模型讀原圖與標圖版本。若同時改提示、模型或答案格式,雖然仍可測整體流程,卻很難知道究竟哪一個改動帶來效果。
編號、著色與格線,分別幫助哪些工作?
研究中,計數題的編號輔助平均改善為 11.3 個百分點,著色為 1.7 個百分點,格線則下降 4.1 個百分點。這裡比較的是正確率的差值,不是相對改善比例。各種方法也並未得到一致方向的結果。
編號對計數有直觀幫助:模型能依序指出每個目標,減少漏算或重複計算。格線雖然提供位置,卻未必提供每個目標唯一的身分。當數個物件落在同一格,或同一物件跨過多格,仍可能造成參照混淆。
這種解讀符合研究提出的參照問題,但不應把它當成所有模型都已被證實具有相同內部機制。評測觀察的是輸入改變後的行為差異,至於模型內部如何處理每個標記,仍需要其他方法研究。
角度與大小題更需要突顯比較對象及其邊界,因此著色與格線有不同用途。實務上應先判斷錯誤來自找不到物件、對不齊範圍,還是量測關係本身。不同失敗原因,會導向不同的前處理選擇。
格線在計數中的負面結果也有價值。它說明加入資訊不必然讓任務更容易,額外線條可能與原本圖形競爭注意。產品團隊若只保留有幫助的展示,就會錯過這種需要關閉標記的情況。
因此,比較應包含無標記基準,而且要看每一類任務,而不是只報總平均。某個方法在大類表現很好,仍可能讓特定小類退步。當系統面對混合問題時,是否能判斷何時不加標記,也成為流程的一部分。
完整參照與模型規模,如何影響成績?
在時鐘題中,研究依序增加錶面數字,讓參照由稀少變得完整。沒有數字、兩個數字、四個數字與十二個數字的平均成績,分別為 23.9%、25.3%、31.8% 與 38.0%。
這是一組指定題目與模型的結果,不是所有時鐘圖片的通用正確率。
這個變化支持參照密度可能影響判讀。完整數字能讓指針位置對應到較明確的名稱,減少只靠方向描述的負擔。但即使參照最完整,成績仍未接近全部正確,顯示標記並未解決這類問題中的所有困難。
同樣地,若時鐘本身解析度很低,新增數字不一定能恢復看不清楚的指針。輔助參照改善的是定位與對應條件,不能取代原始影像品質。這讓資料品質檢查與標記設計仍需要分開進行。
模型規模的分析則顯示,較大模型在原圖與編號條件下都可能進步,但兩種條件之間仍存在落差。這不能被寫成大模型沒有幫助。較準確的理解是,增加規模與改善輸入參照可能處理不同部分的困難。
增加模型規模和改善參照,都是選型時可以比較的方向。有時先改善參照值得嘗試,但研究沒有證明它總比換模型有效。要替具體產品做決定,仍需用相同問題比較品質、延遲與處理成本。
一個實際做法,是先收集容易弄混目標的錯誤例子,再看編號是否降低重複計數,或格線是否改善定位。這比在所有圖片上增加相同覆蓋層,更能讓變更的理由對應到可測的失敗類型。
地圖代理的外部測試,能推論到哪裡?
除了合成視覺題,作者也在 CartoMapQA 進行一百道分層抽樣的地圖問題測試。
代理使用 Codex GPT-5.5,能自行決定是否加入覆蓋標記。這讓標記選擇進入工具流程,觀察它在較接近代理操作的環境中如何使用。
一百題中,代理對五十七題加上標記:四十一題用編號、十三題用格線、三題用著色。其餘四十三題不加標記。這個分布很重要,因為每一類改善的樣本數差很多,不能只看百分比大小來判斷哪種方法最好。
編號子集的成績由 63.7% 至 70.1%,格線由 92.5% 至 96.7%,著色由 33.3% 至 66.7%。著色差距看起來最大,卻只有三題,因此尤其不適合推論成穩定、普遍的改善比例。
沒有加標記的四十三題中,多數答案維持不變。這顯示代理不必對每題都進行影像處理,但也不能只由此證明它已學會最佳策略。要評估選擇是否理想,還需要知道被略過的題目是否本來就不需要標記。
這項外部測試擴大了研究範圍,卻仍只是特定模型、題組與工具條件。不同地圖樣式、語言或互動任務,可能需要不同參照。研究支持把這類標記當成可選工具,尚不足以保證所有視覺代理都能得到相同效果。
將覆蓋層納入可回查紀錄
若代理自行產生覆蓋層,應保存它選了哪些目標、編號如何對應原圖,以及後續回答引用了哪個標記。否則即使最後答案正確,也難以判斷工具是否真的解決了原先的參照問題,或只是碰巧答對。
當工具辨識錯誤時,穩定編號也可能讓錯誤看起來更有條理。例如漏掉一個物件,再替剩餘物件逐一編號,仍會得到錯誤計數。這說明前處理的品質本身也應驗收,不能因為標記清楚就忽略其完整性。
若圖片含有原本的文字與圖例,覆蓋層還應避免遮擋,並保留原始版本供核對。標記方法若改變了可見資訊,就需要另外判讀其影響。研究中的成對控制,正好提供一個要求輸入處理保持可比較的理由。
此外,官方專案頁提供的網站內容授權,不應自動延伸為所有程式、資料與外部圖片都有相同條件。實際重用時仍要回到各項來源。這與方法是否有效是兩個問題,不能因為研究公開就省略素材與程式的使用條件。
同樣的標記策略也可能影響延遲:代理先辨識物件、產生覆蓋層,再重新讀圖,會增加處理步驟。因此採用時不只要比較答對多少,也應記錄額外等待與標記失敗。如果品質沒有改善,新增工具呼叫就沒有充分理由保留。
對需要向使用者解釋答案的產品,穩定編號還能讓回答指回具體目標,例如說明某兩個標號的相對位置。不過可解釋的文字仍需對照原圖,因為編號只是參照,沒有替幾何推理本身提供正確性保證。
ReGap-Bench 常見問題
是否應替所有輸入圖片加上編號?
不宜直接一律套用。編號在計數中有明顯幫助,其他任務可能需要不同參照。格線甚至在指定計數測試中退步。應先確定失敗類型,再用原圖對照測試效果,保留不處理圖片的選項。
這項研究是否證明換大模型沒有用?
沒有。模型規模增加時,原圖與標記條件都可能進步。研究指出參照落差仍存在,並非否定規模提升。兩種方法可以分別比較,也可能一起使用,仍需依任務成績判斷。
地圖測試中的著色提升是否最值得採用?
不能只看幅度。該子集只有三題,樣本太少,容易受單題影響。較合適的下一步,是擴大相同類型題目並重跑對照,而不是把一次小樣本比例直接當成產品預期成效。
讓每種視覺標記都有可驗證的用途
ReGap-Bench 提供一種具體的研究視角:視覺推理除了看見內容,也需要穩定引用內容。
當標記能對應明確的參照缺口,團隊就能用成對測試驗證。當它只增加雜訊,也能及早停用。這比把所有錯誤都歸給模型不夠大,更容易找到可改進的環節。
想持續追蹤 AI 研究方法與可驗證的技術進展,歡迎免費訂閱 AI 郵報。
延伸閱讀:LOWN 視覺語言研究:少看幾次同一張圖,能省下多少運算?
延伸閱讀:AgentVQA 用一千題測視覺代理:最高 58.5%,為什麼會推理仍可能按錯按鈕?