Together Compiler 推出持續推理最佳化,AI 代理如何依流量改寫執行方式?
Together Compiler 讓 AI 代理持續調整推理執行方式。拆解持久引擎、252 倍實驗吞吐與最高 2.6 倍推理數字,以及正式部署和有限測試的差異。

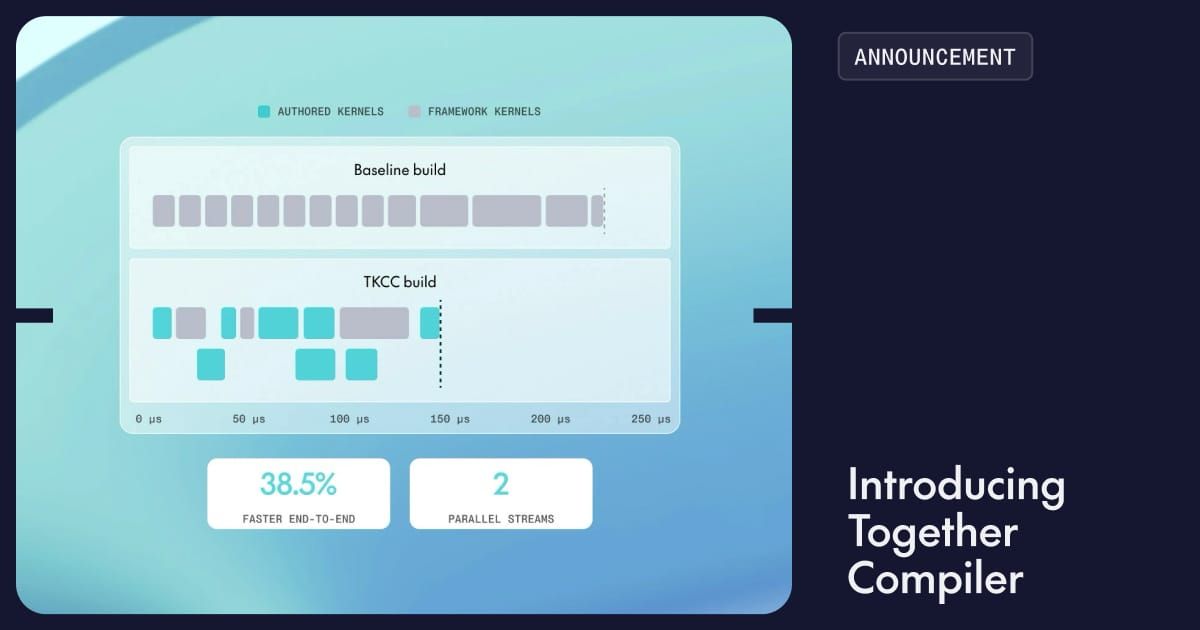
開放模型換得快,使用者輸入長度和同時上線人數也會改變,推理服務很難一直沿用同一套最佳設定。
Together Compiler 讓 AI 代理持續產生並測量最佳化方案,隨流量改變重新調整推理執行方式。
Together AI 在十一月四日公開這套系統,並把它放在 Polymorphic Inference 的研究方向下。
公司稱系統已用於部分正式環境端點,提供給終端客戶的客製使用則仍是有限測試。
實驗吞吐提高二百五十二倍和推理吞吐最高提高二點六倍,描述的是這條流程裡兩種不同改善。
對採用開放模型的團隊而言,值得先理解的問題,是代理為何能更快試出適合當下流量的執行方式。
Together Compiler 為何要隨流量持續編譯?
固定設定可能隨上下文長度、併發與模型架構改變而失去優勢,因此最佳化需要持續跟上工作負載。
推理是模型接收輸入並產生回答的過程。服務業者要決定如何把計算分配到晶片、怎麼安排多個請求,以及哪些運算可以合併,才能在成本和等待時間之間取得合適結果。
但使用者不會一直送來相同工作。短聊天和長時間代理的輸入大小不同,同時到來的請求數也會變動,原本適合一種流量的設定,換個情境就可能出現空轉或等待。
Together 在研究文章中舉例,不同國家工作時間的提示長度可以有差異。新模型剛推出時,使用者先聊天與評估,之後轉向代理工作,輸入也跟著變長。
這些觀察解釋了公司為何提出多形態推理。Polymorphic Inference 描述的是,服務要隨模型、硬體與流量形狀改變,持續調整執行方式。
Together Compiler 是這項方向下的一個具體系統,簡稱 TKCC。它把流量特徵、模型與硬體當成輸入,讓代理提出推理引擎的最佳化方案,再透過量測找出較合適的做法。
這使調校從固定一次的設定,變成可反覆運作的搜尋流程。當使用者行為改變,系統便能重新嘗試,觀察先前的最佳方案是否仍有優勢。
不過,反覆搜尋首先需要足夠快的實驗工具。若每次改一點程式,都要等推理服務重新啟動,代理能提出再多點子,也會卡在等待驗證。Together 官方研究文章
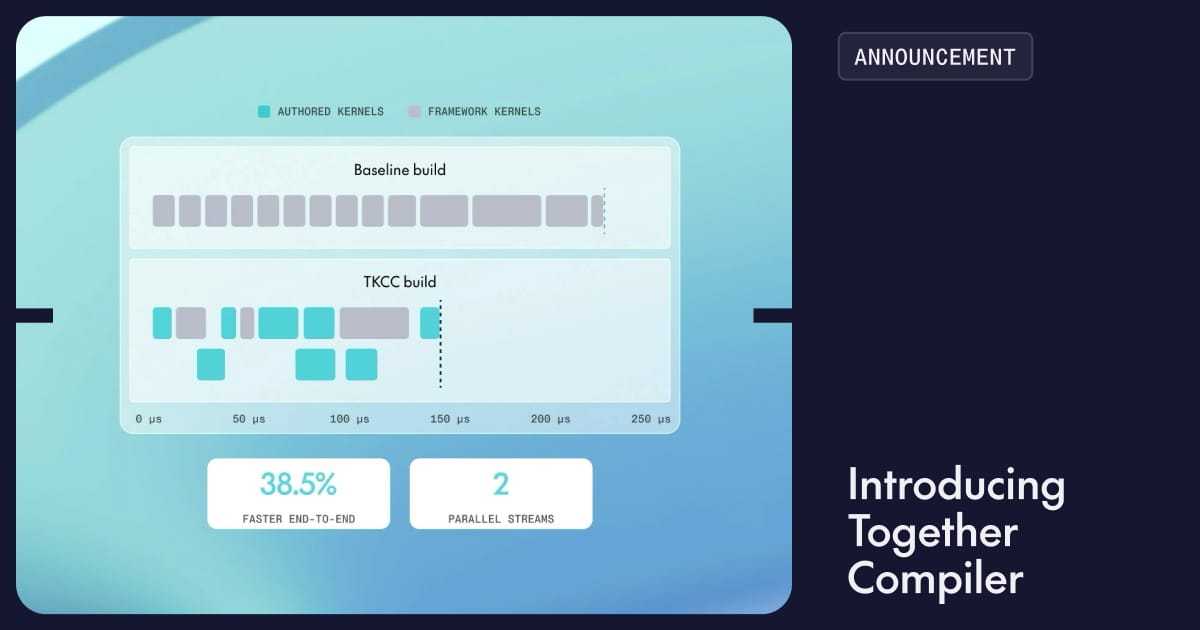
Introducing the Together Compiler: continual compilation for AI inference! I’m super proud to finally share this work from our research team! ✨
— Simran Arora (@simran_s_arora) November 4, 2026
Today’s inference is “Polymorphic” or shape-shifting, it doesn’t sit still. On OpenRouter, 80% of traffic goes to models released in… pic.twitter.com/wzLNbKy8y4
研究作者發布的本次編譯器官方示範影片。 來源:官方原始貼文。
持久引擎如何讓 AI 代理快速試驗?
模型常駐的引擎能熱載入候選程式,代理就能省去反覆啟動推理服務的時間。
一般實驗可能需要啟動工作程序、載入模型權重、準備快取,再暖機與調校運算。模型權重是訓練後的核心參數,資料量大,重新搬進硬體會占去不少時間。
如果每個候選方案都走一次完整啟動,昂貴的晶片就可能在等待引擎準備。這段時間和測量候選程式的效果無關,卻限制了每小時能完成多少嘗試。
TKCC 改用持久引擎,讓服務啟動一次後繼續存在,再熱載入新的前向計算候選。前向計算就是模型依輸入算出結果的執行過程,代理主要調整這條程式路徑。
官方表格列出一個啟動比較,原流程到可服務約四百六十七秒,TKCC 對應路徑約九秒。它呈現的是特定準備流程省下的時間,整個實驗系統的吞吐則另外測量。
為了讓引擎持續有候選方案可測,系統同時使用多個代理提出改法。代理透過訊息板協調工作,讓不同嘗試能平行進行,再交給共同量測流程。
這樣的分工把「想出改動」和「證明改動有效」接在一起。代理的程式產出有了較快的回饋,便能依測量結果繼續縮小搜尋範圍。
晶片也因此有機會花更多時間在實際測試,而非重複初始化。實驗次數增加,系統才比較可能在有限時間內找到配合當下流量的方案。
但快試很多次還有一個問題。小範例上量到的加速,放回完整模型與真實資料後,可能會出現不同結果,因此 TKCC 還需要第二層驗證。
實驗更快,如何確認完整服務也更快?
Together Compiler 分成快慢兩層引擎,先快速篩選,再用較完整的真實分布驗證。
快速引擎只載入較少模型層,能降低單次測量成本,適合快速比較候選方案。較慢的引擎載入更多層,用來檢查改善能否在較完整的執行情境維持。
這個差別和模型架構有關。部分模型會依輸入,選擇不同專家或稀疏注意力計算路徑,資料分布改變時,硬體實際執行的工作也會跟著不同。
以混合專家模型為例,同一批隨機輸入可能讓負載較平均,真實請求卻集中在某些專家。若只用隨機資料量測,就可能挑到不適合正式流量的方案。
因此,較完整的測試要能保留這些資料特徵。快速引擎提供大量嘗試,後段驗證再淘汰無法延續效果的候選,兩者共同平衡速度與可信度。
系統還用成本模型選擇平行策略,也就是決定模型和請求如何分配到多張晶片。硬體規格可以提供起點,但真實輸入長度和專家負載,仍可能改變最佳配置。
官方把硬體資料、微型測試與實際前向計算結果結合,用來縮小需要搜尋的設定範圍。這讓代理能優先投入較有機會改善的方案,減少把每種配置都完整測過的負擔。
對部署團隊而言,這套設計顯示輸入資料本身也是最佳化條件。比較兩套推理服務時,若請求長度、快取比例和併發不同,測出的差異就不只來自程式。
因此,理解官方結果時,也要把試驗效率與最終推理效能各自放回比較基準,才能知道哪些數字能對應使用者體驗。
252 倍與最高 2.6 倍,各自比較了什麼?
二百五十二倍衡量代理能嘗試多少實驗,二點六倍則對應特定推理基準的輸出吞吐。
官方表示,TKCC 相較基準代理最佳化系統,有二百五十二倍的實驗吞吐。這項改善使系統能在相同時間測更多方案,成果要再由推理測試確認。
在 SemiAnalysis 的 AgentX 工作負載比較中,研究從已公布的最佳開放推理引擎設定出發,聲稱不到二十四小時內,推理吞吐最高提高二點六倍。
吞吐描述單位時間能輸出多少 token,實際服務還要同時看每位使用者的生成速度。大量請求一起處理時,整體產出增加和單一使用者等多久,需要分別量測。
低延遲情境另有具體結果。官方報告 MiniMax M3.1-Flash 每秒一千一百一十一個 token,DeepSeek v4.1-Flash 每秒一千二百零五個 token,條件為批次大小一與其選定的硬體和平行配置。
另一組一點七倍則使用 Llama 1B、批次大小一,比較手工調校的巨型核心等基準。這是另一種模型與任務,和前面的高階開放模型吞吐不能合併成一個普遍倍率。
研究也註明 Trainium2 的比較例外。因為記憶體容量與目前實作的併發限制,該部分採合成多回合資料,包含較長輸入與高快取比例,適用範圍需連同條件閱讀。
以上成績由 Together 自行公布,仍待其他團隊重現。對採購或部署決策而言,它們說明持續調校可能有收益,自己的任務則需要保留相同品質與負載重新比較。
例如,若團隊重視互動等待,就要看每位使用者的延遲分布。若主要處理大量離線工作,則可以把整批完成時間和資源成本放在一起觀察。
這兩種需求會選出不同設定,也正好回到多形態推理的出發點。基準揭示最佳化空間,客戶能否實際採用還取決於提供方式。
語言模型之外,這種迴圈能測什麼?
研究還選用天氣建模、偏微分方程式、時間序列與生物領域的開放程式,測試相同最佳化原理能否延伸。這些工作各有不同運算,因此需要自己的正確性與效能條件。
官方比較基準之一,是直接使用 Claude Code 的目標指令進行最佳化,再觀察 TKCC 的幾何平均加速。這項比較回答的是同類程式最佳化任務,和前面推理服務的每秒輸出量有不同分母。
這段實驗讓持久引擎與量測流程具有更廣的研究意義。當候選程式能快速送進接近實際環境的測試,代理就有更密集的回饋,可以依據結果繼續找方向。
若團隊想借用這種方法,第一步仍是把自己的正確輸出和計算條件定清楚。較快得到錯誤結果會改變任務本身,只有在輸出符合要求時,加速才有可比較的意義。
因此,效能報告最好同時保留版本、輸入分布與驗證方法。這些條件讓後續重新調校可以沿同一個基準比較,也讓不同團隊知道哪些部分能直接重現。
哪些端點已使用,客戶現在怎麼接觸?
Together 已在部分無伺服器端點採用這套系統,客戶自行客製的入口仍是有限測試。
無伺服器端點讓客戶直接呼叫模型,由服務商管理底層運算。公司表示,TKCC 已用在部分常用正式端點,最佳化後的推理服務正在承接實際流量。
這代表內部部署與客戶接入有不同進度。一般端點使用者可能已間接受到引擎調整影響,要替自己的專屬工作負載操作編譯器,則需要申請早期使用。
官方把專用端點的一鍵自行最佳化列為後續方向。客戶可按一下按鈕,自動調整自身工作負載的完整自助體驗,仍屬規畫中的能力。
因此,有明確流量特徵的團隊,較適合先準備模型、硬體需求、輸入輸出長度與服務目標,再向供應商確認有限測試是否適合自己的情境。
這些資料也會影響如何驗收。如果主要請求有長背景和大量快取,測試就要保留相同比例,否則量出的最佳設定未必能套用到正式服務。
若產品改變了代理的工具循環或推理長度,也可以重新比較。因為最佳化針對的是整個執行負載,應用程式行為變了,底層資源安排就可能需要再調整。
官方同時介紹後續研究方向,包含隨流量改變的推測解碼與跨異質部署路由。這些內容描述更大的研發議程,TKCC 則是本次已提出具體方法和數據的部分。官方產品與研究方向說明
常見問題
Together Compiler 會直接重新訓練模型嗎?
本次系統主要搜尋推理執行程式與配置。公開介紹聚焦如何更有效率地運行既有模型,模型後訓練則是公司另外提供的工作流程。
可以直接下載完整編譯器自行部署嗎?
本次公告提供研究介紹與論文,客戶使用列為有限測試。要採用完整服務或客製最佳化,應依官方提供的接入方式確認。
加速後就會自動降低模型 API 費率嗎?
官方公開的是系統效能結果。客戶費用仍依實際服務方案與報價,因此評估時需要把自己的用量、延遲與帳務成本一起比較。
用實際服務的成本與延遲決定導入
使用開放模型、而且流量特徵明確的團隊,可以先用同一組真實請求建立比較基準。確認品質相近,再看成功完成工作的總成本與等待時間,才容易知道持續編譯帶來多少實際收益。
延伸閱讀 NVIDIA AI Cluster Runtime 是什麼?五步驟驗證 Kubernetes 與 Dynamo 推論環境
延伸閱讀 GitHub 公開 Copilot 模型評測:成功率之外,每題成本與推理設定怎麼選?