TwIL-8B 開放推理權重,短思考版本為何還要花近兩萬 token 解題?
TwIL-8B 開放長短思考兩份權重,解析數學與程式成績的版本差異、近兩萬 token 的代價、本機容量與非商用授權,避免把最高分和最短輸出拼在一起。

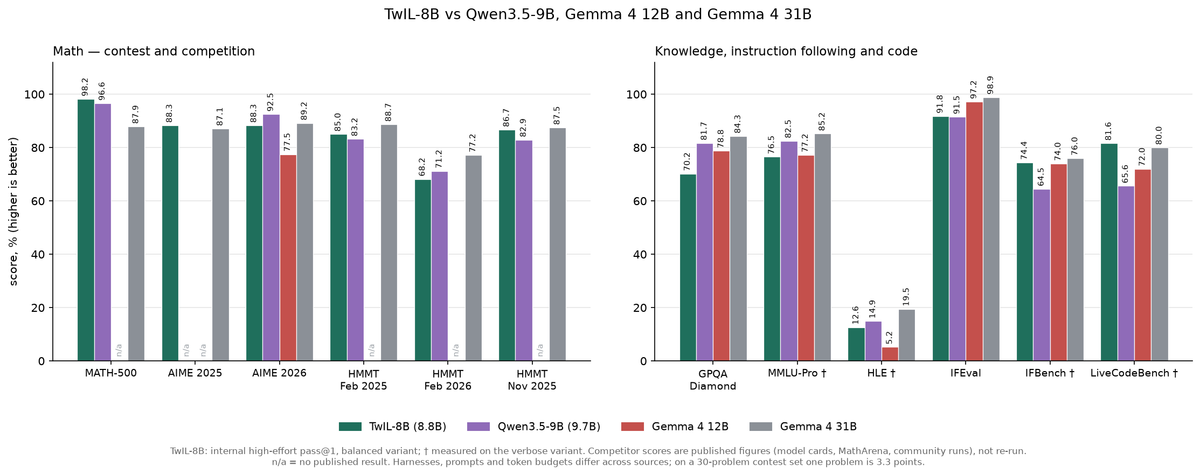
TwIL-8B 把小型推理模型的問題說得很具體,參數較少,並不代表它為了解出一題,就一定花更少的時間與運算。
webAI在2026年11月4日宣布開放權重,主打數學、程式與指令遵循。它從IBM的Granite 4.2底座繼續訓練,將能力集中在這些可檢查的任務。
模型提供長思考與較短思考兩個版本,後者是在前者之上,再用偏好較短推理的獎勵訓練而來。因此,兩份權重代表不同的品質與輸出長度取捨。
但官方成績表有些項目只測過長思考版本。若把全部分數都當成預設下載版本的能力,就會得到一個實際不存在的組合。
即使選較短版本,解一道競賽數學題仍可能平均輸出近兩萬個token。Token是模型使用的文字單位,長度減少和整段運算變便宜,還需要更多條件才能連在一起。
這份開放材料適合研究本機推理配方的人。判斷價值時,要同時比較解題表現、思考長度與實際授權,而非只挑一個接近大型模型的分數。
先把兩個版本的訓練目標拆開,就能看出模型為何會在「想得更久」和「提早作答」之間做選擇。
TwIL-8B 的長短思考版本怎麼訓練?
兩個版本共用架構,但後續獎勵不同,因此它們不是同一模型切換顯示模式,而是需要分別載入的權重。
依官方模型卡,實際規模約87.9億個參數,採用稠密架構。也就是生成文字時,主要參數都會參與運算,不能把它和只啟動少數專家的模型直接按總參數比較。
訓練先讓整份模型學習數學、科學與指令遵循的推理範例,建立作答方式。這一階段並非只加上一小組可拆卸的調整參數,而是更新完整模型。
接著,團隊用強化學習獎勵較好的答案,得到verbose版本。它傾向寫出較長的推理過程,願意用更多文字逐步檢查問題。
再往後,訓練會加入長度條件,參考不同領域的推理長度,鼓勵模型用較短路徑完成工作,得到balanced版本。
長度獎勵的意義,是讓「多寫一些」不再總是較划算的策略。但如果過早結束會增加答錯機會,模型仍需在短答案與正確結果之間取捨。
這也解釋為何名稱中的balanced應該被理解為配方選擇,而非一個可以保證兼得所有優點的標籤。它只是用另一種訓練目標,調整模型願意付出的思考量。
下載時,儲存庫根目錄是balanced,長思考版本放在另一個資料夾。兩者都是合併完成的完整模型,不需要先下載底座再另外套用調整檔。
兩個版本的差異既然進入了權重,就必須回到成績表,逐列辨認數字來自哪一份模型。
The cost of completing a task matters more than the raw intelligence of the model running it.
— webAI (@thewebAI) November 4, 2026
That’s the thesis behind TwIL-8B, our new 8.8B reasoning model. Open weights. Runs on hardware you already own.
Against Qwen3.5-9B, it opens a 16-point lead on LiveCodeBench (81.6 vs… pic.twitter.com/g5O7m0wCt6
官方成績表裡,哪些數字不能放在一起?
先辨認每列的版本與評估方法,才能知道預設下載的模型有哪些能力已經測過,哪些仍是另一份權重的結果。
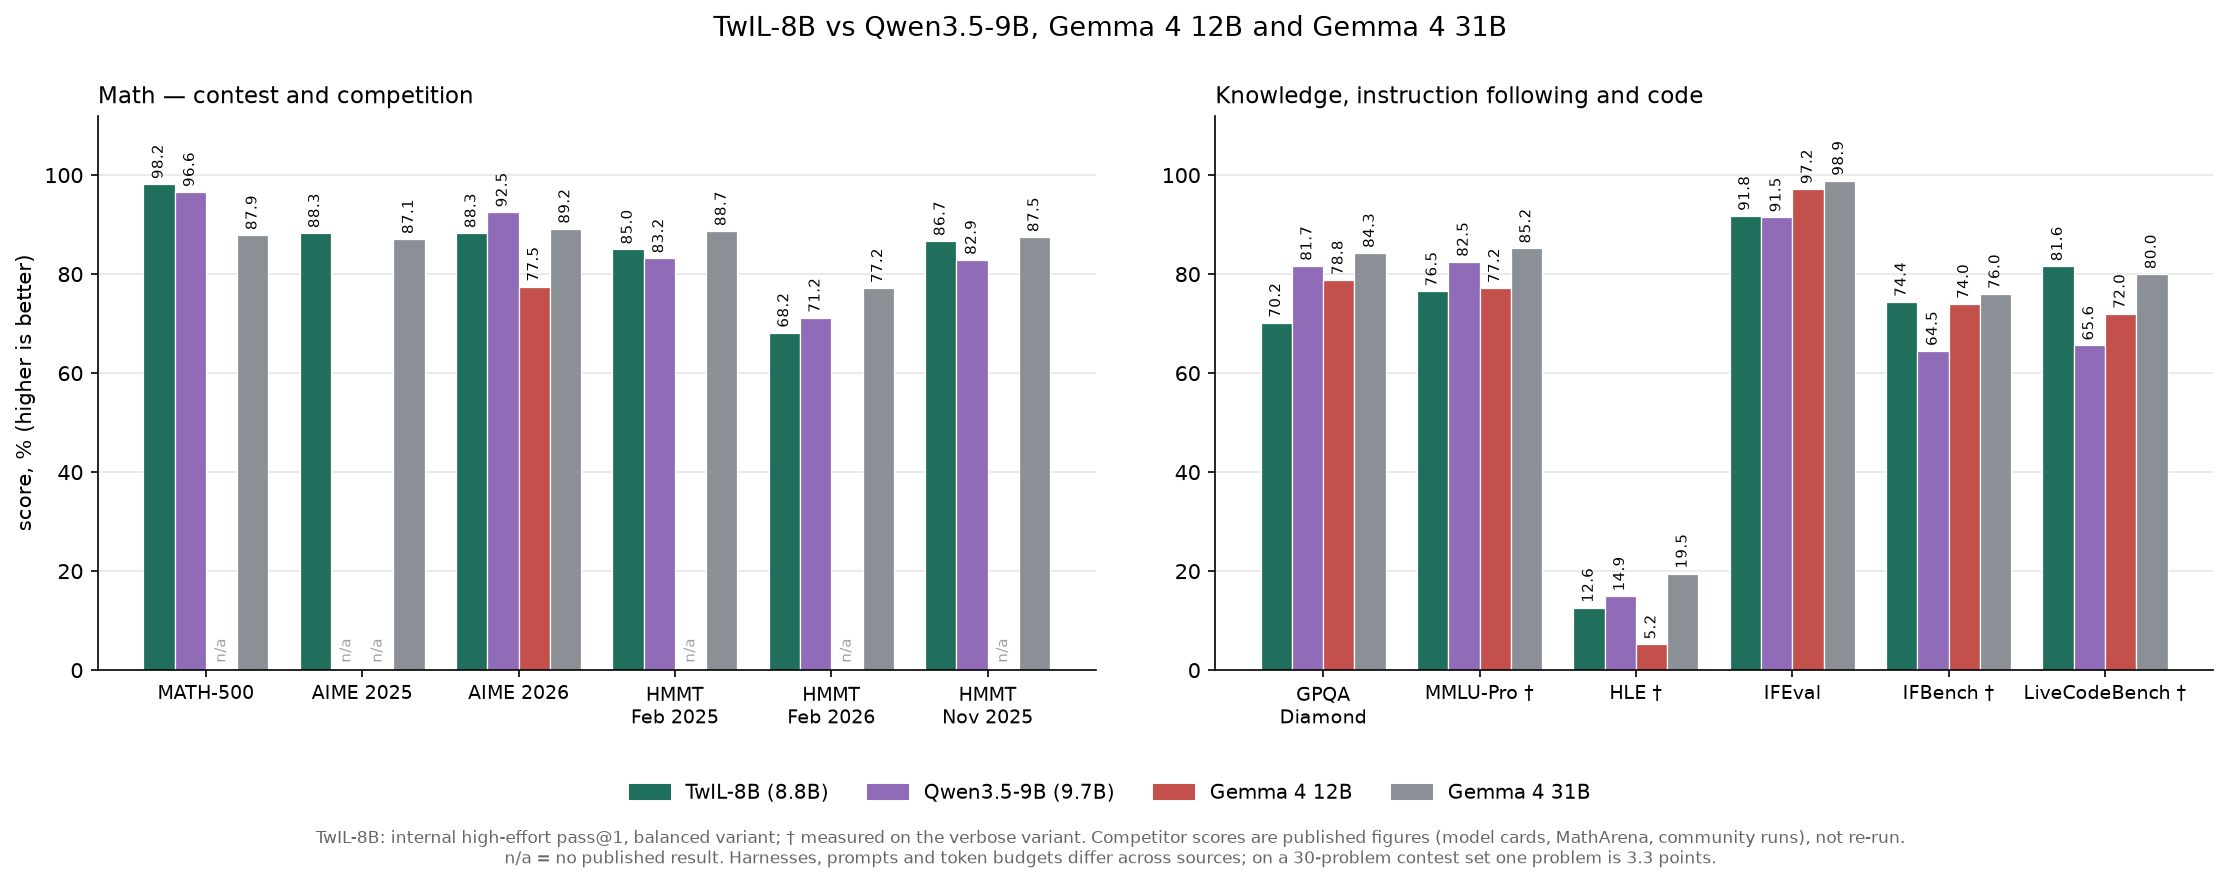
例如MATH-500的98.2分,屬於balanced版本。這套測試是數學解題,但它的高分只能支持該組題目上的表現,不能擴成所有複雜任務都能處理。
LiveCodeBench的81.6分與IFBench的74.4分,則標記為verbose結果。前者檢查程式題,後者檢查指令遵循,官方明說還沒有在balanced上完成這些項目。
所以,若使用者下載根目錄權重,再期待它自然保有所有帶記號的成績,就跳過了版本差異。這不是小數點誤差,而是根本還沒有對應的測量。
比較競品時也有另一個條件。TwIL的數字來自團隊內部評估,其他模型則引用公開模型卡或第三方測試,沒有在同一套環境重新執行。
不同提示、抽樣和輸出預算,都可能影響分數。這些比較可以顯示模型大致擅長什麼,卻不能把每一個小幅差距都當成已控制其他條件的優勢。
程式高分為什麼還不能直接讀成代理能力?
程式測試檢查的是指定題目的答案,代理工作還包含讀檔、選工具、觀察錯誤與持續修正。官方沒有測SWE-bench、工具使用或完整代理任務,因此兩者之間缺少直接證據。
LiveCodeBench還有一項更具體的限制。競品資料標示使用第六版,但TwIL這次測量的版本與題目日期範圍沒有留下紀錄,所以不適合直接宣稱領先某模型十六分。
資料重疊也有未解的部分。團隊用連續十三個單位的文字序列,比對部分數學、科學與指令資料,但程式訓練資料的去重紀錄沒有提供,部分程式題庫也不在列出的檢查集合內。
這不等於已證明模型看過考題,而是讀者不能把某種去重處理,擴成所有測試都已排除重疊。保留這個界線,才能知道分數還缺哪一類驗證。
另一項HLE測試把不同領域的高難度問題放在一起,官方的12.6分同樣屬於verbose。但TwIL用選擇題方式計分,引用的競品則由裁判評讀文字答案,作答形式並不相同。
選擇答案和自行寫出答案,可能讓模型面對不同的難度。這組分數可以提醒研究者知識仍有缺口,卻不適合用來精算它追上大型模型還差多少能力。
知識密集題也顯示另一面。模型在GPQA Diamond得到70.2分,官方承認知識題落後較大模型,顯示推理專精沒有同時補齊所有儲存在權重中的知識。
因此,這份成績最能支持的是指定領域的研究價值。若要把它接到自己的工作,接下來還要看為了得到答案,模型究竟寫了多長的推理。
少用 token,為什麼還不等於更快或更便宜?
文字單位比較呈現的是輸出長度,尚未控制硬體、執行程式、分詞方式和每題是否答對,因此不能直接換成費用或時間的節省。
在AIME 2026測試中,balanced平均每題約用19,500個token,正確率88.3%。官方引用的Qwen3.5-9B數字則是31,200個token與92.5%。
這裡可以同時看見兩種變化,TwIL寫得較短,也少答對一些題目。只保留「少用38%文字」,就會把品質取捨從比較中刪掉。
另一組HMMT 2026年二月競賽題,TwIL約用32,900個token,正確率68.2%。對照模型約用40,600個token、正確率71.2%,同樣不能只憑長度決定誰完成工作更有效率。
這些競賽題組只有約三十至三十三題,一題就可能改變約三個百分點。因此,幾分的差距需要連同題數理解,而非把小幅領先或落後說成穩定排序。
不同模型切分文字的方式也不同。同樣一句推理可能被算成不同數量的token,所以官方把這組長度比較定位為方向性資訊,沒有當成完全相同單位的運算測試。
更短的推理仍可能很長。近兩萬個文字單位代表模型會持續計算相當多步,若硬體每步較慢,參數較少也不會自動讓使用者更快拿到答案。
若工作需要重試,還要把失敗那次的輸出一起計入。這是根據前述品質與長度差異可以推導的比較方式,不是官方已公布的成本實驗。
官方引用的GPT-5.5在相同競賽表裡,使用的文字更少、分數也更高。這提醒讀者,較小模型的價值可能是可在本機研究,未必是任何任務都能省下最多推理。
當目標從「找最短答案」改為「完成特定難題」,設備能保留多少思考空間,也就成了部署的一部分。
延伸閱讀:Tess-4.5 本機模型開放權重:與 Qwen 並列總分,較少輸出能省多少時間?
本機執行要替權重與思考保留什麼空間?
低位元檔能減少權重容量,但長思考仍會占用上下文與輸出空間,兩者需要分開安排。
完整精度的單一版本約16.38 GiB,四位元GGUF約4.98 GiB。GiB是檔案容量單位,這張表描述下載檔,不是整個執行過程只會用掉這些記憶體。
verbose另有約8.70 GiB的八位元格式。不同壓縮程度提供容量選擇,但官方全部成績都來自完整精度權重,不能直接視為每份量化檔也拿到同樣分數。
四位元版本尤其可能產生偏差,因此要選哪一份檔案,仍得看設備容量與實際題目。模型名稱相同,不代表數值表示方式的差異已經消失。
模型卡列出的上下文長度為131,072個token,沿用底座設定。但上下文上限不是每次都會自動分配足夠輸出,應用程式還要設定生成預算。
執行範例還把模型可讀的整段內容,和最多能新寫出的文字分開設定。輸入題目、已寫出的思考與最後答案都要放得下,權重能載入只是第一步。
官方範例讓模型最多產生32,768個新token,因為思考本身就可能寫得很長。如果只給很短的預算,截斷的可能是推理中段,最後答案還沒出現。
關閉思考,會保留展示分數嗎?
聊天模板預設開啟思考,也提供關閉或降低推理程度的設定。這能降低延遲,但官方明說較低努力的分數會明顯下降,成績表沒有使用這些模式。
因此,把模式關掉之後的速度,和開啟思考時的高分放在一起,就又會創造一個未被測量的組合。使用者應讓品質和時間來自同一次設定。
重現展示時也要注意抽樣設定。官方出貨設定使用溫度1與top-p 0.95,會從一組可能的文字中抽樣,所以同一題不必每次走相同路徑,單次快慢不足以概括兩份權重的差異。
模型也沒有在底座以外,另外接受完整的安全、偏好或工具使用訓練。把它裝進聊天介面,不會因此補出原本沒有測過的代理可靠度。
這些條件讓本機選型回到明確用途,研究難題推理可以容忍較長輸出,日常互動則可能更在意回應時間。能否採用,最後還要確認權重允許的使用方式。
延伸閱讀:Spark-X2.6-4B 開放本機代理模型:三檔思考模式,速度與可靠度如何取捨?
哪些用途符合這次開放的授權?
實際條款只允許非商業研究與教育,因此這次開放提供的是研究使用權,不能直接理解為可以放進任何付費產品。
依webAI Non-Commercial License,這項用途限制也延伸到衍生作品。對外散布時,要附上條款並保留原有署名等通知。
Granite底座本身採Apache 2.0,但TwIL的後訓練權重使用另一份條款。底座的授權不會自動把後來的衍生模型改成相同用途範圍。
這會改變研究成果如何落地。個人可以先研究模型在特定數學或程式題的行為,但若要提供商業服務,就不能只憑「公開下載」作為授權依據。
官方同時提供完整與量化權重,使不同設備有參與研究的入口。這和是否允許營利是兩種條件,檔案再小,也不會因此解除用途限制。
TwIL-8B 常見問題 FAQ
預設下載就是81.6分的程式版本嗎?
預設是balanced,LiveCodeBench的81.6分來自verbose。官方尚未在較短版本完成該項測量,不能把兩份權重的成績合併。
四位元模型約五GiB,代表一般電腦一定能順跑嗎?
這只是權重檔大小,還需要執行環境和思考空間。官方沒有提供所有消費設備的速度與完整記憶體測試。
可以直接當成程式代理商用嗎?
模型沒有完整代理任務的測試結果,實際授權也限非商業研究與教育。工具串接與商用權利都不能從程式題分數直接推得。
結論
TwIL-8B 的研究價值,在於公開長短推理配方和兩份可比較權重。它讓小模型在指定任務上的能力與代價,變成可以具體檢查的問題。
如果你想研究本機推理,可先用相同題目比較兩個版本的答對情況、輸出長度與時間,再按用途核對授權。這比把最高分和最短輸出拼在一起,更能支持實際選擇。