PLaMo 3 Translate 開放權重,8B 本機翻譯如何兼顧術語、品質與授權?
PLaMo 3 Translate 開放四種尺寸權重,8B如何靠精煉資料與蒸餾改善翻譯?解析官方評分、量化差異、術語與歷史控制,以及免費商用的登記與營收條件。

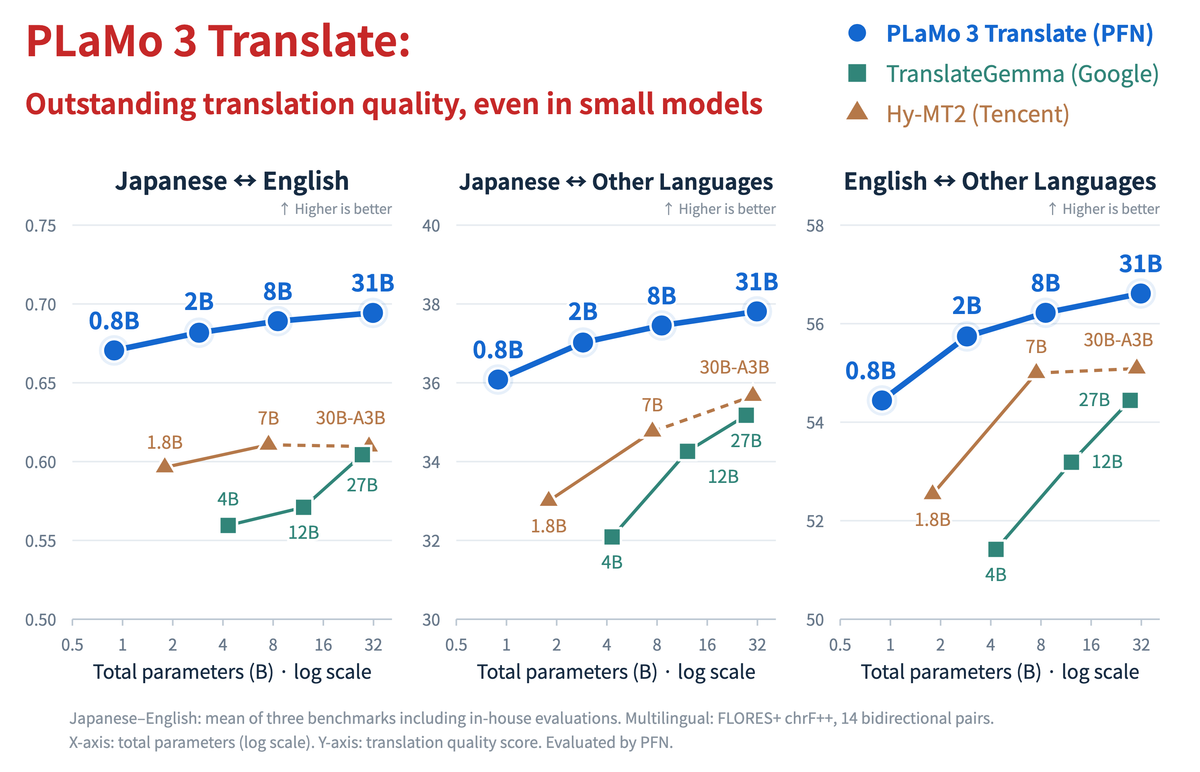
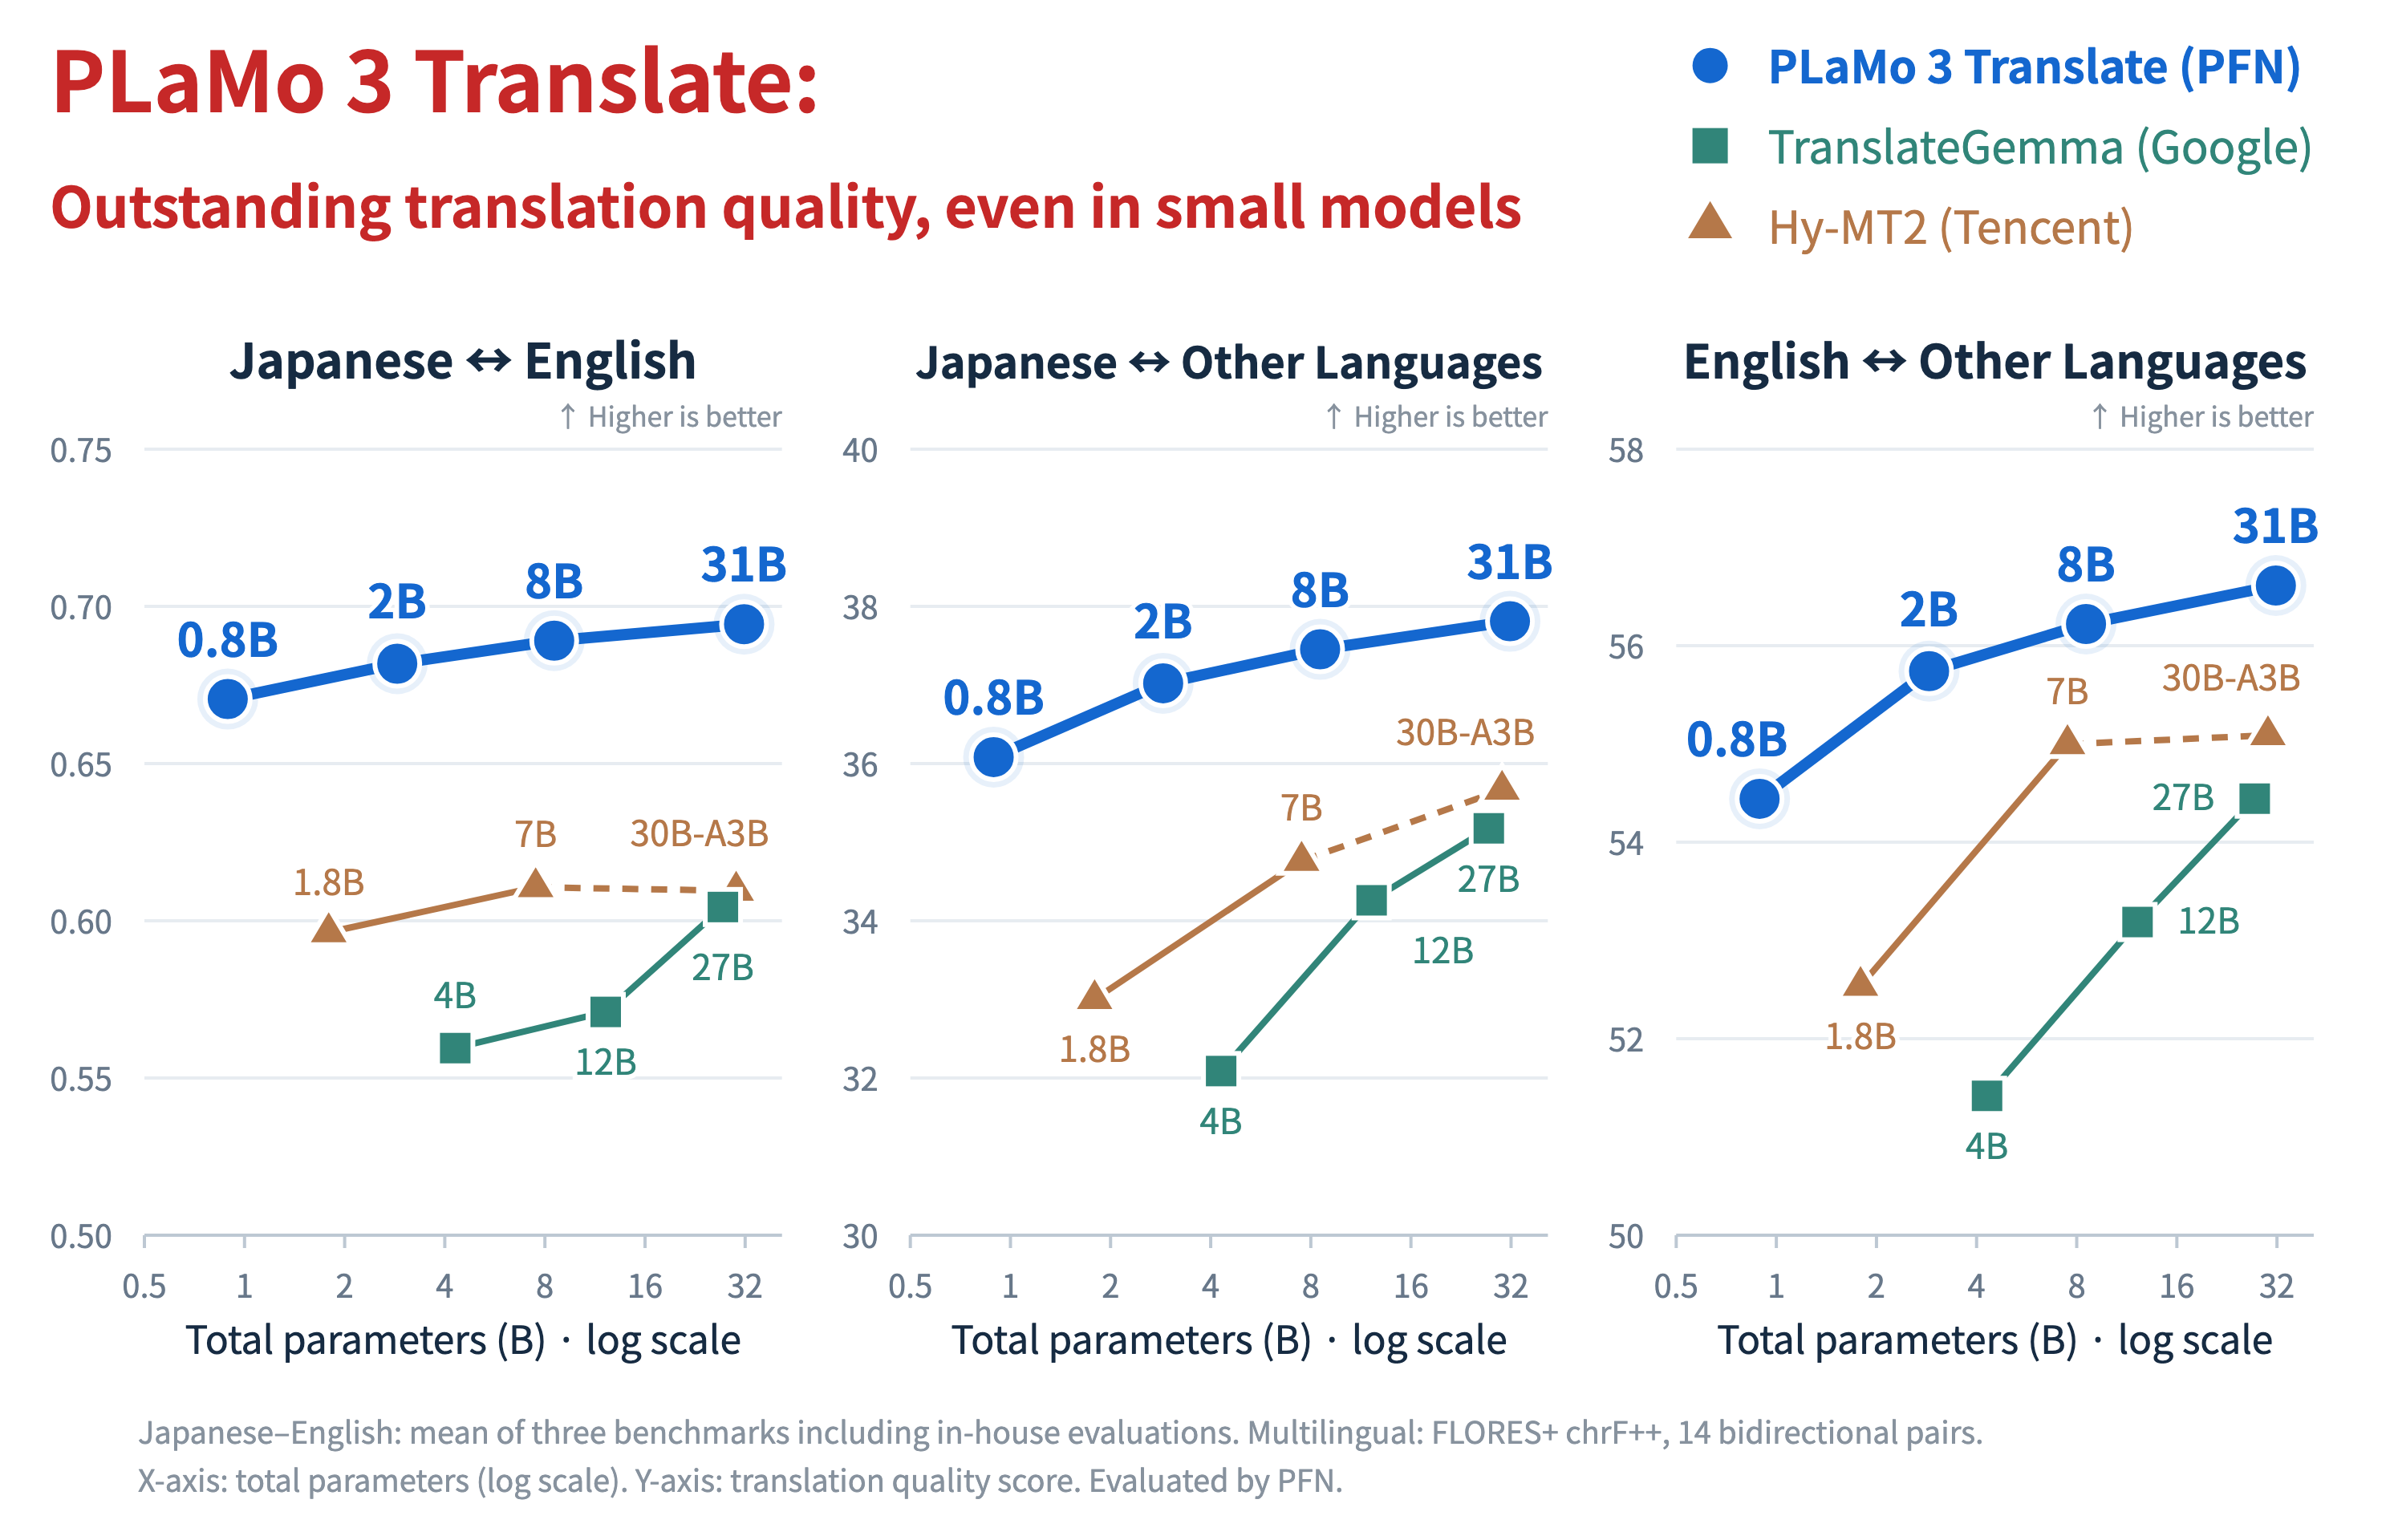
PLaMo 3 Translate 這次開放權重,讓翻譯文件的人多了一種選擇,可以把文字留在自己的設備,並在同一套流程中指定術語和前文。
但下載模型並不等於裝好翻譯軟體。權重是模型學到的數值,還需要執行程式和足夠的硬體,才能把原文變成譯文。
PFN 在2026年11月5日公開四種尺寸,從0.8B到31B。B代表十億個參數,尺寸不同,是為了讓使用者依設備容量與品質需求選擇。
其中8B版本提供較居中的選項,完整權重約17 GB,也有約5.28 GB的四位元格式。但檔案縮小之後,品質會如何變化,仍要回到同版本的測量結果。
這次值得理解的,也包含小模型能力的來源。官方把大量工作放在訓練資料的挑選、回譯與大模型蒸餾,讓有限的參數集中學習翻譯。
對固定語對、專有詞彙與資料流向有要求的人,這套開放材料值得評估。選用時還要一起看測試涵蓋的語言、上下文長度和商用登記條件。
這些取捨都從工作流程開始,先釐清模型能接住哪些要求,才知道品質與容量應該怎麼比較。
PLaMo 3 Translate 可以把哪些翻譯工作留在本機?
本次開放的是四種尺寸的模型權重,使用者可以在自己的程式中執行翻譯,並自行安排文字如何讀入、儲存與輸出。
依官方模型卡,8B版本基於PFN與日本NICT共同研究的PLaMo 3 NICT底座,再用翻譯資料訓練。因此,它的定位是完成翻譯,而非替使用者包辦文件管理。
模型支援53種語言,包含繁體中文與簡體中文。兩者在官方清單分開計算,但Hugging Face介面把中文合併顯示,所以頁面看到52種,並非少開放一種。
支援的功能也超過單句轉換。周邊文字可幫助解讀原句,詞彙表則能指定專業名詞的譯法,讓部門文件比較容易維持一致用語。
這種控制對長文件尤其有意義。若同一個角色在前段已譯為「負責人」,後段就需要沿用相關上下文,不能每段都當作完全無關的新句子。
但文件仍有長度界線。8B模型訓練時,輸入與輸出合計最長為32,768個token。Token是模型處理的文字單位,不等於中文字數,因此原文、參考資料和譯文要共用這份空間。
官方也展示了0.8B版本在手機飛航模式下翻譯,並明說是內部展示環境,沒有公開同款App。這段影片可說明小尺寸模型的部署方向,不能直接當成8B版本的手機速度證據。
要讓小模型在這些條件下仍有可用品質,光縮小檔案不夠,關鍵還在它學到的資料。
小模型為什麼能從資料品質得到更多能力?
PFN先改善每一對原文與譯文,再讓31B模型協助較小版本學習,使模型訓練的重點落在翻譯選擇,而不只是增加文字數量。
依完整開發文章,第一階段約用339億token,第二階段約34億,合計約373億。前者建立基本翻譯能力,後者改用更多樣、精煉的內容。
原文端先盡量收集母語者自然寫成的文字。團隊會排除垃圾頁、混雜語言與疑似機器翻譯,也限制單一網站的比例,避免某種文風淹沒其他領域。
繁體中文的處理尤其能看出這個差別。官方並非把簡體字機械轉成繁體就視為原生語料,而是檢查轉換工具容易留下的錯誤和不同地區的詞彙分布。
有了原文,團隊再用Gemma 4 31B IT合成譯文。但同一句話只翻一次,可能仍有遺漏,因此會先產生多個候選,再讓它們成對比較。
這個過程類似錦標賽,選出較好的譯文後,還要吸收另一份譯文的長處。保留下來的內容因此可以持續改進,而非單純留下某次生成的最高分答案。
回譯為什麼不能只把兩欄對調?
訓練資料若一直是自然原文配合成譯文,模型的輸出端就總在模仿機器寫法。因此,團隊也把合成譯文放在輸入端,讓自然文字成為要學習的輸出。
但兩種語言表達資訊的方式不同,有些主詞或時間在翻譯時會省略。若直接把兩欄對調,模型可能被要求還原譯文中根本不存在的細節。
所以,團隊會讓Gemma同時查看兩端內容,適度修整原文,使反向配對能對得上。這保留了自然文字的價值,也承認回譯資料需要再檢查。
第二階段還會用當前版本的PLaMo產生新候選,經過融合後,再和資料庫原有譯文比較。新版本較好才替換,然後重新訓練,形成資料改善的循環。
這種反覆精煉成本較高,因此只用在第二階段,不能把全部373億token都理解為經過同樣次數的精修。
蒸餾傳授的不只是標準答案
8B及以下版本還會向31B老師學習。蒸餾的意思,是讓小模型模仿老師在每個位置如何分配下一個字詞的機率,保留多種合理翻法之間的差異。
訓練一方面沿著參考譯文學習,另一方面也讓小模型先寫出自己的譯文,再由老師修正它的選擇。後者能碰到學生實際容易走偏的路徑。
若老師幾乎不會選某個字詞,學生卻給它很高機率,懲罰可能過大,讓訓練不穩。團隊因此混合師生的機率分布,柔化這些極端差距。
最後再用兩輪偏好訓練,讓模型提高好譯文的機率、降低差譯文的機率。官方也加入保留原有行為的約束,避免為了追求評分,反而傷害流暢度。
這項取捨有實際背景。團隊曾嘗試另一種強化學習方法,雖然指標上升,人類評估卻覺得譯文變不自然,因此沒有採用。這也說明分數和閱讀品質需要分開檢查。
官方評分能證明哪些品質,不能直接換算什麼?
官方結果支持的是指定語對與測試資料上的表現,不能直接換算成全部53種語言的實務正確率。
日英評估中,PFTB是團隊自建的跨領域測試,包含論文、評論與文學。SaaS測試則模擬翻譯服務收到的請求,要求保留網頁標籤等結構,但只測英文翻成日文。
這兩組會比較譯文與高品質參考文字的相似程度。另一組WMT24++採用COMET-22評分,依據不同,因此小數點後的分數不能都解讀成「答對百分比」。
多語評估使用FLORES+,從53種支援語言選出15種,再以日文或英文為中心,分別和另外14種語言雙向翻譯。它沒有測完所有可能的語言組合。
對台灣使用者而言,這表示繁體中文確實在測試選集內,但若要處理特定兩種非日英語言,仍需要查看自己的內容,不能直接借用整體平均替代。
8B完整精度權重在日英PFTB得到0.6119,四位元GGUF版本為0.6100。這組數據支持較小檔案仍接近原版,但其他指標也要一起看。
例如日文對多語的FLORES+平均分,完整精度為37.45,四位元為37.39,二位元則降到36.54。壓得更小仍能執行,卻已出現較大的品質取捨。
因此,「量化大致保留品質」有其指定版本與測試範圍,不等於每一種壓縮程度都沒有代價。選型時看同尺寸前後差異,比只看最小檔案更有用。
官方還用另一個模型比較偏好訓練前後的譯文。以31B首輪為例,英翻日勝率57%、日翻英59%,每題會交換前後順序再判一次,意見不一致就各算半勝。
這是模型裁判偏好哪份譯文的結果,並非人類逐句判定的正確率,也不是8B版本的勝率。它補充了文字相似度指標看不出的措辭變化,仍不能包辦所有品質判斷。
延伸閱讀:Hy-SimulMT 中英同傳模型開源:約 3 秒落後是什麼指標,語音輸出還需要什麼?
8B 量化與前文控制,部署時怎麼一起安排?
量化能縮小權重檔,但完整翻譯仍需替程式執行、參考前文和輸出保留空間,兩者要一起安排。
8B的完整精度檔約17.06 GB,四位元GGUF約5.28 GB,二位元約3.45 GB。這些都是權重檔大小,沒有包含執行時的其他記憶體占用。
格式還要配合硬體。GGUF可透過llama.cpp在CPU或不同GPU執行,MLX格式則面向Apple晶片的Mac。其他低精度格式對NVIDIA晶片世代也有不同要求。
所以,容量較小的檔案不一定能直接換到任何設備上。使用者需要先選對執行程式,再判斷可容納的上下文,才能把品質比較接到實際工作量。
詞彙表、參考內容與翻譯歷史各做什麼?
詞彙表提供原詞和指定譯法,適合處理產品名或部門用語。參考內容則用來說明情境,例如同一個日文發音指的是剪頭髮還是剪紙,要靠周邊意思消除歧義。
翻譯歷史的角色又不同。程式可把前面的原文與譯文成對傳入,讓模型接著用相近的詞彙和風格翻譯最後一段,而不是重新翻完整份歷史。
這份歷史不會自動永久保存,每次請求都要由應用程式帶入需要的部分。參考內容作用於整次請求,詞彙表作用於本次翻譯,也不會回頭改寫已完成的舊譯文。
若輸出日文,還能選擇普通體或禮貌體,但這項設定沒有延伸成所有語言都能指定敬語。官方要求把這些選項放在專用參數中,而非混進待翻原文。
隨著前文累積,可留給新原文和譯文的空間也會減少。官方伺服器範例設定16,384 token,是該次部署的上限,並不代表模型的訓練長度只有這麼多。
這讓段落切分有了明確目的,保留足以維持詞彙與文意的歷史,同時讓本次輸出有機會完整結束。單純把輸出上限設得很小,可能只是把譯文截斷。
延伸閱讀:Rapid-MLX 0.16.0 更新:Mac 本機模型加速,先看實驗設定再看倍數
PLaMo Community License 的免費範圍怎麼看?
個人與學術非商用可以免登記使用,商業用途則同時受事先登記和營收門檻約束,下載得到權重不代表所有用途都免授權。
依實際隨模型附上的條款,商用條件是先在官方頁面登記,且使用者或其關係企業的年度營收或銷售額不超過10億日圓。
這個門檻包含剛好等於10億的情況,超過時需要另向PFN取得商業授權。公司內部營運、開發服務與透過API提供功能,也都在條款的商業用途定義內。
因此,一家公司只在內部翻譯文件,仍要按組織用途檢查條件,不能因為沒有對外收翻譯費,就自動視為個人學習。
再散布模型材料還有額外義務,包括提供條款、標示Built with PLaMo,以及在衍生AI模型名稱中保留PLaMo。這會影響把模型包進產品的交付方式。
公開模型輸出時,條款也要求說明它來自模型或衍生模型。若再用輸出訓練其他模型,新模型同樣會受到衍生模型條件約束。
這些條件和硬體選型是兩個問題。小公司即使符合免費營收門檻,仍要完成商用登記;較大組織即使只用很小的模型,也不能靠尺寸避開授權條件。
PLaMo 3 Translate 常見問題 FAQ
已有手機App可以下載嗎?
官方展示的是0.8B模型在內部手機環境離線運作,並未公開同款App。這次提供的是權重和部署材料,需要另外建置使用介面。
支援繁體中文,代表已測完全部語對嗎?
繁體中文列在支援清單,也包含在十五語的多語測試中。但測試以日英為中心配對,不能據此推定每種繁體中文語對都有相同表現。
四位元權重只有約五GB,五GB記憶體就夠嗎?
權重檔之外還有執行環境、輸入和輸出占用,官方沒有把檔案大小當成完整記憶體需求。長文件所需空間也會隨上下文增加。
結論
PLaMo 3 Translate 把翻譯模型的選擇權交給使用者,從資料配方、不同格式到詞彙和歷史控制,都能對應到固定文件流程。
若你有明確語對與術語需求,可以先用自己的文件比較8B完整精度與四位元版本,再決定容量取捨。把使用情境對照商用條款後,這份比較才足以支持是否部署的決定。