AI 角色一致性 Vlog 教學:先做角色表,再用 Seedance 接成一天的故事
AI 角色一致性 Vlog 教學示範如何先固定臉部、服裝與配件,再安排咖啡店、街道與回房的連續場景。提供本站可修改的角色表與自拍鏡頭提示詞,說明 Seedance 參考素材分工、換臉與換裝的檢查方法,避免每段短片都像不同主角。

AI 角色一致性 Vlog 最容易破功的地方,是同一個人走進下一個場景後,臉型、頭髮或衣服悄悄變了。每段單看都漂亮,接成一天的故事卻像換了好幾位主角。
單靠每段重複名字,無法交代哪些特徵必須相同。工具還要處理光線、角度與動作,如果沒有共同參考,就可能在每個場景重新做一次人物設計。
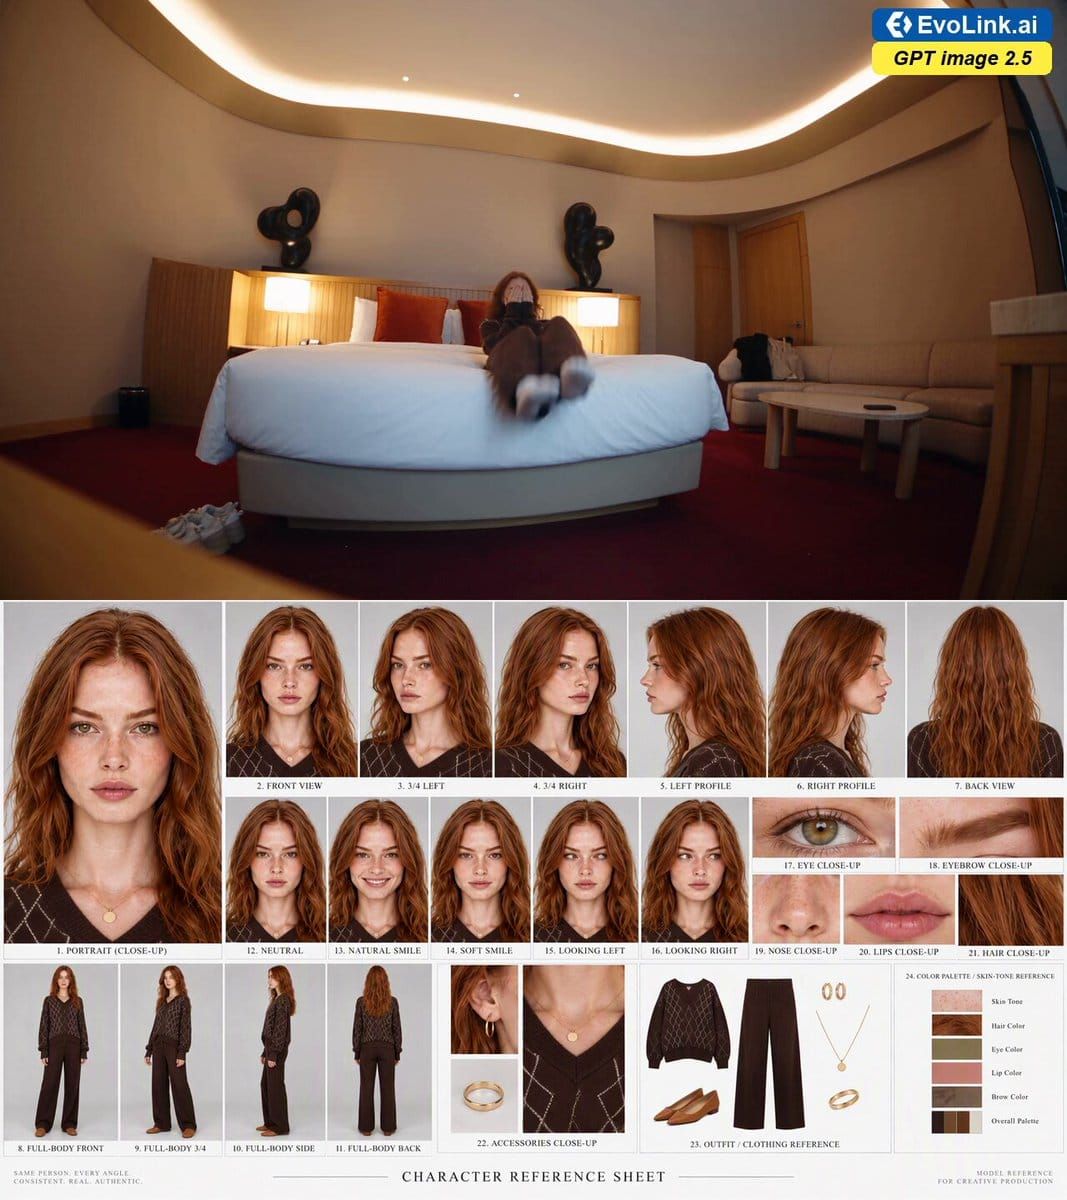
EvoLink 在 X 原始分享 展示角色 Vlog,並在 提示詞回覆 公開角色表與自拍視角安排。這個案例適合學習素材分工,不代表每次生成都能完整維持身份。
這類流程適合原創品牌角色、虛構旅遊概念或有授權的人物企畫。本文以本站另外撰寫的短版需求示範,沒有重製原作者人物,也沒有宣稱已完成相同品質的實測。
先把人物固定的部分列出來,場景才有自由變化的空間,不必每次換地點就重新猜一次臉。
AI 角色一致性 Vlog 先準備什麼?把固定特徵與可變場景分開
第一份素材應該讓人看清主角,而不是先追求複雜的故事背景。準備一張臉部清楚、遮擋少、光線均勻的角色圖,再記下服裝與配件,會比較容易在後面的鏡頭辨認。
如果使用真人影像,先確認本人同意這種使用方式。若想練習,可以用自己有權使用的虛構角色,避免把他人的公開照片當成任意製作私人生活片段的素材。
固定特徵可以包括臉部比例、髮型、服裝大色塊與一個明顯配件。可變內容則包括所在位置、當下動作與照明,兩者分開寫,工具才知道換的是場景,而不是整個人物。
一張角色表需要哪些角度?
先做正面、四分之三側面、側面與全身,足夠支援多數簡單 Vlog。只有真的會出現的細節才加近照,例如鏡頭會碰到手部,就要看清楚戒指、袖口與指甲。
不要一次放進大量彼此矛盾的圖。某張頭髮較短、另一張衣服不同,工具就得判斷哪些差異應該保留,這會增加後面每個鏡頭重新混合的可能。
以下是本站角色表範例,請替換成自己的角色資料。原作者的角色表很完整,初次練習可以先縮小範圍,確認每格都像同一個人再擴充。
請依附件角色建立一張簡潔角色表。
固定:[臉部特徵]、[髮型]、[服裝]、[配件]。
視角只要正面、四分之三側面、側面與全身,使用相近光線與相同比例。
每格都沿用同一身份,不改成另一種美化版本。
看不見的細節先保持簡單,避免自行增加明顯胎記或飾品。
先交付角色表供比較,暫時不要生成影片或新場景。
把每一格放大比較眼睛、鼻子與下顎,再縮到影片預計大小看整體。若正面像同一人、側面卻完全不同,就先修角色表,不要期待動態生成自動補好身份。
這張表通過後,才能作為後面所有場景的共同依據。下一步要讓這個人出現在不同地方,而不是讓每個地方生成一位相似的人。
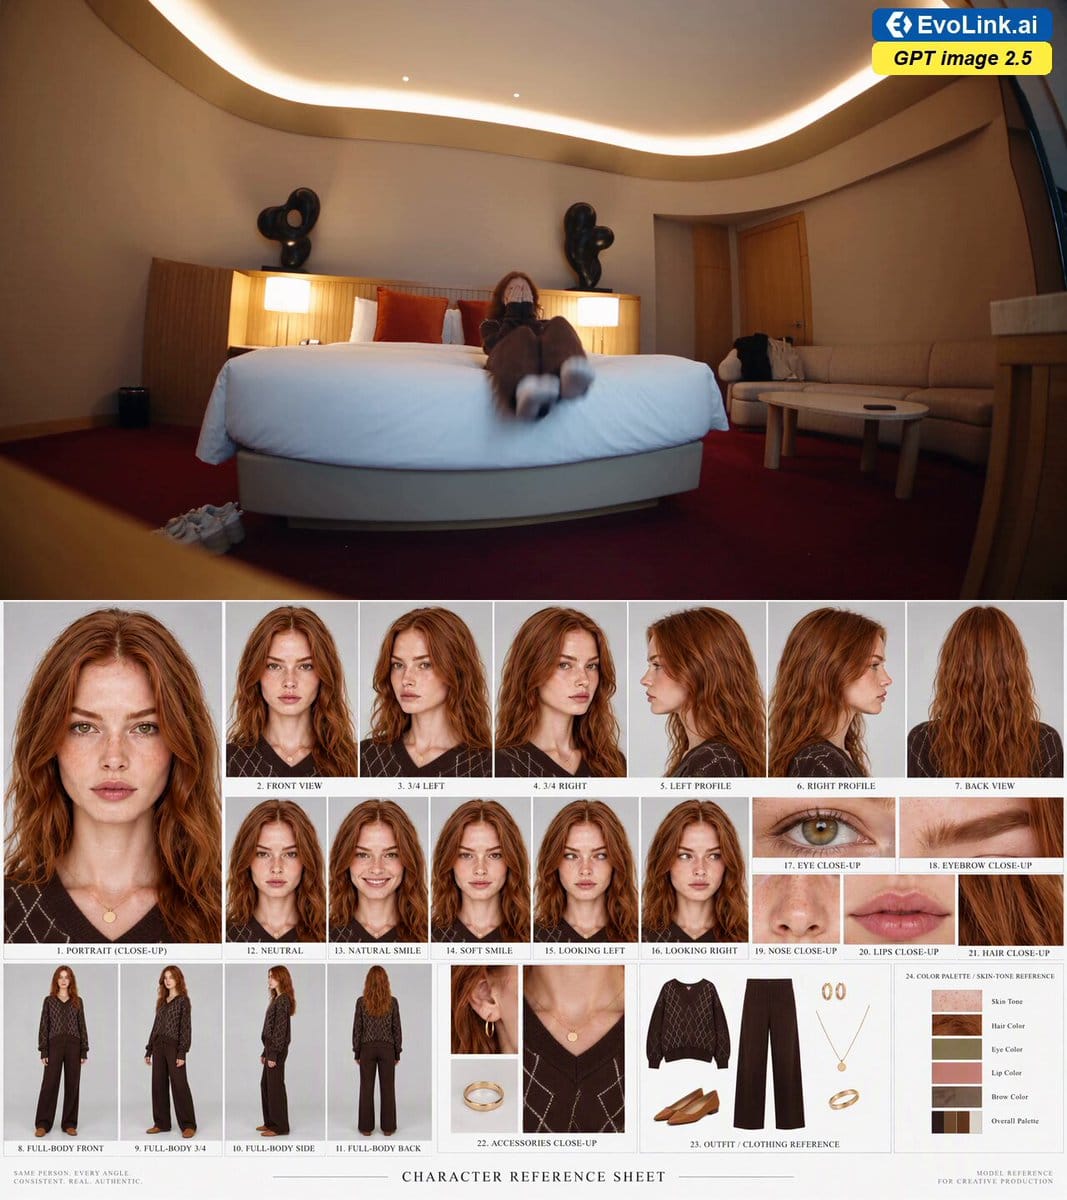
場景先做幾張?用三個關鍵畫面接出時間順序
第一支練習先選三個場景,容易檢查人物與時間是否連續。例如早上整理桌面、中午拿咖啡、晚上回到同一房間,已經能形成一個有開始與結束的小故事。
每張圖都帶上同一份角色參考,再寫清楚現在的動作與光線。不要只複製上一張生成結果往下做,因為前一張如果已經有輕微臉型變化,下一張可能把變化當成新的標準。
BytePlus 官方提示詞指南 將主體、動作、風格與分鏡等參考分開說明。實際準備素材時,也可以用這個原則,讓角色圖只管身份,場景圖只管環境。
讓衣服與物件幫忙維持連續性
同一天的短片,先固定一套服裝與常出現的物件。像同一個杯子、相同外套或包袋,可以幫觀眾把不同鏡頭連起來,但要避免細節太多,反而增加生成難度。
若故事需要換裝,把換裝發生在何時寫清楚,並在新段落使用更新後的服裝參考。否則一段深色外套、一段淺色襯衫,很容易被誤認為模型不穩定,而不是刻意安排。
場景也需要一個可辨識的固定元素。例如早晚都回同一間房,窗戶、床頭與主要家具的位置應該對得上,不然觀眾可能以為主角換了住宿地點。
| 素材 | 只負責的內容 | 不應自行改動的部分 |
|---|---|---|
| 角色表 | 主角外觀與比例 | 臉型、髮型與固定配件 |
| 服裝圖 | 當天穿著 | 衣服色塊與主要輪廓 |
| 房間圖 | 室內空間 | 家具與門窗關係 |
| 分鏡圖 | 構圖與動作起點 | 已確認的角色身份 |
這份分工讓場景改動有邊界。若你只想把早晨改成晚上,就不需要讓工具重新設計人物與房間,後面也比較容易比較哪一項變化造成了錯誤。
等靜態關鍵畫面都接得起來,再把時間放進去。這樣生成影片時,至少知道每個鏡頭的起點已經符合故事。
自拍視角怎麼寫?先決定攝影機是誰拿著
Vlog 的可信感不只來自手持晃動,也來自鏡頭位置符合角色當下能做到的拍攝方式。若前一秒是自己拿手機,下一秒卻從高空追著跑,觀看者就會察覺視角突然換了人。
原作者的提示詞把鏡頭分成手持與放置兩種,這是一個很有用的限制。手持鏡頭應反映手臂距離與步伐,放置鏡頭則讓角色走進或走出畫面,不需要一個看不見的攝影師追蹤。
先把同一種視角做穩,再混合鏡頭
第一版可以全用放置鏡頭,讓人物在固定場景內完成短動作。等角色身份穩定,再增加一段手持近景,這樣看到換臉時,比較容易知道是否和距離或角度有關。
鏡頭位置也應有物理依據,例如放在桌上、靠在窗邊或由角色手持。只寫「自然自拍感」仍然很抽象,可以補上鏡頭高度、是否固定,以及角色如何進入畫面。
素材分工:圖片一是唯一角色身份,圖片二是房間位置參考。
故事是一個原創虛構角色的早晨,服裝和配件沿用角色表。
0至3秒:手機放在桌上,固定中景,角色從右側走入坐下。
3至6秒:角色拿起杯子看向鏡頭,微笑後放回桌上。
6至8秒:角色起身走出畫面,手機仍停在原處。
全段只做這個動作,先不加入台詞。房間家具位置維持一致。
這是本站撰寫的練習版。先不放台詞,是為了把身份、手部和鏡頭先看清楚,之後再加聲音,就能分辨錯誤來自哪個新要求。
如果想做手持版,可以保留同一個角色與動作,只改鏡頭的位置與移動方式。不要同時換場景、換衣服與加對話,否則很難比較手持效果到底改善了什麼。
對話與聲音怎麼加入?讓角色只說當下需要的一句話
短片先讓動作成立,再加入一句和情境相關的台詞,通常比一次要求完整口白容易檢查。例如角色喝到咖啡後說一句感受,就能把畫面和聲音連成同一個事件。
台詞要和時間一起安排,並寫清楚誰說、何時開始,以及其他時候是否保持安靜。如果有多個聲音來源,工具可能把旁白和角色對話混在一起,嘴型也更難核對。
Seedance 官方介紹 說明其音畫與多模態參考能力,但角色一致、口型與語氣仍是實際作品需要驗收的項目,不能因為支援功能就視為每次都正確。
先確認一段聲音,再沿用角色語氣
挑一句包含常用稱呼與專有名詞的台詞,先聽讀音與語速。如果角色的口音或年齡感不符合設定,先修聲線或換錄音方式,不要等所有鏡頭完成才統一重做。
生成結果若多出旁白或背景說話聲,先把聲音要求縮小,保留單一說話者。背景環境聲可以晚一輪再加,這樣比較容易判斷到底是哪個聲音需要保留。
如果不需要角色開口,也可以改成後製旁白或字幕。影片用途決定表現方式,不能為了展示模型能力,就讓每個鏡頭都增加一段難以驗收的對話。
延伸閱讀:HeyGen 與 Ryan Serhant 的官方化身:日更影片如何保留本人的觀點?
聲音確定後,接下來就可以把不同場景排在一起,檢查觀眾看到的是同一位角色的一天,還是一組只有風格相近的片段。
一致性怎麼驗收?把每段開始、中間與結束並排比較
角色一致性要跨鏡頭比較,單看一段很容易忽略微小變化。先各取開始、中段和結束畫面,檢查臉型、頭髮、衣服與配件,再看整段動作是否連續。
把問題分成身份、服裝、場景與動作四類。例如臉型變了是身份,耳環消失是配件,房門換位置是場景,杯子穿過手掌則是動作,這些不該全部用同一句「請更一致」處理。
先挑一個最明顯的問題修正,再和原版並排。若只想改髮型卻連眼睛也改了,就回到共同角色表,而不是把錯誤版本繼續當下一輪的唯一參考。
不必為了接得順,保留有問題的長鏡頭
若一段八秒影片只有前五秒身份穩定,可以縮短用途或換成另一個鏡頭。這是剪輯取捨,不等於修好了後三秒,所以原始檔和問題紀錄仍要保留。
鏡頭之間也要檢查物件狀態。例如上一段已把杯子放下,下一段突然又在手中,如果故事沒有交代,就會讓人懷疑時間是否接錯。這種連續性問題需要改分鏡,單靠修臉無法處理。
結尾可以回到第一個場景,檢查服裝、房間與角色狀態是否相容。早晚光線可以不同,但固定家具和角色外觀不應因為氣氛改變而完全換掉。
交付時保留角色表、場景圖、各段提示詞與未裁切原片。接收者才有辦法知道最終選了哪幾秒,也能在下次換地點時沿用同一位角色。
第一次可以只做三個場景,每段一個動作,再把它們接成簡短日常。只要有一段認不出同一個人,就先修那段的參考與視角,再增加台詞或更多場景。
練習一個早晚回到同房間的故事:用場景回訪檢查身份
可以把三段故事設計成早上出門、中午喝咖啡、晚上回房,因為第一段和最後一段能互相比較。以下是本站的練習企畫,不是原作者旅遊經歷,也不應標示成真人實際到訪紀錄。
先選一個有明顯固定家具的房間,讓窗、桌子與一盞燈形成位置依據。早上和晚上可以換光線,但不要同時換家具排列,否則難以判斷差異是刻意設計還是場景漂移。
角色在早晨穿同一套衣服拿起包袋,晚上回房也保留相同服裝與包袋。若故事需要不同穿著,就把換裝安排進情節,讓觀眾看得出變化發生在哪一段。
中午只拍一個拿杯子的動作,避免在中間鏡頭加入另一位重要人物。第一支練習先把單一身份做穩,之後再擴充雙人互動,會比較容易知道新增難度來自哪裡。
每段先固定一個能銜接的姿態
出門段可以讓角色走出右側,街道段從左側走入,讓觀看方向形成連續感。但這只是分鏡選擇,並不是模型自動知道兩段地點如何連接,所以仍要用成片檢查。
如果中午是手持近景,晚上回房則用放置鏡頭,先各自完成再接起來。視角變化應有明確理由,像是出門拿著手機、回房放在桌上,不必額外加入無人能拍到的運鏡。
把早晚兩張臉、全身與配件近景排在一起看,光線不同時先看輪廓和位置,再看顏色。暖光下衣服顏色稍變不一定是換裝,但花紋與扣子位置改變,就值得回到素材確認。
遇到身份漂移,回到共同參考而非繼續接龍
假如中午那段下顎變窄,先重做中午鏡頭,仍使用最初已批准的角色表。若直接拿變窄的版本去做晚上,錯誤可能逐步成為下一段的新標準。
同時比較鏡頭距離是否差很多。近景能看清身份,但過近可能裁掉髮型與服裝特徵,遠景則要靠輪廓辨認,因此兩種鏡頭各有需要保留的資訊。
完成後把三段先接成沒有音樂的版本,請人說出看到的故事順序。對方能認出是同一人、同一天的幾個事件,再加入台詞與配樂,才比較容易保住原本清楚的連續性。
延伸閱讀:Claudia 是什麼?用 Claude 做 AI 音樂影片的流程、成本與開放角色授權怎麼看
AI 角色一致性 Vlog FAQ
一定要用 GPT Image 2.5 製作角色表嗎?
不一定。原作者的案例採用該工具,但角色表也可以由繪師或其他有權使用的素材建立。重點是各角度能被認成同一個身份。
寫下「保持同一人」就夠了嗎?
通常仍要提供清楚參考與固定特徵。把人物、服裝和場景的責任分開,才能在出錯時知道應改哪一份輸入。
這種影片能當作真人旅遊紀錄嗎?
虛構或生成的片段不應包裝成本人實際到訪的證據。若使用真人形象,還需要確認相應授權與標示方式。