DSpine 新增 Qwen3.8-27B 草稿權重,代理回放快三倍代表什麼?
DSpine 新增 Qwen3.8-27B 草稿權重,解析平行預測方法、接受長度與代理回放吞吐的差別,以及三倍加速的基準、並行設定和部署條件。

代理執行工作時,下一個工具指令常要等模型把一段文字寫完。即使工具本身很快,生成文字仍可能讓流程停在原地。
DSpine採用推測解碼,由較小模型先提出草稿,再交主模型驗證,希望一次留下多個文字單位,減少主模型逐步等待。
騰訊在2026年11月7日新增配合Qwen3.8-27B的草稿權重。這是既有方法的新目標模型支援,並沒有另發一個新的Qwen底座。
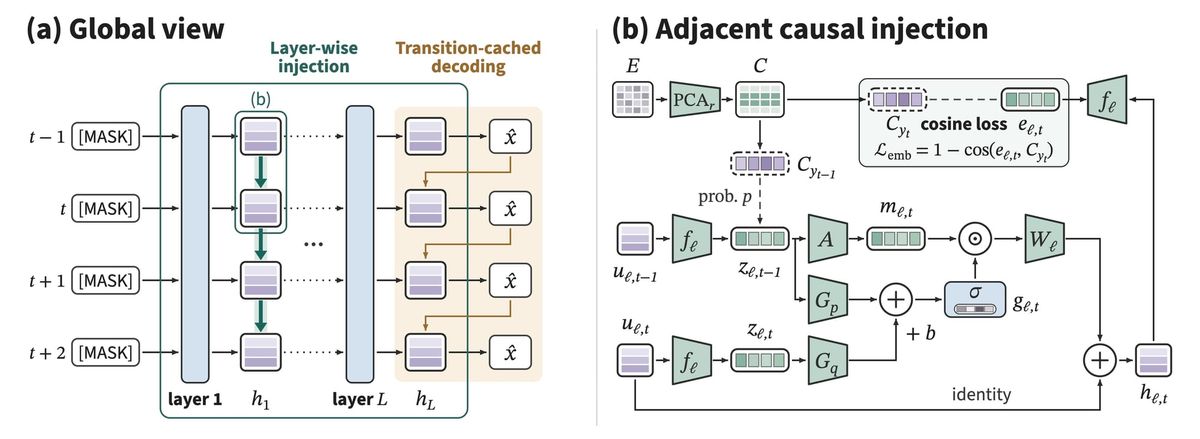
新草稿用五層網路,同時預測多個位置,再沿網路深度交換相鄰位置的資訊,試著兼顧平行生成與前後關係。
官方代理回放測試出現約三倍吞吐提升,但它計算的是八個請求並行時,每秒產生多少文字,並非真實工作從開始到完成都快三倍。
我認為這份材料適合已管理推論服務、能比較相同工作負載的團隊。接受長度、輸出吞吐和使用者等待,必須分開讀,才能知道加速發生在哪裡。
先看主模型與草稿的分工,就能理解這次新權重提供的用途。
DSpine 的新草稿權重補上哪一段?
新權重負責替Qwen3.8-27B提出候選文字,最後接受哪些內容,仍由主模型驗證,因此草稿不是可以獨立聊天的替代品。
依新模型卡,它是約二十億參數的五層草稿模型,一次處理十六個位置,並採用8,192個文字單位的滑動視窗。
權重是模型學到的數值,這次下載的數值是配合指定主模型訓練的。若只有草稿,沒有Qwen3.8-27B與相容的執行程式,便少了決定最終輸出的那一端。
一般逐字生成會在寫出一個token後,才接著計算下一個。Token是模型切分文字後的單位,一次可能對應一個字、部分字詞或其他片段。
推測解碼先讓便宜一些的草稿提出一串候選,再由主模型檢查。候選越符合主模型下一步會接受的內容,一輪驗證能留下的文字就越多。
這種方法的目的在於改變生成方式,沒有因此替主模型增加知識,也不以草稿自己的正確率取代主模型的答案品質。
DSpine原論文在九月已公開,十月另有版本更新。十一月的新事件是27B支援、相應權重與執行設定,所以讀者應用這份新的組合來判斷可否導入。
這也讓下載選擇變得具體。團隊要核對的是主模型版本與草稿是否配對,而非看到名稱相似,就假設所有同家族模型都能使用同一份草稿。
同時猜多個字,如何把前一句傳給後一句?
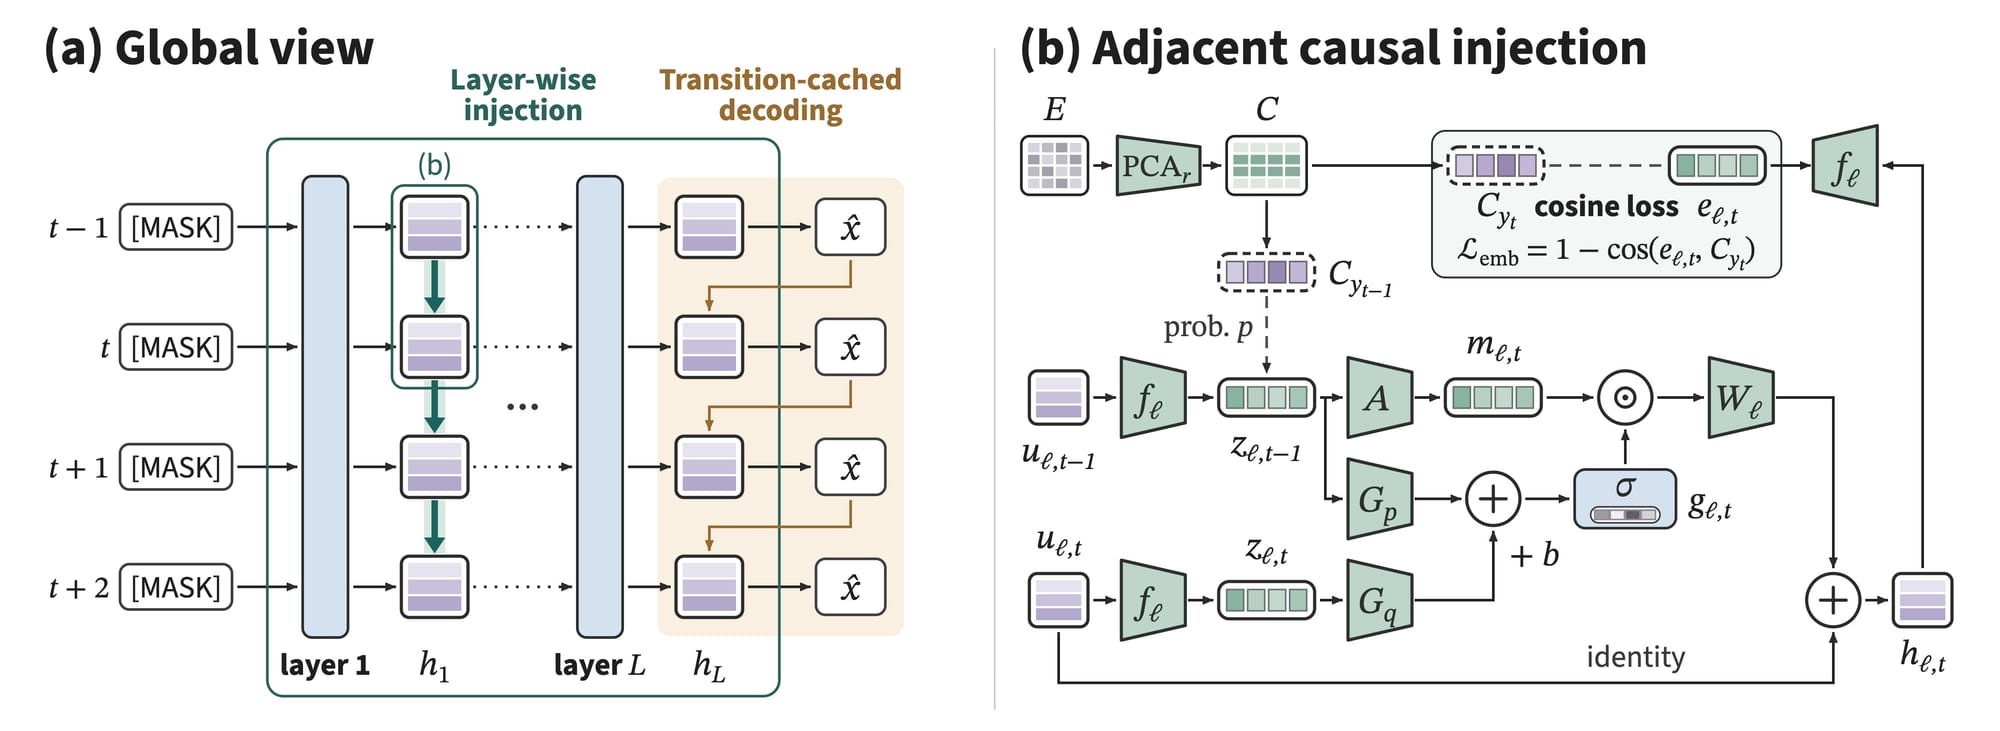
DSpine在每一層把前一位置的預測特徵交給下一位置,使前後依賴沿網路深度傳遞,而多個位置仍能同時更新。
完全平行猜測的難處,是後面的內容需要知道前面會寫什麼。若每個位置只看同一份舊資訊,候選可能各自合理,接在一起卻不符合主模型的生成路徑。
DSpine把這個問題放進草稿的多層計算。某個位置在前一層形成的預測表示,會傳到相鄰位置,成為下一層可用的資訊。
特徵可以理解成網路內部對內容的數值表示。傳遞特徵並非把已確定的中文字逐個搬過去,而是在各層逐步更新「前面可能出現什麼」的資訊。
因此,草稿不必等待每個位置完全定案,再開始下一個位置的所有計算。它讓多個位置一起修正,同時給後面的位置一些前文線索。
這種設計仍會猜錯。主模型的驗證與拒絕步驟保留下來,草稿只是提高一次提出多個可用候選的機會,不能跳過最後的接受判斷。
新版執行方式也包含動態驗證,以及處理模型內部狀態的ReplaySSM支援。這表示測到的加速來自整個推論組合,不能把全部提升都歸到五層草稿這一個元件。
要知道這種資訊傳遞有沒有幫上忙,第一個可觀察的量,就是每輪驗證平均留下多少候選內容。
接受長度和三倍吞吐,為什麼不是同一件事?
接受長度描述一輪草稿留下多少文字,吞吐則把整段並行回放的時間算進來,兩者回答不同問題。
在GSM8K數學題、採確定性選擇的設定下,DSpine平均接受長度為7.20,對照的DFlash2為5.69。這些數字是每輪接受的文字單位,不是答對題目的百分比。
改成溫度一的抽樣設定後,兩者分別為6.31與5.45。輸出路徑改變,草稿和主模型吻合的情況也可能不同,所以接受長度並非固定的模型常數。
HumanEval程式題同樣呈現差異,確定性設定為5.71對4.87,抽樣時則為4.71對4.34。這說明任務與抽樣方式都會改變一輪可留下多少內容。
接受更多候選有機會減少主模型反覆生成的次數,但提出與驗證草稿也需要運算。因此,接受長度增加多少,不能直接當成整體速度增加多少。
官方另計算每秒輸出量,把全部輸出的token數,除以八個請求並行回放所經過的實際時間。這個分母包含回放中的推論等待,和單輪接受長度不同。
以SWE-bench Pro的高推理設定為例,原本逐字生成為每秒248.17個token,DFlash2為711.60,DSpine為791.30。
所以,DSpine的3.19倍是相對原本逐字生成,DFlash2的2.87倍也使用同一個基準。它並不是比DFlash2再快3.19倍,兩個草稿方案的差距要另算。
其他工作也不是固定三倍。低推理的WorkBuddy Code是2.71倍,Office是3.84倍,高推理各項則落在約2.87至3.55倍。
把接受長度和吞吐放回同一個工作,還能看見更細的關係。低推理的程式工作中,兩套草稿的接受長度為4.19與5.08,輸出則為每秒590.27與686.23個文字單位。
辦公工作裡,接受長度從4.24到5.63,吞吐從每秒664.77到805.53。接受更多內容確實和較多產出一起出現,但兩者增加的比例並不相同。
這組差別讓讀者看見,草稿品質和整體執行效率需要同時觀察。只從其中一欄選出較漂亮的數字,便會漏掉另一端付出的計算與等待。
如果讀者只想知道「這次多出的草稿算力值不值得」,吞吐比較會比單看接受長度更接近答案。但它仍不是實際工作完成時間,還要回到回放怎麼做。
延伸閱讀:EAGLE-4 是什麼?貼文稱 Qwen3.8-27B 達 961.6 tokens/s 的條件與授權
官方代理回放測試涵蓋哪些條件?
回放使用記錄好的工具決策輸入,比較相同類型的模型生成工作,沒有重新完成全部外部工具操作與任務結果。
測試涵蓋WorkBuddy的程式、網頁、辦公工作,以及SWE-bench Pro和τ²-bench。每個子集取二十段對話,再分低與高推理設定評估。
官方把對話中記錄的工具決策前綴依序重播。前綴就是當時模型已經看過的內容,讓它再次處理這些輸入,可以比較推論服務在這類文字負載上的表現。
但工具結果已在記錄中,不是重新等待網頁載入、檔案處理或外部服務回應。因此,這裡的端到端,指這套並行回放的時間邊界,並未涵蓋真實代理的所有工作。
測量另開啟前綴快取,重用先前已算過的部分內容,每次請求最多生成32,768個新token。長對話重用程度和輸出長度,都可能影響最後的吞吐。
生成上限也只是允許寫出的最大長度,沒有要求每個請求一定寫滿。若要重現吞吐,還需要保存實際產生的文字總量,才能和經過時間形成同一個分子與分母。
一般題庫則使用高推理設定,每次最多生成4,096個新token,和代理回放的預算不同。這兩張表不適合拿來估算同一使用者會等待多久。
抽樣設定也明列為溫度一、top-p 0.95、top-k二十,代表從一定範圍的候選文字中抽樣。比較設定相同,才有辦法讓輸出行為的差異保持可解讀。
兩套草稿方案只換了一份權重嗎?
並沒有。官方使用SGLang 0.5.22、BF16數值格式與FlashAttention 3,並行數為八,但DSpine每塊提出十六個候選,DFlash2每塊為八個。
DSpine另啟用動態驗證和狀態重播相關設定。這份測試因此比較的是各自配置好的方案,沒有把所有條件鎖成相同後,只替換草稿網路。
對工程團隊來說,這不會使整體數字失去用途。它回答的是指定組合能有多少產出,若想知道單一方法造成多少提升,則還需要另外拆開元件比較。
模型卡沒有附上這張表的GPU硬體明細,也沒有提供每項任務的成功率。因此,不能把社群某台DGX Spark的個案,補成官方對所有消費設備的速度保證。
導入新草稿模型,哪些成本需要一起考量?
新的草稿需要相容主模型與執行環境,收益要和額外計算、容量及自己的請求型態一起比較。
官方儲存庫提供安裝與啟動方式,模型卡也列出主模型、草稿路徑、推測解碼模式和相關快取設定。這是一套推論服務組合,不是一個下載後就能取代聊天應用的檔案。
八個請求並行,也和一個人單獨等待答案的情境不同。吞吐關心系統一段時間能處理多少總輸出,個別請求的回應時間則需要另一組紀錄,不能只把總量除以八當成每人的速度。
若同時請求的數量不同,硬體如何分配工作也會改變。官方的八路設定提供一個可重現的起點,還不能替一個請求或更高負載的服務預先決定收益。
草稿自身會占用容量,每輪也要計算。若工作輸出很短,或主要時間花在等待外部工具,生成端吞吐增加之後,整個工作能省下的時間就可能較少。
這是從測量邊界推得的採用條件,並非官方已測出所有短請求都沒有收益。團隊需要讓測試負載接近自己服務中的輸入長度、並行數和工具決策頻率。
滑動視窗和服務上下文也要分清。草稿的8,192個token視窗描述其局部計算範圍,啟動範例中的131,072則是服務設定,不能把前者直接說成整個主模型只能讀八千字。
新版草稿權重標示Apache 2.0,仍需另外核對目標模型的授權與執行依賴。開放草稿允許怎樣使用,和另一份主模型允許怎樣提供出去,屬於不同材料的條件。
因此,導入時可先以同一批記錄比較逐字生成和新組合,觀察總產出、每個請求的等待及容量占用,再看加速是否發生在自己想改善的位置。
延伸閱讀:VFlash 視覺規劃研究,機器人為何不用逐字寫完每一條軌跡?
DSpine 常見問題 FAQ
新草稿能單獨當成Qwen聊天模型嗎?
它是配合Qwen3.8-27B的草稿,需要主模型驗證候選內容。下載草稿不等於已取得完整、可獨立作答的助手。
接受長度7.20代表七倍速度嗎?
不代表。它描述一輪平均接受多少token,沒有把草稿提出、主模型驗證與其他等待成本直接換成速度倍數。
代理回放三倍,代表任務成功率也提高嗎?
這份表測輸出吞吐,未提供相應任務成功率,也沒有重做所有外部工具操作。三倍產出不能轉成三倍成功或三分之一完整工作時間。
結論
DSpine這次擴充的價值,是讓使用Qwen3.8-27B的推論團隊有了新的草稿與公開配置,可以檢查平行預測如何轉成更多可用輸出。
若你的瓶頸確實在模型生成,可先拿固定工作記錄比較相同主模型的兩種執行方式,再把吞吐收益放回真實工具等待中。這會比直接套用三倍標籤,更能支持服務選擇。