Kimodo 是什麼?NVIDIA 開源動作擴散模型推出 v1.2,修正資料外洩後基準怎麼讀
Kimodo 是 NVIDIA 開源的動作擴散模型,可用文字與關鍵姿勢產生 3D 人物與機器人動作。本文依官方倉庫與模型卡,說明 700 小時動捕資料、兩階段架構、v1.2 修正訓練資料外洩的原因、基準數字怎麼讀,以及授權與使用限制。

打一句「A person walks forward and waves」,再指定第 60 格手要抬到某個位置,模型就能產生一段 3D 角色或人形機器人的動作。這是 NVIDIA 研究團隊開源的 Kimodo 在做的事。
2026 年 10 月 19 日凌晨,X 上的 HuggingPapers 帳號介紹它,說它用 700 小時動作捕捉資料訓練,查詢時有 681 個讚。不過 Kimodo 不是新模型,它在 2026 年 3 月 16 日就已開源。
這次的新聞發生在 10 月 15 日。NVIDIA 在倉庫公告,發現 Kimodo-SOMA-RP-v1.1 的訓練資料混入了部分測試序列,這些序列來自公開的動捕資料集 BONES-SEED。
於是 NVIDIA 釋出用修正後資料切分重新訓練的 v1.2,並把它設為示範與命令列的預設模型。
這件事和一般使用者的關係,在於基準分數。動作生成模型的好壞靠固定題目打分,如果訓練時看過考題,成績就會偏高。所以想拿 Kimodo 當比較對象,或引用它的分數,現在該用 v1.2 的數字。
我的判斷是,做遊戲動畫、動作原型、機器人示範資料的團隊值得試用,因為授權與工具鏈都相當完整。需要超過 10 秒的連續動作、精準的物件互動,或想拿到訓練資料本身的人,則不適合。
要看懂 v1.2 為什麼重要,先從 Kimodo 怎麼把文字與約束變成動作談起。
Kimodo 是什麼?文字與約束如何變成 3D 動作
Kimodo 的名字來自 kinematic motion diffusion,意思是以骨架運動學表示的動作擴散模型。擴散模型是從雜訊開始、一步步去除雜訊來產生結果的模型,圖像生成常用,Kimodo 把它用在骨架動作上。
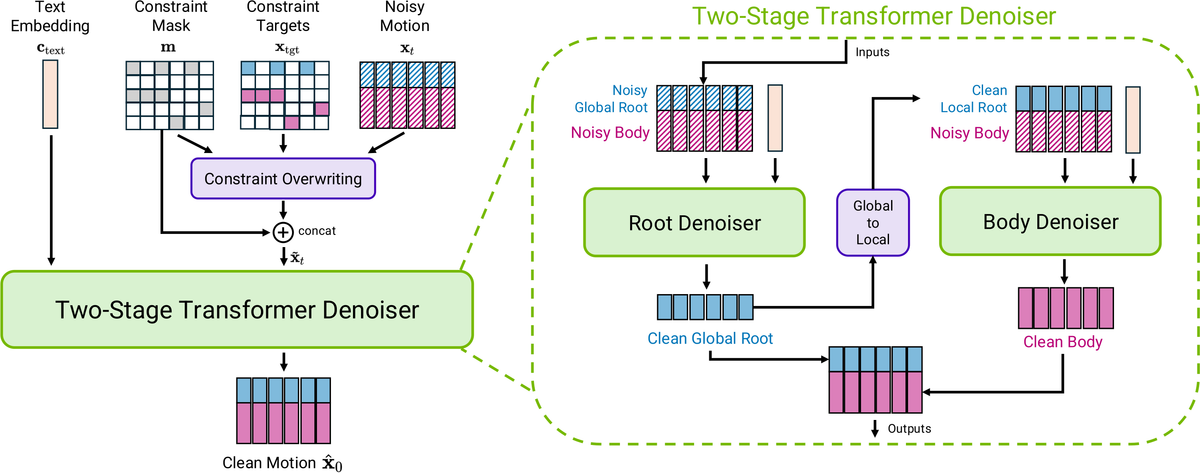
輸入有兩類。一類是文字提示,例如「一個人跑步後急停」。另一類是運動學約束,包括全身關鍵幀、手腳末端的位置與旋轉、2D 路徑點與連續的 2D 路徑。
輸出是骨架動作,以 30 fps 輸出根節點位移與各關節旋轉,根節點就是人物在地面上的位置與朝向,單次最長 10 秒,也就是 300 格。你可以用多個提示串成較長的動作,但每一段都是依序生成的。
官方列出的模型家族有三種骨架:SOMA 人體骨架、Unitree G1 人形機器人,以及 SMPL-X。
SOMA 與 G1 的權重採 NVIDIA Open Model License,SMPL-X 版本的授權限制比較多。
官方還把它放在機器人流程裡。用 G1 骨架生成的動作,可以匯出成 MuJoCo 的 CSV 格式,或匯入 ProtoMotions 訓練物理模擬策略,官方宣稱這比遙控操作更快、更容易取得示範資料,但專案頁沒有附比較數據。
官方也把它接進 GEAR-SONIC 的互動示範,先產生 G1 的動作,再由 SONIC 在模擬中追蹤。這是概念驗證,不是量產流程。
專案頁還列出幾個相關專案。ARDY 負責即時互動生成,MotionBricks 擅長快速補中間幀,GEM 則是從單眼影片重建動作。我的理解是,Kimodo 的位置比較接近離線生成與編輯,值不值得用,要先看它的架構與訓練資料。
延伸閱讀:SONIC 跑上 Asimov:人形機器人全身控制,為什麼小型 CPU 也能做?
兩階段去噪器與 700 小時資料
Kimodo 的核心是兩階段 Transformer 去噪器,模型卡列出的參數量是 2.82 億,不算大。第一階段先預測整體的根節點,也就是人物在地面上走了哪條路、朝向哪裡,第二階段再根據這條路徑預測身體各部位怎麼動。
這樣拆有一個理由。官方專案頁與論文摘要說,把根節點與身體分開預測,目的是減少動作瑕疵,例如漂浮與腳滑,同時也讓關鍵姿勢這類約束更容易放進去。專案頁沒有附單獨的對照數據,後面的基準表也顯示腳滑仍高於真值。
資料才是這個模型的另一半。它的主力模型用 Bones Rigplay 資料集訓練,內容是約 700 小時、專業動捕棚拍攝的 SOMA 骨架動作,並附文字描述。
這個資料集是專有的,公開的只有其中約 288 小時的子集 BONES-SEED。
官方也釋出了用 BONES-SEED 訓練的 SEED 版模型,用意是讓外部研究者能用同樣的資料比較自己的模型。官方稱 SEED 版能力較弱,但適合做公平的比較。
官方還提供標註與基準。BONES-SEED 附有逐段的時間軸文字標註,測試集用這些標註出題,不含真值動作本身,因為真值來自 BONES-SEED,使用者要自己下載並遵守它的授權。
倉庫的採用規模不小。我查詢時,倉庫有約 3,800 個星標與 420 個分支,程式碼採 Apache-2.0,社群已經有人在用,所以這次修正的訓練資料問題值得弄清楚,只是星標不能代替你自己評估動作品質。
v1.2 更新了什麼?訓練資料外洩為何要重算
外洩是指測試用的動作也出現在訓練資料裡。BONES-SEED 的官方切分把動作分成訓練集與兩個測試集,如果某個測試序列也在 Rigplay 的訓練資料中,模型就等於見過考題。
倉庫公告說,v1.1 的 RP 模型有這種情形,官方註明 SEED 模型不受影響。
這次更新先處理資料。NVIDIA 釋出兩個以修正切分訓練的模型,一個沿用平滑根節點表示,叫 Kimodo-SOMA-RP-v1.2,另一個採用 ARDY 的動作表示,叫 ArdyRep 版。
ARDY 是 7 月 10 日釋出的即時動作生成專案,沿用了這個模型的控制能力,所以 ArdyRep 版的用意,是讓兩邊能直接比較。
接著是預設值。v1.2 成為示範與命令列的預設模型,評測腳本評估 v1.1 時也會警告它的訓練集與測試集重疊。
最後是計算精度。評測腳本現在固定關閉 TF32,改用完整 32 位元浮點運算。
官方發現,NVIDIA 的 PyTorch 容器預設開啟 TF32,會讓生成動作多出細小抖動,使腳滑數值高了約 0.3 到 0.4 公分每秒,所以重算了 v1.1 的表格。
這裡有個容易看錯的地方。模型卡說 v1.2 相較 v1.1 減少了腳滑,但倉庫重算後的表格顯示,v1.1 的總覽腳滑是 3.235,v1.2 是 3.331。
我推測模型卡比較的是重算前的舊數字,因為舊的 v1.1 比新表高 0.3 到 0.4,約是 3.5 到 3.6,確實高於 v1.2,不過官方沒有明說。
基準怎麼設計
基準共有 22,474 個測試案例,分成兩個切分。「新內容」測試的是訓練時沒出現過的動作類別,用來看文字泛化。「重複」測試的是見過的類別中沒看過的具體動作,主要看約束的跟隨能力。
指標有三類。動作品質看腳滑與腳接觸一致性,約束跟隨看全身關鍵幀、手腳末端與路徑的位置誤差,文字對齊則用 TMR 這個文字與動作對應模型當裁判,看生成動作能不能在候選裡對上原本的提示。
R@3 是前三名內命中的比例,愈高愈好。FID 衡量生成動作與真實動作的分布差距,愈低愈好。腳滑的單位是公分每秒,愈低愈好。
數字對照
下表取自官方文件的總覽提示結果,因為不同切分與提示類型很多,這裡只列最常被引用的一組,真值那列是動捕原檔在同一流程下的分數。真值取自 v1.2 的表,v1.1 表的真值是 89.09 與 94.03,官方說明,換 GPU 或軟體版本重新計算時,R@3 可能差到約 0.5。
| 模型 | 新內容 R@3 | 新內容 腳滑 | 重複 R@3 | 重複 腳滑 |
|---|---|---|---|---|
| 動捕真值 | 88.66 | 1.849 | 93.95 | 2.106 |
| SEED v1.1 | 81.13 | 3.703 | 91.05 | 4.238 |
| RP v1.1(含外洩) | 83.32 | 3.235 | 87.82 | 3.738 |
| RP v1.2 | 79.83 | 3.331 | 85.97 | 3.945 |
| RP ArdyRep v1.2 | 80.70 | 3.580 | 85.97 | 4.148 |
表中最明顯的是 RP v1.1 在新內容上從 83.32 降到 79.83,下降 3.5 點。模型卡說 v1.2 的文字對齊分數略低,「部分」反映移除外洩,但官方沒有量化外洩造成的差距,而且 v1.2 是重新訓練的模型,所以 3.5 點不能全算成外洩的影響。
另外,所有模型的腳滑都明顯高於真值 1.849,代表動作仍會有可見的滑步。
還有一點,公開資料訓練的 SEED v1.1 在重複切分上 R@3 是 91.05,高於 RP 系列。官方只說明重複切分的提示詞在訓練時已經見過,沒有解釋為什麼 SEED 版在這個切分分數較高。
另外要注意,ArdyRep 的根節點誤差不能與其他模型相比,因為它的真值以原始髖部為根,誤差定義為 0,其他模型的真值則以平滑根節點為目標。官方文件特別加了警語。
數字讀懂之後,就可以從一個很小的任務開始試用。
怎麼上手?從一個 5 秒動作開始
起步前先看硬體。官方說完全在 GPU 上生成約需 17GB 顯示記憶體,主要被文字編碼模型占用。若把環境變數 TEXT_ENCODER_DEVICE 設成 cpu,顯示記憶體可降到 3GB 以下,速度稍慢。
測試最多的是 RTX 3090、RTX 4090 與 A100,開發環境是 Linux,官方說 Windows 應該也能用,搭配 Docker 更穩妥。這個門檻對個人創作者偏高,但用 24GB 顯卡的人可以直接跑。
安裝完成後有兩條路。一條是互動示範,執行 kimodo_demo,在本機 7860 埠開啟網頁,可以在時間軸上排提示、放關鍵姿勢與路徑約束,並預覽、輸出。
另一條是命令列 kimodo_gen,可以指定模型、秒數、取樣數量、約束檔與隨機種子。預設輸出是自家 NPZ 格式,也可以輸出 BVH,G1 模型則可輸出 MuJoCo 的 CSV。
我建議的第一個任務很小:用預設的 v1.2 模型,生成 4 到 5 秒的走路動作,提示寫成「A person walks forward」,再加一個最終位置的 2D 路徑點。完成後匯入 Blender 看看有沒有滑步與穿地。
約束怎麼用
三種約束各有用途,下表整理官方文件的限制,用途欄是我的歸納。
| 約束類型 | 適合做什麼 | 官方提醒 |
|---|---|---|
| 全身關鍵幀 | 指定開頭與結尾姿勢,讓模型補中間動作 | 每種約束最好少於 20 個關鍵幀 |
| 手腳末端 | 讓手碰到某處、腳踩在某點 | 不要與文字提示互相矛盾 |
| 2D 路徑與路徑點 | 控制人物在地面上走哪條路 | 密集路徑不受 20 幀限制 |
如果文字與約束打架,可以調整分類器自由引導的權重,也就是文字與約束各占多大影響力。要讓腳接觸與約束命中更準,就要確認後處理有開啟,命令列預設是開啟的,可以用 --no-postprocess 關掉。
官方文件也有提示寫法的建議。提示最好用「A person」開頭,每段只描述一到兩個行為,細節程度要適中。太短像「A person walks」太模糊,太長又會讓模型分心。指令寫得出來之後,成果能不能拿去商用,要看授權怎麼規定。
延伸閱讀:Motion2MixamoRig 影片轉角色動作:Blender 工作流程、限制與授權一次看懂
授權與適用對象
授權要分三層看。程式碼採 Apache-2.0。多數模型權重採 NVIDIA Open Model License,SOMA-RP-v1.2 的模型卡明寫可商用。
SMPL-X 版本採 NVIDIA 研發模型授權,條款限定內部的研究開發與非量產環境,也不得用來產生販售的作品。
資料層則不同。Bones Rigplay 不公開,所以你無法重現訓練。BONES-SEED 有自己的授權,要自己下載才能建構完整基準,使用前要另外閱讀條款。
適合的對象有三種:想快速做動作原型的動畫與遊戲團隊、需要人形機器人示範資料的研究者,以及要比較動作模型的學術團隊。對最後一種人,v1.2 與 SEED 版是合適的比較基準。
不適合的是需要超過 10 秒連續動作、需要和場景物體精準互動,或需要卡通誇張動作的人。模型卡說它只生成寫實動作,也不知道場景裡有什麼物件。
限制與風險
官方「最佳實務」文件把限制寫得很直接。每個提示最長 10 秒,每種約束的受限幀數最好少於 20,約束互相矛盾時會出現瑕疵或被忽略。
訓練資料涵蓋的行為也有限,包括走跑、手勢、日常活動、常見物件互動、遊戲戰鬥、舞蹈與幾種風格。提示超出這些範圍,結果會變差,官方舉的例子是棒球打擊,因為沒有訓練過棒球資料。
多提示串接的轉場發生在第二段的開頭,所以第二段必須撥出一點時間做轉換,可能讓它的內容演不完整。另外腳滑雖有後處理可以修正,但後處理對 G1 機器人骨架效果不好。
還有偏見風險。模型卡提醒,模型可能重現年齡、性別或體型的刻板印象,建議提示盡量寫動作本身,例如怎麼走、怎麼動,而不是人口特徵。
最後是外部使用的風險。生成的動作如果拿去驅動真實機器人,要先經過物理模擬與安全檢查,因為運動學模型只描述姿勢怎麼變化,不計算受力與平衡,所以不保證動作在物理上可行。
Kimodo 常見問題
Kimodo 可以免費商用嗎?
程式碼是 Apache-2.0,SOMA-RP-v1.2 在 NVIDIA Open Model License 下,模型卡寫明可商用,但仍須遵守該授權條款。SMPL-X 版本是研發授權,BONES-SEED 資料集另有授權,使用前要逐項確認。
我該用 v1.1 還是 v1.2?
比較基準分數時用 v1.2,因為 v1.1 的 RP 模型訓練資料與測試資料有重疊。若只是做動畫原型,v1.2 已是預設模型,沒有特別理由退回 v1.1。
需要多強的顯卡才能跑?
官方說全 GPU 約需 17GB 顯示記憶體,把文字編碼放到 CPU 後可降到 3GB 以下。測試過的顯卡包含 RTX 3090、4090 與 A100,Windows 則官方說搭配 Docker 較穩妥。
它能從影片產生動作嗎?
不能,它從文字與約束生成骨架動作,不從影片抽取動作。若要把動作用在角色上,還需要匯入 Blender 這類軟體做綁定與渲染。
結語:先確認版本,再談動作品質
Kimodo 把文字、關鍵姿勢與路徑放進同一個模型,授權與工具鏈也相當完整,所以值得拿來當動作原型與機器人示範資料的起點之一。
這次 v1.2 更新的啟示更值得記住:基準分數要連同資料切分一起看。看到動作模型的成績時,先確認它有沒有見過考題,再決定要不要引用。想持續追蹤開源動作生成與機器人工具的更新,可免費訂閱 AI 郵報。
資料來源
- Kimodo 官方 GitHub 倉庫與 README:https://github.com/nv-tlabs/kimodo
- Kimodo 官方更新紀錄 CHANGELOG:https://github.com/nv-tlabs/kimodo/blob/main/CHANGELOG.md
- Kimodo 基準結果文件:https://github.com/nv-tlabs/kimodo/blob/main/docs/source/benchmark/results.md
- Kimodo 最佳實務與限制文件:https://github.com/nv-tlabs/kimodo/blob/main/docs/source/key_concepts/limitations.md
- NVIDIA Research Kimodo 專案頁:https://research.nvidia.com/labs/sil/projects/kimodo
- Kimodo-SOMA-RP-v1.2 官方模型卡:https://huggingface.co/nvidia/Kimodo-SOMA-RP-v1.2
- Kimodo 技術報告 arXiv:https://arxiv.org/abs/2603.15546
- X 貼文(熱度線索):https://x.com/HuggingPapers/status/2111927791742525492