SLA 空間動作模型發表,機器人如何在訓練時學會看懂位置變化?
SLA 以三維老師對齊機器人動作模型,解析共同動作表示、狀態隱藏、真機二十四個百分點的物件分母,以及各公開基準與歷史輸入條件。

機器人能認出水果,不代表水果被挪動時,手臂就知道應該改往哪裡伸。辨認物件和依位置調整動作,是兩個相接的問題。
SLA在2026年11月5日公開研究,把三維空間監督放進持續預訓練,也在後續特定任務訓練時保留這項要求。
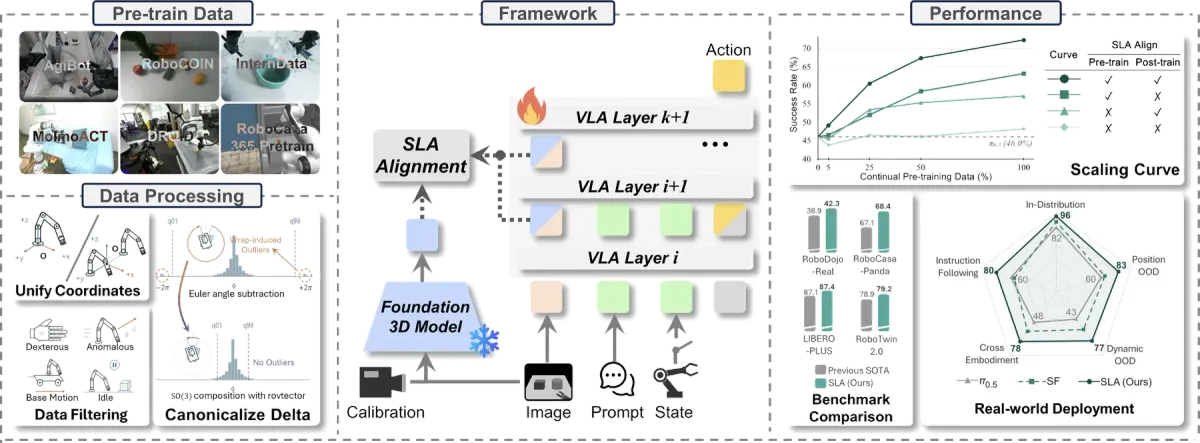
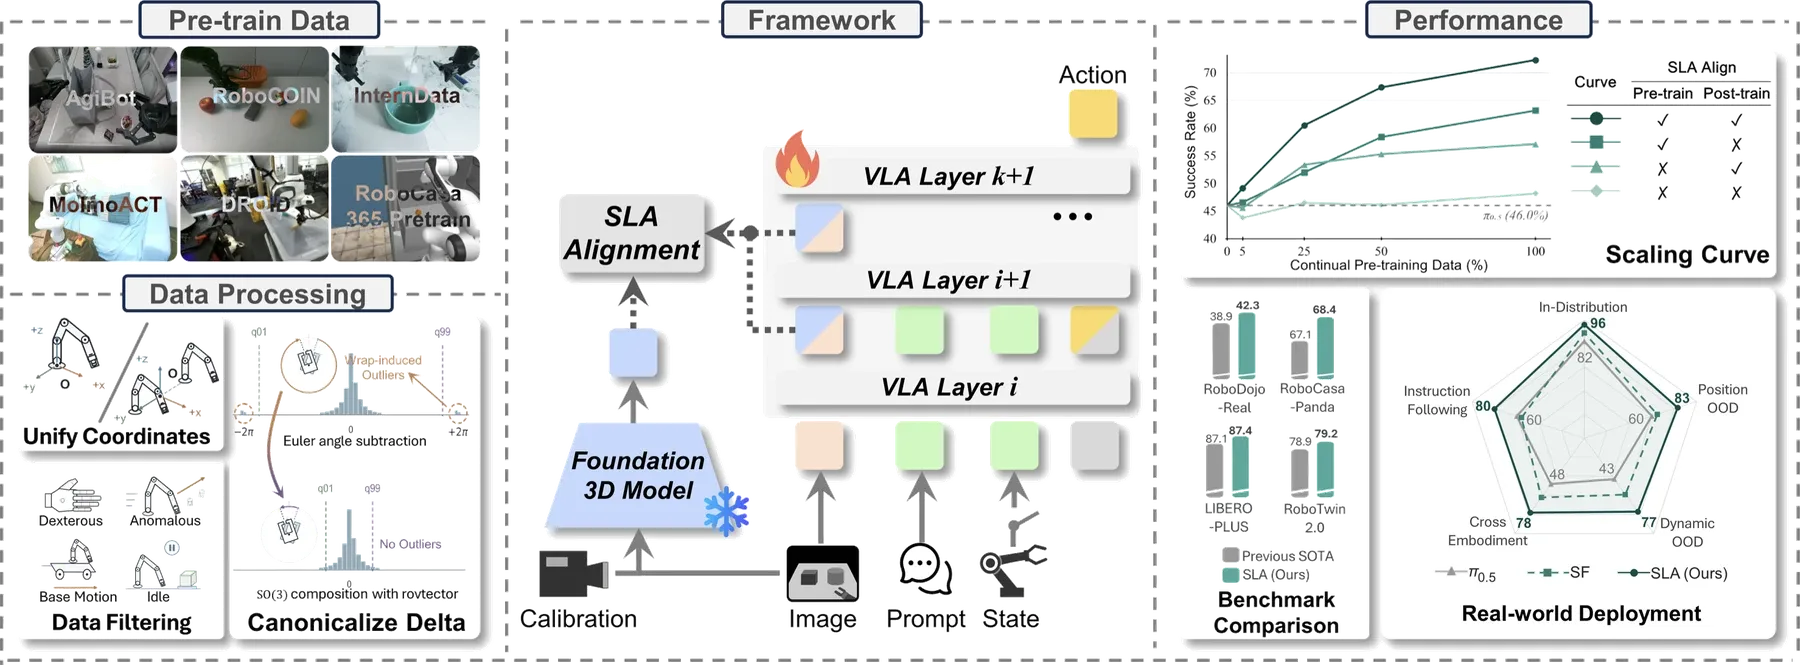
它從既有pi0.5動作模型出發,用外部三維老師引導內部視覺表示,讓模型學習動作時,也需要照顧畫面裡的空間關係。
這項對齊分支只在訓練時使用,部署時可以移除。但研究的部分設定另加歷史影像,不能把整份研究都概括成完全沒有額外輸入。
官方在八種真機條件下報告平均提高二十四個百分點,計分單位卻是每個物件的完整操作,並非一連串家務從頭做到尾的成功率。
我認為這份研究提供了改善視覺表示的具體路徑。它的價值需要和資料整理、擾動方式與部署輸入一起看,才能知道哪些進步能對應到實際動作。
先看三維老師教的是什麼,就能理解為何它可以在完成訓練後離開機器人。
SLA 如何在訓練時替動作模型補上空間關係?
外部三維老師引導模型內部的視覺表示,讓動作學習同時受到空間結構約束,模型便多了一種需要學好的目標。
依原始論文,SLA沿用pi0.5,再加入凍結的OmniVGGT三維模型。凍結代表老師的參數不隨這次訓練改動,動作模型則學著靠近老師提供的表示。
這裡的表示,是網路內部描述畫面的一組數值。團隊要求動作模型的中間視覺特徵,能對上三維老師的空間資訊,並非只在最後檢查手臂有沒有到達指定位置。
因此,學習訊號會回到看圖的過程。模型除了記住某個指令常搭配哪段動作,也要讓自己從圖片抽出的內容,保留能支持位置與幾何關係的資訊。
三維老師可以使用影像、深度或相機校正等資料。來源缺少某類標註時,研究以對應的空缺輸入處理,而非要求每份機器人資料都具有完全相同的感測紀錄。
不同網路層保留的資訊也不相同。團隊把十八層特徵放進可學習的融合方式,依影像位置與特徵通道調整權重,讓模型決定哪些部分適合對齊。
通道可以理解成特徵裡不同的描述面向。這種安排避免只挑固定一層,把所有圖片和任務都交給同一種表示,而是讓融合方式隨訓練調整。
完成訓練後,三維老師、特徵投影與融合模組都可移除。留在動作模型裡的是訓練造成的改變,所以對齊分支本身不需要每次操作時重新執行。
不過,老師提供共同目標之前,各來源記下的動作仍要能彼此對照。否則,同樣的數字可能在不同機器人上代表不同方向。
SLA: Scaling Spatial-Language-Action Model via Continual Pre-training Real-robot
— 文轩 宋 (@wenxuansong_1) November 8, 2026
SLA exhibits robust performance and error-correction capabilities in continuous task execution. The system continues to function effectively on physical hardware. Both the code and model weights are… pic.twitter.com/L5jxI1Eg5X
不同機器人的資料,怎麼整理成共同訓練?
團隊先統一夾爪位置與旋轉的表示,再篩除不適合設定的軌跡,讓資料增加時,模型學到的動作含義保持一致。
六個來源在篩選前,共有約171.39萬段紀錄、14,330小時與1,504種任務。這描述的是來源規模,並非最後完整投入訓練的時數。
實際整理會按不同來源調整取樣比例,也會移除長時間不動、速度不合條件或動作型態不相容的內容。研究聚焦兩指夾爪,沒有把靈巧手與移動底座的動作全部混用。
取樣讓資料數量較大的來源不至於只靠份量主導訓練,篩選則把學習目標收在相容的操作範圍。這兩件事都會改變最後真正用到的資料,不能用原始總時數代替。
在動作表示上,模型觀察的是夾爪在共同座標中的位置,輸出的則是相對目前姿態的一段變化。共同座標就是大家用相同方向與原點描述位置,方便不同資料互相比較。
單臂以基座作為共同參考,雙臂則使用兩臂中點等一致方式。這讓左邊、前方與高度的數值有共同依據,也使同一段相對移動不必隨資料來源重新猜測含義。
旋轉還有另一個難題。角度繞過邊界時,數字可能突然跳動,但實際方向只改了一點。研究用三維旋轉的組合處理相對變化,避免把這種數字跳躍當成大動作。
論文比較不同旋轉表示後,旋轉向量較有利。不過,四種表示都使用同一套三維旋轉組合,所以這份比較主要支持表示方式的選擇,不能單獨證明所有收益都來自某個相減公式。
持續預訓練使用四十八張H100,三萬六千步約需一百一十小時。後續各基準仍有各自的任務訓練,因此這不是整份研究所有運算只花一百一十小時。
資料能一起讀,還不代表模型會確實看圖。若目前姿態已足以猜出熟悉動作,它仍可能走一條較容易的學習路徑。
為什麼要偶爾拿掉機器人狀態?
訓練時暫時隱藏狀態輸入,是要減少模型只依熟悉姿態重播軌跡的捷徑,讓畫面對動作決定更有影響。
機器人的狀態包括當下姿態等數值。研究按機率把一份樣本的整段狀態輸入拿掉,同時保留影像與語言指令,要求模型仍然學習下一段動作。
這不代表部署後機器人失去姿態資訊。正常推論時,狀態會放回來,隨機隱藏是訓練方法,目的在於改變模型依賴不同資訊的程度。
RoboTwin測試顯示,隱藏比例不是越高越好。完全不隱藏時平均38.1%,隱藏四分之一樣本時為79.2%,全部隱藏則是56.7%。
這個結果支持保留一部分狀態、又不讓模型永遠依賴它的取捨。完全拿掉雖然減少捷徑,也同時移除有助控制的資訊,因此不能只用「看圖更多」解釋所有改變。
空間對齊和資料增加也有相互關係。當對齊同時放在預訓練與後續任務訓練,資料比例從5%增加到全部,相關測試成績由49.2提高至72.3。
兩階段都不使用對齊時,同樣資料比例的結果則由43.8到48.2,中間也不是一路增加。這顯示更多資料能否轉成收益,和模型怎麼學習空間資訊有關。
因此,研究主張的不是只要收集更多影片就會變好。資料、共同動作表示與對齊目標一起改變學習條件,消融比較才有辦法逐一檢查它們的作用。
延伸閱讀:AIRoA-0 開放模型與程式碼,手持夾爪資料如何教會雙臂機器人?
二十四個百分點,涵蓋哪些真機測試?
八種條件測的是各個物件能否完成指定操作,改變物件位置、外觀或機器人後的結果,都需要沿著各自訓練設定理解。
這組平均為83.8%,對照模型59.8%,相減得到二十四個百分點。它不是在原分數上相對增加24%,更不是所有場景都各自增加相同幅度。
每個條件評估五十個物件實例,但安排不完全相同。有些條件做十次操作,每次含五個物件,其他條件則做五十次單物件操作。
因此,一輪裡五件物品全完成,和其中四件完成,會在物件層級留下不同結果。平均物件成功率不能直接改寫成整輪任務成功率,兩者的分母不同。
訓練配置也決定哪些可稱為泛化。一組使用一百段Piper示範訓練,再沿用同一個策略測其他條件,這能觀察換位置或情境後是否還能操作。
但跨到Franka機器人的條件,另外加入十段示範。因此,這個結果不是完全沒看過新機器人資料,就直接成功轉移的零樣本證據。
另一組使用一百段任務示範,再測其他擾動。黑膠帶與紅蘿蔔在其中的下游訓練範例裡沒有出現,不等於研究證明它們從未出現在所有預訓練資料中。
若比較對象沒有採用相同任務示範與擾動安排,即使也叫成功率,差距仍可能同時反映訓練資料與測試難度。先固定條件,才能更接近方法本身造成的改變。
這些差異不會抹去真機結果的用途,反而讓讀者知道進步出現在哪裡。模型接受哪些示範、測試時改動什麼,才是把平均數接回實際能力的線索。
公開基準與部署條件,還留下哪些差異?
不同基準各自訓練與計分,分項結果能補足私有測試,卻不能把最高分合併成所有環境的一個總成功率。
LIBERO-Plus進行10,030次測試,依權重計算成功率為87.4%,對照為84.4%。這是對應任務與擾動集合的結果,不是機器人所有動作的整體正確率。
RoboTwin含五十項任務,每項提供五十段乾淨示範。在乾淨條件及隨機條件各做一百次測試,兩者分別為86.0%與72.3%,平均79.2%。
RoboCasa則是二十四項任務,每項五十次,配合三個隨機種子,共3,600次,成功率68.4%。隨機種子改變實驗中的抽樣安排,讓測量不只依靠一組起始條件。
RoboDojo-Real涵蓋十八項任務與三種機器人形態,還同時報告進度分數42.3和完整成功率33.9%。部分完成能拿到進度分,不能把42.3說成所有任務的完整成功比例。
拿掉三維老師,就代表部署只看一張圖嗎?
不代表。RoboDojo設定另加入九張歷史影像,包括初始影像與前八秒每秒一張,讓模型有機會知道先前發生過什麼,當前視角則另行輸入。
例如物件一度被夾爪遮住,單看當前畫面可能缺少先前操作的線索。歷史影像提供的是時間上的資訊,三維對齊則約束空間表示,兩者解決的問題並不相同。這是依輸入設計可以理解的分工。
這些歷史影像在部署時仍會使用。因此,「對齊分支沒有新增推論成本」只描述拿掉老師的那條分支,不能連歷史輸入與其他設定的成本也一起省略。
研究頁列出程式與模型的釋出資訊,但本文沒有驗證程式與權重是否可實際下載使用。可核對的性能證據來自公開論文與頁面,取得材料的條件仍應和實驗結果分開。
對研究團隊而言,這份公開方法足以提出可重現的問題。要比較的應是同一套資料與任務裡,加入對齊、狀態隱藏或歷史輸入後,各自改變了什麼。
延伸閱讀:RoboColosseum 實機評測公開,一萬五千次測試如何比較機器人能力?
SLA 常見問題 FAQ
14,330小時都用進最後訓練了嗎?
這是篩選前六個來源的合計規模。團隊還會調整取樣比例,移除閒置、速度不合或動作型態不相容的軌跡,不能把原始時數當成最後訓練時數。
二十四個百分點是整輪家務成功率嗎?
這是八種真機條件的平均物件操作成功率差值。部分條件一次包含多個物件,所以它和所有步驟都完成的整輪成功率不同。
訓練時拿掉狀態,部署也要拿掉嗎?
正常部署會保留狀態。隨機隱藏發生在訓練,用來減少模型只依賴熟悉姿態的傾向,並不要求機器人執行時放棄自身狀態資訊。
結論
SLA把機器人操作的問題往看圖過程推進了一步。模型不只學哪個動作接在哪個指令後面,也被要求把有用的空間結構留在內部表示中。
若你研究的是移位、外觀或跨機器人的變化,可先沿論文分開比較共同動作表示、對齊階段和狀態隱藏,再使用相同分母讀結果。這比只保留二十四個百分點,更能找到值得重現的改變。