vLLM 合併 Kimi K3 專用解碼:官方稱 GB300 快 1.5 到 2 倍,423 tok/s 怎麼核對
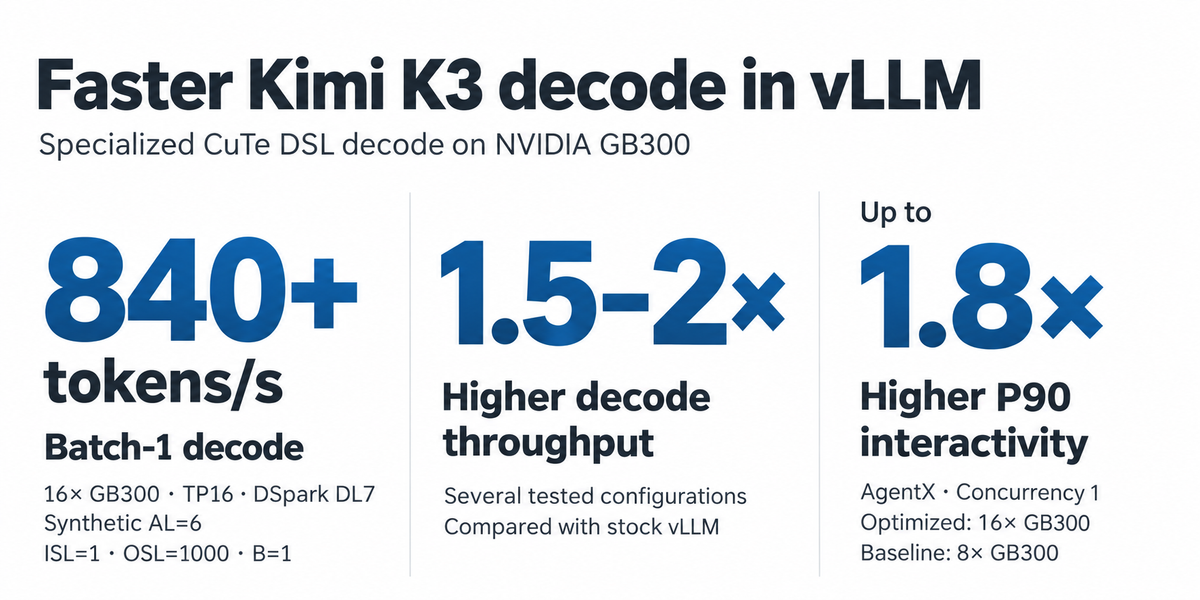
vLLM 在 2026 年 10 月 16 日合併 NVIDIA 工程師提交的 Kimi K3 專用解碼路徑,官方稱 GB300 在數個測試組態中解碼快 1.5 到 2 倍。本文拆解 842 tok/s、1.73 倍與 AgentX 數據的測量條件,並對照 X 上 423 tok/s、1.68 倍的說法。

2.8 兆參數的 Kimi K3 要讓使用者覺得「回得快」,靠的不只是更大的 GPU,還有伺服器軟體把每一步算得多緊。
2026 年 10 月 16 日,NVIDIA 工程師 Benjamin Chislett 提交的專用解碼路徑,合併進了開源推論引擎 vLLM。
這個變更新增約 12,800 行程式、改動 50 個檔案,目標很單純:在 NVIDIA 最新的 GB300 上,把 Kimi K3 逐字產生答案的速度再往上推。GB300 是 NVIDIA 資料中心用的 Blackwell 世代 GPU。
台灣時間 10 月 18 日上午,研究機構 SemiAnalysis 的 X 帳號發文,說這項優化讓 Kimi K3 在同一套硬體上達到每位使用者每秒 423 個 token,是原本的 1.68 倍。
token 是模型處理文字的單位。查詢時這則貼文有 2,192 個讚、約 18 萬次瀏覽。
我讀了 vLLM 官方文章與合併的 PR,找不到 423 這個數字,1.68 倍也只出現在 PR 的一個細項表格裡,意思不同。
但官方寫的是批次 1 可達 842 tok/s、快 1.73 倍,另有 AgentX 工作負載的 403.2 對 223.7 tok/s,兩者都附有條件。
這些條件決定數字能不能搬到別的環境用。所以這篇的重點,是把官方數字、它的前提,以及貼文數字可能對應到什麼,一項一項對起來。
我的判斷是,自己管理 GB300 機櫃、或在評估這個模型供應商的團隊值得讀完;只有個人電腦或單張顯卡的人,現階段不會從這項改動直接受益。
要判斷這些數字,先看 NVIDIA 這次到底改了 vLLM 的哪一段。
Kimi K3 專用解碼路徑改了什麼
這次改的是解碼階段,也就是模型讀完提示後,一個 token 一個 token 往外寫的那一段。依 vLLM 官方文章,團隊把解碼路徑上幾乎所有運算,換成用 NVIDIA 的 CuTe DSL 寫的客製化 GPU 核心。
Kimi K3 是 Moonshot AI 的 2.8 兆參數混合專家模型,也就是把網路拆成很多專家、每次只啟用一小部分的設計。
它每個 token 只啟用 896 個專家中的 16 個,支援 100 萬 token 上下文與原生視覺。權重在 2026 年 7 月 27 日公開,vLLM 當天就提供了支援。
新路徑以 NVIDIA Blackwell 的 GB300 為對象,使用 8 或 16 張 GPU,解碼批次從 1 到 64,並支援把長上下文的 KV 快取切到多張卡上的 DCP。KV 快取是模型為了不重算前文而保存的中間結果。
這些 GPU 要處在同一個 NVLink 域,也就是用 NVIDIA 的高速互連串成一組。
官方把優化分成四類:依批次大小挑選不同的矩陣運算核心、讓計算與卡間通訊重疊、重排專家運算的排程,以及在等通訊時預先把下一步要用的權重搬進快取。
這些動作的效果可以用一張圖看出來。官方的核心時間線顯示,原版 vLLM 每層用 23 個核心、約 130 微秒,專用路徑只要 13 個核心、約 69 微秒。
它是選用功能,需要在啟動設定加入 decode_backend 為 latency_specialized 的參數,而且官方說所有改動都放在 Kimi K3 專屬的目錄,不影響其他模型。
其實這個專案還有一個值得知道的背景:官方文章直接寫,他們用編寫程式的 AI 代理協助開發這條路徑。PR 說明則註明描述由人工撰寫,也勾選了有使用 AI 輔助。至於速度到底提升多少,得看官方列出的三組數字。
延伸閱讀:Kimi K3 開放權重下載:2.8 兆參數、100 萬 Token,真的能在本機執行嗎?
Kimi K3 的 842 tok/s 與 1.5 到 2 倍從哪來
官方數字分成三組,每一組的條件都不同,所以不能混著讀。第一組是不使用推測解碼的純解碼,下表是官方文章的數字,單位是這組 GPU 合計每秒產生的 token 數。
| 批次大小 | 8 張 GPU | 加速倍數 | 16 張 GPU | 加速倍數 |
|---|---|---|---|---|
| 1 | 193.3 | 1.58 | 256.4 | 1.88 |
| 8 | 820.1 | 1.45 | 1,157.9 | 1.79 |
| 16 | 1,274.8 | 1.43 | 1,758.3 | 1.71 |
| 64 | 2,375.9 | 1.31 | 3,606.1 | 1.62 |
這張表的規律很清楚:批次愈小,加速愈大。官方說明,小批次推論常受限於從記憶體讀權重的速度,專用核心與提前搬運權重正好針對這一點,批次拉大後,運算本身愈來愈吃緊,倍數就降到 1.3 到 1.6。
第二組是使用推測解碼。推測解碼是讓一個輕量的草稿模型先猜好幾個 token,再由主模型一次驗證,猜對的就直接收下。Kimi K3 用的是 Inferact 公開的 DSpark 草稿模型,每次猜 7 個。
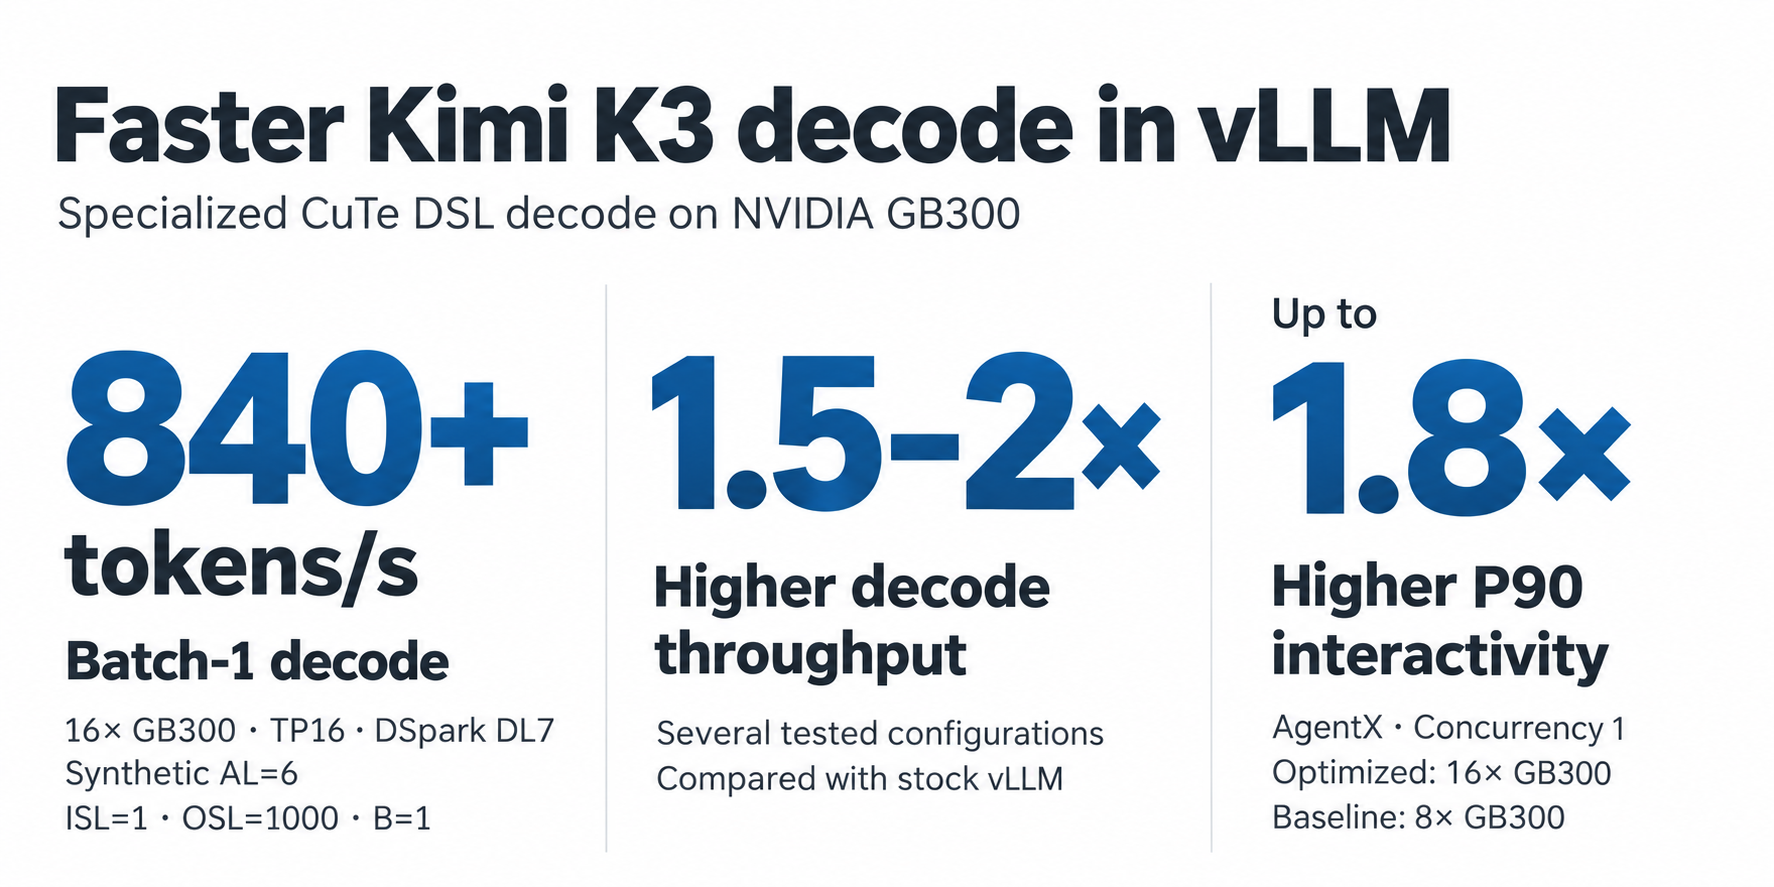
官方的標題數字就出在這一組。條件是 16 張 GB300、DSpark、批次 1、輸入 1 個 token、輸出 1,000 個 token,並假設平均每步接受 6 個 token。
在這個條件下,專用路徑是 842 tok/s,原版 vLLM 是 488,快 1.73 倍。
但 PR 說明裡的表格略有不同,批次 1 是 838 對 489,快 1.71 倍,批次 8 是 3,094 對 2,014,快 1.54 倍。兩份文件的小數差異,官方沒有說明原因。
這裡有一個要小心的字眼:合成接受長度。接受長度是平均每一步驗證能收下幾個 token,這組測試直接設定為 6,沒有用真實文字量測。
但真實文字的接受長度會因任務而異。官方在 32k 長上下文測試中也是設定值,採用 3.78,結果列在下面。
第三組是 32k 輸入、DSpark、開啟 DCP,每步接受 3.78 個 token,使用 SPEED-Bench 的混合提示。
| 設定 | 批次 1,專用/原版 | 批次 8,專用/原版 |
|---|---|---|
| 8 張 GPU | 374/249,1.50 倍 | 1,233/904,1.36 倍 |
| 16 張 GPU | 483/276,1.75 倍 | 1,667/1,088,1.53 倍 |
官方標題寫的 1.5 到 2 倍,只涵蓋其中數個組態。表中實際從 1.31 倍到 1.92 倍都有,8 張卡批次 64 只剩 1.31 倍,16 張卡批次 2 最高到 1.92 倍。
423 tok/s 與 1.68 倍為何對不上官方數字
貼文的 423 在 vLLM 官方文章與 PR 說明裡都沒有出現,1.68 倍只在 PR 細項表出現過一次,指的是 8 張卡、每次猜 3 個草稿 token、輸入 8k 時驗證步驟的加速,與貼文說的整體速度不是同一件事。
同一則消息的中文轉述提到 megakernel 約 1.2 萬行程式,與 PR 的 12,805 行新增量級相符,作者是 NVIDIA 工程師也相符。
貼文還把團隊標成 NVIDIA CentML,官方文章只在作者名後標註 NVIDIA,所以這一點我無法確認。
至於 423 與 1.68 倍,可能來自 SemiAnalysis 自己的測量,也可能是對官方數字的換算,貼文沒有附出處,我只能列為 X 貼文宣稱。
最接近的官方數字是 AgentX 的結果。AgentX 是 SemiAnalysis 設計的基準,依 393 段真實 Claude Code 工作階段重建流量,內容換成合成文字,只保留長度、前綴重用、子代理與時間。
這些工作階段每個請求的輸入中位數約 14.2 萬 token,44% 的工作階段含子代理,所以它比單人短問答更接近寫程式代理的負載。
官方的 AgentX 結果是併發 1 時的 P90 互動性,單位是每位使用者每秒 token 數,官方文章沒有再展開定義,所以我只引用數字。
專用路徑為 403.2,原版 223.7,快 1.8 倍。403.2 與貼文的 423 差了約 5%,但都是「每位使用者每秒」的口徑,是最可能的對應。
但官方文章明白寫了一個條件:這個比較是 16 張 GB300 的優化結果,對上 8 張 GB300 的舊 vLLM 結果。也就是說,1.8 倍包含了 GPU 數量加倍的效果,並不是同一套硬體。
因為 GPU 加倍本身也會加速,所以可以用官方表格估算它值多少。純解碼批次 1 的優化版在 8 張卡是 193.3,16 張卡是 256.4,倍數分別是 1.58 與 1.88,倒推原版約為 122 與 136。
這代表在純解碼批次 1,原版從 8 張卡換成 16 張卡只快約一成。如果 AgentX 的情況類似,1.8 倍裡仍有相當一部分來自軟體優化,但這是我用另一個基準做的推估,官方沒有拆開,而貼文說的「同一套硬體」也就不精確。
綜合起來,讀到 423 這種「每位使用者」的數字時,至少要確認五件事:用幾張 GPU、批次多大、有沒有推測解碼、接受長度是假設還是實測,以及工作負載是合成輸入,還是依真實工作階段重建的流量。數字能不能信,還有另一半要看:這些核心是 AI 代理寫的,官方怎麼確認它沒寫錯。
延伸閱讀:NVIDIA AIPerf 是什麼?看懂 AI 推論延遲、吞吐量與多人使用效能
AI 寫的 GPU 核心,vLLM 怎麼驗證正確
這篇官方文章有相當篇幅不談速度,談的是怎麼把 AI 代理寫的高風險程式放進開源專案。文章直接說,代理優化出來的推論程式,產出速度已經超過人工審查與維護的能力。
vLLM 的答案是把風險關在盒子裡。優化只放在模型自己的程式目錄,不碰輸入準備、取樣與 KV 快取管理這些大家共用的元件,所以審查者只需要看一個範圍。
範圍可以窄,但功能不能少。專用路徑只支援 GB300 的指定組態,不過全上下文服務、溫度取樣與結構化輸出這些使用者必要的功能,不能被「優化掉」。
邊界守住之後,還得證明答案沒有變。PR 的結果顯示,AIME25、GPQA-Diamond 與 MRCR v2 的分數與原版相比,差距在約一個標準誤差內,不論有沒有推測解碼。
驗證過程也找到了問題。官方說審查時發現,編譯器把讀取啟動值的動作移到了同步等待之前,修正方式是只對靜態權重保留這種讀取。
另外,長上下文與長輸出的評測發現了數值敏感的問題,這些問題在用假輸入、固定啟動時間的單獨核心測試裡沒有重現。這正是只做核心測試不夠的原因。
最後,效能要看全局。官方要求掃過不同批次、上下文長度與平行設定,專家模型還要用真實提示測試,因為不同提示會選到不同專家。
官方同時透露了後續。DeepSeek-V4.1-Flash 的 PR #61868 沿用同一套設計。
Meta 的 Muse Spark Open 在釋出兩天後,初步結果超過每位使用者每秒 950 個 token,同樣假設每步接受 6 個 token。GLM5.3 的低併發優化也會在後續文章說明。這些路徑都限定特定硬體與模型,能不能用得上,要看你的組態是否在範圍內。
誰會受益?導入前怎麼評估
最直接受益的是自己管理 GB300 的團隊,以及提供 Kimi K3 服務的雲端業者。他們可以在啟動設定加入選用參數,並用自己的流量重跑基準,因為官方只涵蓋指定組態。
間接受益的是這個模型的 API 使用者。如果服務商採用這條路徑,單人互動的速度可能提升,但官方沒有說哪些供應商已採用,所以要看供應商自己的公告與實測。
不適合的是只有消費級顯卡的人。它的 vLLM 快速開始是 8 張 B300 或 8 張 AMD MI355X,這已經是資料中心等級,這次的專用路徑又限定 GB300,與個人電腦沒有關係。
如果你要評估,先確認硬體型號與 GPU 數量是否在支援範圍內,因為官方只驗證 GB300 的 8 或 16 張卡。
接著照前面那份清單核對批次大小、推測解碼與接受長度,批次愈大,倍數愈低。最後用自己的真實任務重測首個 token 時間、每位使用者速度與正確率,如果只看官方標題數字,就容易高估效果。
限制與風險
最大的限制是適用範圍窄。專用路徑只支援 GB300,使用 8 或 16 張 GPU,批次上限 64,預填階段與混合批次會回到原本的實作,所以它改善的是純解碼階段的速度,預填與混合負載不在範圍內。
其次是 842 這個標題數字依賴假設。合成接受長度 6,比官方在 32k 測試用的 3.78 高很多,所以 842 比較像理想條件下的數字,不是日常會看到的速度。
PR 自己也留了一個未解的疑點。MRCR 在輸出上限 32k 時,專用版被截斷的情況比原版稍多,PR 說原因不明,上限放寬到 64k 後,兩者的截斷與平均輸出長度就相近了。
再來是比較口徑。AgentX 的 1.8 倍包含 8 張與 16 張卡的差異,純核心優化的倍數要看批次表。引用「快 1.8 倍」時,如果沒有交代這點,就容易高估單純軟體優化的效果。
使用者感受到的等待有兩段:第一個 token 出現之前讀提示的時間,以及之後逐字產生的速度。但這次只改善後者。
當提示很長,例如 AgentX 的輸入中位數約 14.2 萬 token,讀提示可能占掉不少等待,所以整體體感的提升,會比解碼倍數小。這是我依解碼與預填的分工做的推論,官方沒有量化。
最後,這項改動的審查程序還在演進。vLLM 自己也說,快速通道的規則仍是提案,GPU 驗證要靠社群提供算力,所以維護成本與穩定性,要觀察後續版本的修正頻率。
Kimi K3 與 vLLM 優化常見問題
Kimi K3 在 vLLM 上現在能快多少?
官方在批次 1、16 張 GB300、使用 DSpark 並假設接受長度 6 時,量到 842 tok/s,比原版快 1.73 倍。不用推測解碼時,16 張卡批次 1 約 256 tok/s,各組態的加速是 1.3 到 1.9 倍。
X 上的 423 tok/s 是真的嗎?
我沒有找到官方文章或 PR 的對應數字,只能視為貼文宣稱。最接近的官方數字是 AgentX 併發 1 時的 403.2 tok/s,但那個比較用了不同的 GPU 數量。
我自己的 GPU 能用這個優化嗎?
目前不行。官方只驗證 GB300,使用 8 或 16 張 GPU,要用 latency_specialized 參數啟用,其他顯卡與其他模型不在範圍內。
速度變快後,答案品質有改變嗎?
官方在 AIME25、GPQA-Diamond 與 MRCR v2 的結果與原版差距在約一個標準誤差內。這是 PR 作者自己的測試,要用在正式服務時,還是要用自己的任務再驗證。
結語:看 tok/s 要先問誰、幾張卡、什麼工作
這次 vLLM 的更新顯示,在官方指定的組態下,同一代 GPU 換一套更貼身的軟體,解碼速度能快 1.3 到 1.9 倍。官方文章把測量條件列得相當完整,只是對照組的 GPU 數量與版本,還是要自己看清楚。
X 上的 423 與 1.68 倍,則提醒我們傳播中的數字常常脫離條件。遇到這類消息,先問用了幾張 GPU、批次多大、有沒有推測解碼,再決定要不要相信標題。
想持續追蹤開源推論引擎與大型模型的效能消息,可免費訂閱 AI 郵報。
資料來源
- vLLM 官方部落格 Hyper Optimizing Kimi K3 in vLLM:https://vllm.ai/blog/2026-10-16-kimi-k3-megakernel
- vLLM PR 61867 Kimi K3 Specialized Decode:https://github.com/vllm-project/vllm/pull/61867
- vLLM 官方部落格 Kimi K3 Day-0 支援:https://vllm.ai/blog/2026-07-27-k3
- SemiAnalysis InferenceX AgentX 方法說明:https://inferencex.semianalysis.com/agentx
- X 貼文(熱度線索):https://x.com/SemiAnalysis_/status/2111627094878790023